作者|桦林舞王
编辑|靖宇
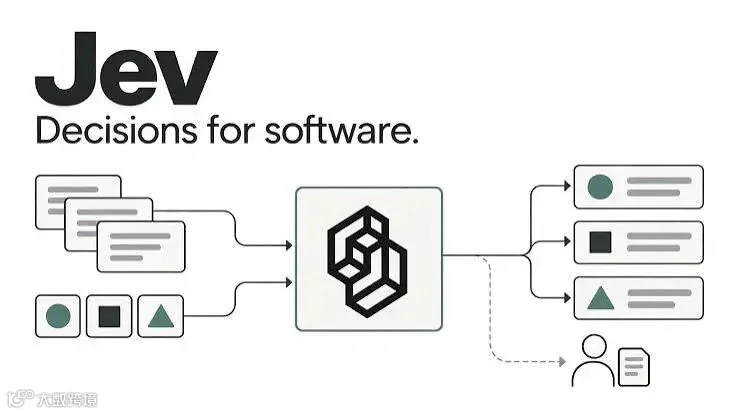
9月15日,前OpenAI研究员Diogo Almeida创办的TypeSafe AI发布Jev模型。该模型不生成文本,仅做判断。两周后,行业迅速跟进:OpenAI推出Decisions API,Cloudflare开源Clef,亚马逊发布Strands Decider。
国内方面,上海人工智能实验室开源多模态决策模型Intern-Decision。9月30日,成立不足五个月的上海公司StartLux(原点星辉)发布开源模型StartLux-Decision,宣称在公开评测中超越Jev。
新品类在两周内从“首发”走向“群战”,速度罕见。StartLux背后的掌舵人,是盛大网络联合创始人陈大年。
被Jev点燃的「直觉」经济
要理解这轮热潮,需明确决策模型的定位。TypeSafe将Jev称为“System One模型”,源自卡尼曼《思考,快与慢》中的系统一(快速、直觉思维)。过去两年大模型主要卷“系统二”(深度推理),但在Agent实际运行中,密集发生的是大量琐碎判断,如工单分配、命令放行、页面操作等。
以往这些判断要么由大模型生成文字后解析(慢且贵),要么写死规则(覆盖不全)。Jev仅回答带预设选项的问题(单选、打分、是非题),直接返回结构化概率结果,定价极低(每百万输入token 0.042美元,输出免费)。
Jev将“判断”从“生成”中剥离,成为廉价、高频的基础设施。
Vercel数据显示,Jev上线24小时内,其AI Gateway上13%的付费用户开始使用。但Jev作为闭源托管模型,无法本地部署,这一缺口成为了后来者的机会。
中国团队迅速跟进,主打开源与本地化
国内团队迅速响应。上海人工智能实验室的Intern-Decision提供0.8B至4B三档规格,主打多模态,推理速度比Jev快2到3倍。StartUX则提供0.8B至27B五档规格,配齐量化文件,直指本地部署。

据StartLux数据,其27B版本在Decision Index 0.2.1的38项测试中,31项高于Jev 1.13,综合分63.88对57.91。此外,团队还展示了国际象棋对弈成果。需注意的是,这些数据基于自测,且“第一”的保质期极短,Cloudflare随后宣称其Clef在同一榜单领先。
相比排名,更值得关注的是中国团队一致选择开源和本地化。
Jev的闭源云端模式对数据敏感及有跨境顾虑的国内开发者构成门槛。开源权重、支持本地运行恰好填补了这一空白。此外,Cloudflare的Clef、亚马逊的Strands Decider均基于Qwen后训练或做底座,显示中国开源基座已成为全球玩家共用的基础。
为何押注「本地」场景
StartLux成立于今年,CEO为陈大年(盛大网络联合创始人、WiFi万能钥匙创始人),CTO为郭权玮博士。公司定位“主打本地模型”,让模型能力和数据保留在用户设备上。
此前,以Qwen3.6-27B为基座的StartLux-27B在中国信通院M专项测试中得分39.25,超过DeepSeek-V4-Flash。需注意,这是聚焦工具调用的专项测试。StartUX规划的“本地AI”是一套个人AI系统:27B模型承担通用能力,决策模型负责高频判断,上层为Agent和记忆,底层为量化与推理系统。
在本地场景中,决策模型意义更大。个人电脑显存、内存和功耗有限,若每个小判断都动用大模型,本地Agent难以运行。StartLux数据显示,4B版本经Q4量化后约2.71GB,与原始权重决策一致率仍达98.3%。
对押注本地的公司而言,决策模型不是追热点,而是本地系统能否运行的关键零件。
Jev证明了“将智能分层、各司其职”的路径获市场认可,这与StartLux的本地架构逻辑契合。StartLux声称3天完成开发,归功于Auto Research体系,其复用能力比单次榜单成绩更能体现公司实力。
判断层会否沦为「白菜价」
决策模型的护城河尚浅。Jev研发两年,OpenAI两周推出API,StartLux三天跟进,大厂半个月内集体入场。两周即可复制的品类难以形成壁垒,Jev最终可能面临与大厂自有模型的价格战。
对StartLux而言,真正的挑战在于长任务稳定性、异常恢复、上下文管理及整体体验。按计划,其首个面向公众的本地智能体验版本有望年内推出。
陈大年过往产品多为高频、底层、规模取胜型。当“判断”变得廉价,价值将更多体现在如何将模型组装成优质产品的人手中。
*头图来源:TowardsAI
本文为极客公园原创文章