

DeepSeek与华为联手:AI重构芯片生态壁垒
近期,AI领域备受关注的动态莫过于DeepSeek与华为的深度合作。9月30日,双方宣布围绕昇腾AI芯片开源一系列编程基础设施,包括计算库、通信库,并推进基于128颗昇腾950的Supernode(超节点)方案。其中,旨在简化AI芯片编程的高层语言TileLang尤为引人注目。
业界有观点认为“英伟达最担心的事发生了,华为即将攻破CUDA生态”。然而,深入分析可见,这并非简单的国产替代故事,而是AI时代产业范式加速演变的缩影:AI技术正在降低追赶旧壁垒的成本,同时将竞争推向超节点、AI工厂及更完整的产业生态维度。
DeepSeek为何下场助力华为软件生态?
AI芯片的高效运行依赖于多层软件栈的支持。DeepSeek此次开放的基础设施主要解决以下核心问题:
填补计算与通信的软件鸿沟
首先,硬件性能释放依赖高度优化的Kernel(计算内核)。普通代码往往仅能发挥芯片一半性能,而针对矩阵乘法、Attention、量化及MoE路由等基础操作进行深度优化的Kernel,可将硬件利用率提升至八九成以上。DeepSeek开放计算库,意在弥补这一巨大的“软件差距”。
其次,大模型训练与推理需要海量数据在成百上千张芯片间交换。若通信库优化不足,多卡集群将如同“互相堵车的小岛”。DeepSeek开放通信库并联合华为推进128颗昇腾950组成的Supernode方案,正是为了解决“一群芯片如何协同工作”的问题。

TileLang:抽象底层复杂度的关键
CUDA的壁垒在于英伟达近二十年来构建的成熟软件栈。DeepSeek推出的TileLang试图进一步抽象化:开发者只需描述计算逻辑和数据关系,编译器即可将其翻译为适配不同硬件的底层实现。目前,TileLang已支持CUDA、ROCm、Metal等后端,并针对华为昇腾推出了TileLang-Ascend适配。
此外,DeepSeek基于TileLang开源了包含MoE路由、量化等高性能算子的TileKernels库。这表明角色正在发生转变:过去是模型公司适配芯片,如今模型公司凭借对真实负载的理解,反向参与定义下一代芯片的使用方式。
AI成为瓦解CUDA壁垒的新利器
利用AI开发“运行AI的软件”,已成为全球芯片行业的共同趋势,不仅限于中国。
AMD的智能体迁移策略
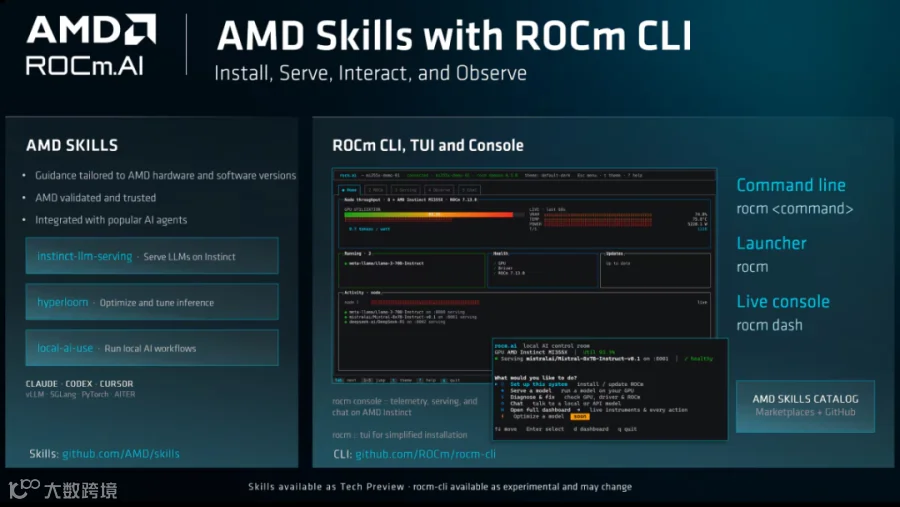
AMD正将Agent引入软件生态构建流程。其MOAT工具可调动多个智能体自动阅读、迁移、审查和测试CUDA项目。新推出的ROCm.AI开发环境允许Claude、Codex等AI助手直接调用技能,协助开发者部署模型及优化性能。Anthropic与AMD的合作协议中更明确提到,Claude将协助优化GPU工作负载,加速ROCm开发。
行业通用的抽象化趋势
Modular通过Mojo语言和MAX平台,致力于屏蔽不同芯片间的差异;OpenAI的Triton框架也朝此方向演进,甚至英伟达自身也为Triton提供CUDA后端支持。Google发布的JAXBench基准,更是专门测试AI Agent自主优化TPU底层Kernel的能力。这些举措共同指向一个事实:锁定开发者的CUDA软件壁垒,正被AI技术快速拆解。
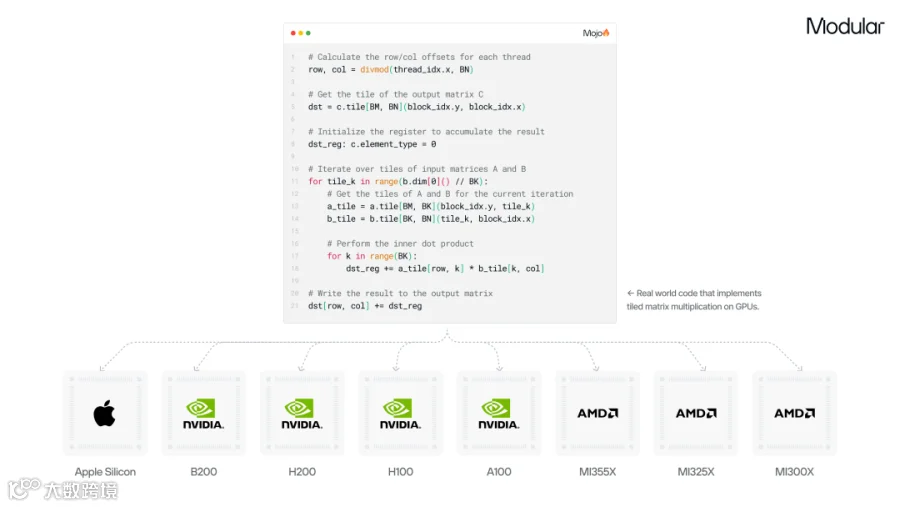
竞争单位升级:从单点突破到生态对决
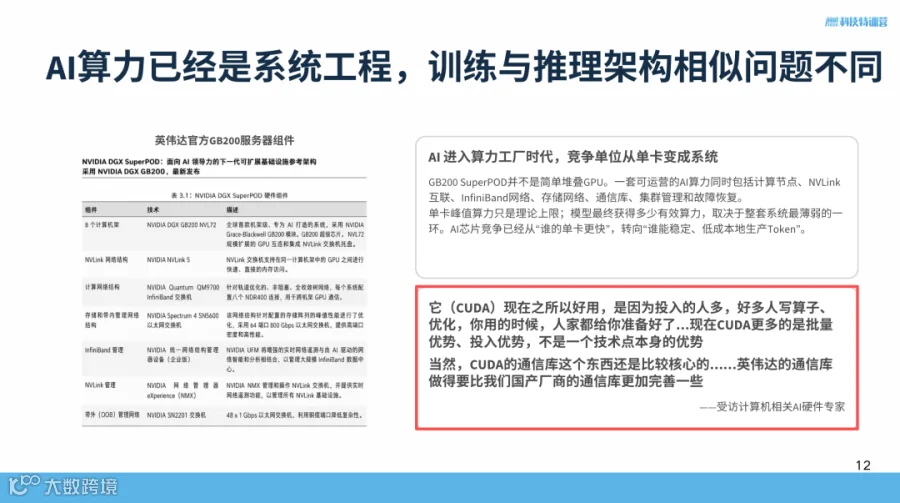
DeepSeek与华为的合作揭示了AI产业竞争的深层逻辑变化。英伟达的护城河已从单一的GPU或CUDA,扩展至NVLink、NVSwitch、网络架构、机架乃至AI Factory全链路。
当前的AI竞争已非单一企业间的对抗,而是生态系统之间的博弈。各方在争夺标准、入口和利润的同时,也在不同层级展开合作。未来胜负的关键,在于谁能构建一个迭代更快、成本更低、协同效率更高的,集模型、芯片、软件、开发者与应用于一体的完整生态。
透过现象看本质,技术变革后新产业壁垒的形成过程,才是观察科技产业价值的核心所在。
