


知名半导体分析机构Kurnal Insights近日发布了华为麒麟9050 Pro芯片的裸片(Die Shot)显微照片,首次清晰展示了这款芯片的内部物理结构。
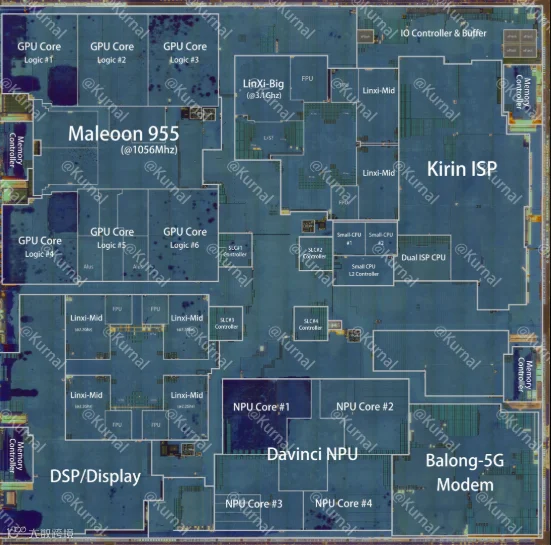
照片显示,麒麟9050 Pro由两颗尺寸完全相同的裸片垂直堆叠而成。每颗裸片尺寸为11.13mm × 10.84mm,面积约120.65mm²,略小于前代麒麟9030S。
两颗裸片分工明确:一颗负责核心计算逻辑,另一颗专用于SRAM和缓存。两者通过高密度垂直互连技术连接,实现逻辑与存储单元在物理上的紧密贴合。
这一结构标志着华为“逻辑折叠”(LogicFolding)技术的首次商业化落地。该技术将芯片从传统平面布局改为垂直堆叠,用极短的垂直互连替代长距离水平走线,从而在不依赖更先进制程的前提下,大幅提升有效晶体管密度。
工艺方面,据爆料信息显示,计算裸片采用中芯国际N+3工艺,SRAM裸片采用N+2工艺。这种双工艺节点组合在业内尚属首次。
该设计带来了显著的密度提升。据伯恩斯坦(Bernstein)研报估算,麒麟9050 Pro的等效晶体管密度达到2.38亿个/mm²,较上一代麒麟9030 Pro的约1.55亿个提升超过50%。
尽管垂直堆叠增加了键合与封装的工艺复杂度,但裸片显微照的曝光,从物理层面证实了华为通过架构创新而非单纯制程微缩来提升芯片性能的路线可行。
史上最强麒麟芯片阵容揭晓
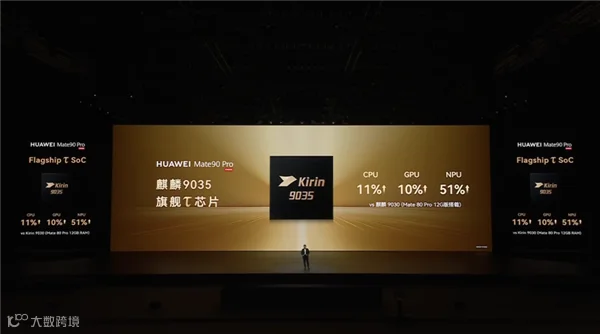
在10月1日的新品发布会上,华为正式揭晓Mate 90系列芯片阵容:标准版搭载麒麟9030,Pro版搭载麒麟9035,Pro Max及以上版本采用麒麟9050 Pro。

其中,麒麟9050 Pro作为迄今为止最强悍的华为芯片,首发“韬定律”逻辑折叠技术,在晶体管密度、AI算力和图形性能等多个维度实现跨越式提升。

麒麟9050 Pro:三维重构带来性能飞跃
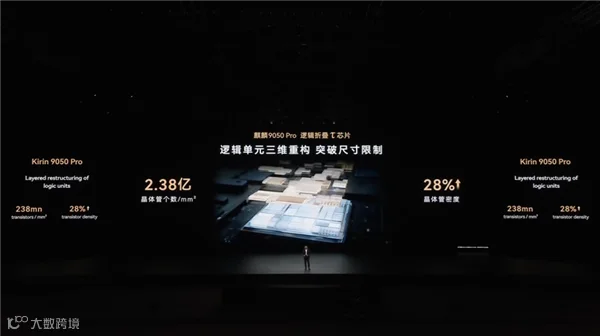
麒麟9050 Pro的核心突破在于逻辑单元三维重构。通过逻辑折叠技术,在不增加芯片面积的前提下,将更多逻辑单元集成于同一芯片,晶体管密度提升至2.38亿个/mm²。
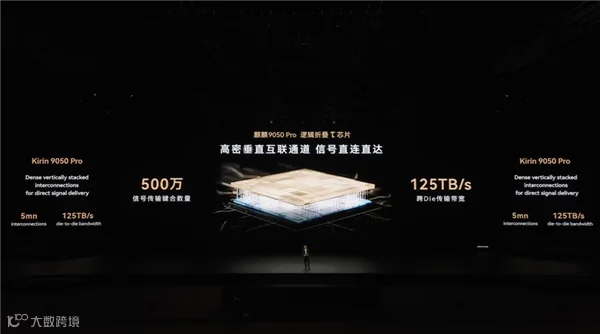
垂直堆叠带来了500万信号传输键合通道,die-to-die带宽高达125TB/s,时钟缓冲器数量减少55%,关键路径时延缩短30%。
CPU采用9核16线程设计(1超大核+2性能大核+4能效大核+2小核),多核性能提升23%。

GPU集成全新的马良955,渲染性能提升40%,配合智能调度硬加速技术,游戏平均帧率提升35%。

NPU搭载达芬奇架构,AI算力暴涨140%,端侧部署30B参数混合专家架构(MoE)大模型,支持离线修图等高算力场景;第十代ISP让长焦清晰度提升34%。

麒麟9035与9030:梯次配置满足多元需求
麒麟9035在麒麟9030 Pro基础上提频,CPU主频提升至2.85GHz。对比前代,CPU性能提升11%,GPU提升10%,NPU提升51%。
标准版麒麟9030对比上一代麒麟9020,CPU提升13%,GPU大幅提升54%,NPU提升13%。此外,该芯片集成移动安全处理器(MSP),通过后量子密码算法认证,可抵御未来量子计算机的算力破解。

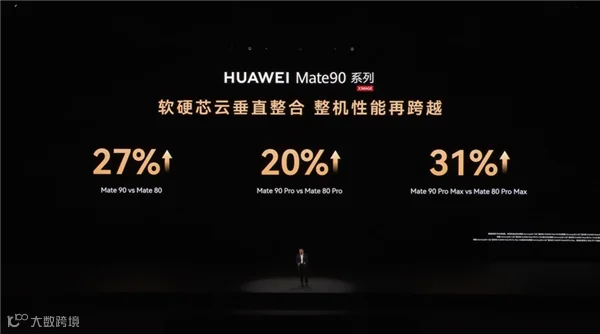
整机性能方面,Mate 90系列对比Mate 80系列均有显著提升,其中Pro Max版本性能提升幅度达31%。
与苹果技术差距缩至三年
投资研究机构伯恩斯坦最新报告指出,华为麒麟9050 Pro芯片将移动芯片与苹果的技术差距缩小至约三年,而上一代差距约为四年。
该芯片基于中芯国际N+2或N+3工艺制造,等效制程水平相当于7nm。其未使用EUV光刻机,而是通过DUV多重曝光与逻辑折叠技术实现性能提升。
报告显示,麒麟9050 Pro在Geekbench 6多核测试中超越了苹果2023年发布的3nm芯片A17 Pro。其多核性能比前代麒麟9030 Pro提升约20%。
架构创新是本次突破的核心。逻辑折叠技术使晶体管密度从每平方毫米约1.55亿个提升至约2.38亿个,增幅超过50%,这一密度水平已接近台积电初代3nm工艺。
性能提升的同时,功耗控制同样出色。在性能对齐条件下,NPU功耗下降66%,GPU功耗下降58%,CPU性能核功耗下降41%。相比麒麟9030 Pro,GPU性能提升39%,NPU吞吐量提升约150%。
伯恩斯坦将这一进展称为“被低估的突破”,认为架构改进而非制程微缩是华为缩小差距的关键驱动力。报告也指出,良率与散热仍是3D堆叠技术在大规模量产中需要持续解决的工程挑战。
