

智能体推理正演变为一种“携带完整工作记忆持续作业”的模式。历史对话、文件读取及工具调用结果均需在后续生成中复用,这些数据存储于 KV 缓存中。随着上下文长度增加及并发请求增多,GPU 的高带宽内存(HBM)容量往往率先成为瓶颈。
SemiAnalysis 在 2026 年 9 月 28 日发布的 GLM-5.3 分析中指出一个常见误区:稀疏注意力虽能减少单次计算对 KV 缓存的读取量,但并不意味着 HBM 容量需求会随之消失。以 GLM-5.3 采用的 DeepSeek 稀疏注意力为例,决定系统能否支撑长上下文和高并发的关键因素,还包括缓存层级分布、未命中时的数据搬运机制,以及推理引擎能否有效掩盖搬运耗时。
稀疏注意力优化的是“读取效率”,而非消除“存储需求”
在生成下一个 token 时,模型需回溯此前上下文的 Key 和 Value。传统稠密注意力需广泛读取历史 KV,而稀疏注意力则从长上下文中筛选出最相关的少量 token,仅针对这些 token 进行后续计算,从而降低缩放点积注意力的访存压力和带宽占用。
GLM-5.3 使用的 DeepSeek 稀疏注意力由 lightning indexer 和稀疏 MLA 组成。前者通过轻量级的查询与键关系为历史 token 打分并选出 top-k,后者仅对选中 token 执行注意力计算。核心逻辑在于,top-k 选择是“从历史中提炼重点”,而非“删除历史”。
报告强调,top-k 选择通常要求完整上下文驻留在 HBM 中,因为系统必须能够访问候选历史才能判断相关性。因此,稀疏注意力降低的是每一步的 KV 读取量,并未直接减少系统需容纳的历史 KV 总量,长上下文推理的容量瓶颈依然存在。
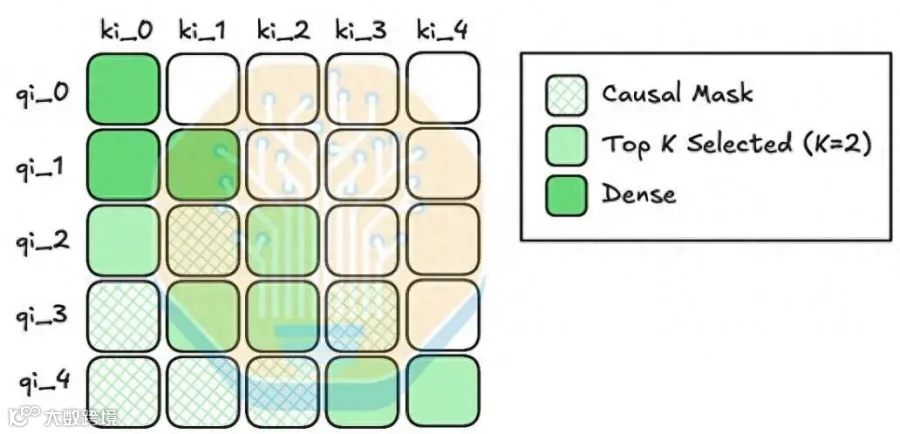
索引器先为历史 token 打分并选出 top-k,减少了后续注意力处理的对象数量,但这并不意味历史上下文可以直接从存储中移除
突破 HBM 限制:分层缓存与计算重叠策略
HiSparse 等系统的出现正是为了解决上述问题基准测试显示,普通方案在并发约 32 个请求时峰值吞吐量接近 800 tokens/s;而启用 HiSparse 后,吞吐量随并发持续上升,在 256 个请求时超过 2600 tokens/s。这表明,当高并发场景下的瓶颈在于缓存容量而非纯计算能力时,扩展缓存层级比单纯压缩计算更为有效。
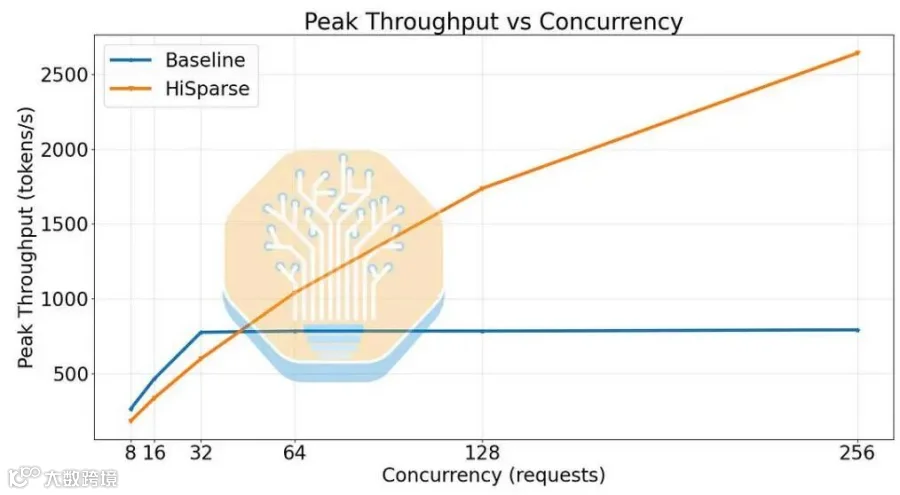
HiSparse 基准测试显示,通过扩展缓存层级,系统吞吐量未在低并发阶段提前触顶
HiSparse 采用分层缓存策略:将高频使用的 KV 保留在 GPU HBM 中,低频使用的 KV 移至主机 DRAM。若 top-k 所需数据不在 HBM 中,则从 DRAM 调入,并依据最近最少使用(LRU)规则置换其他条目。
鉴于 DRAM 访问延迟远高于 HBM,HiSparse 通过将第 N 层 KV 的数据加载与第 N-1 层的计算过程重叠执行,以掩盖缓存未命中带来的等待时间。即在模型计算尚未到达某一层时,预先提取下一层所需数据。

通过重叠执行下一层 KV 读取与上一层计算,显著降低了缓存未命中的可见延迟
HBM 与主机内存的角色重构:从单一存储到分工协作
基于 B200 加 SGLang 的实际数据显示:并发为 8 时,提示词 token 中 90.3% 从 HBM 缓存复用,仅 6.0% 来自主机缓存;当并发提升至 16,HBM 复用占比降至 54.8%,主机缓存复用升至 40.3%。尽管比例变化,总命中率在各并发度下仍保持在 95% 以上。
这一数据表明,HBM 并未被 DRAM 完全替代,而是形成了分工:HBM 存储最热、最邻近计算的数据,主机 DRAM 则承接高并发下无法装入 HBM 但可能很快复用的历史数据。若无主机缓存辅助,系统将更早触及 HBM 容量上限,或被迫重新计算及丢弃更多上下文。
稀疏注意力改变了 HBM 的角色定位:从试图容纳全部历史的唯一缓存池,转变为服务热点数据的高速层。相应地,主机 DRAM、PCIe 及其他互连介质的带宽与时延也成为影响推理性能的关键变量。

并发从 8 增至 16 后,主机缓存承担了更多提示词复用任务,但整体缓存命中率仍维持在 95% 以上
稀疏注意力的适用边界与优化成本
稀疏注意力并非无条件适用。GLM 的 top-k 设为 2048,意味着在上下文低于 2K token 时,注意力机制仍按稠密方式执行。对于短序列,建立索引和筛选 token 的开销可能超过其带来的收益。
此外,稀疏 MLA存在两种运行模式:MHA 计算量较低但内存开销大,MQA 节省内存但计算量可能增加。在长上下文场景中,访存通常是主要瓶颈,MQA 的低内存优势更明显;而在短上下文场景中,MHA 可能更快。因此,vLLM 等框架会根据序列长度和并行策略动态切换路径,而非强制统一模式。

不同序列长度下,稀疏 MLA 的最优运行模式各异,短上下文场景并不必然从稀疏化中获益
索引器的引入也带来额外成本。上下文越长,全量 token 打分耗时越显著。GLM-5.2 引入 IndexShare 技术,使每 4 个 DSA 层共享一个索引器,从而减少重复计算与缓存。结果显示,索引器缓存及相关 FLOPs 减少 75%,在不同上下文长度及 prefill/decode 场景下,吞吐量提升约 1.5 至 1.8 倍。这表明,旨在“省内存”的新增模块本身也需持续优化。

每 4 层共享一个索引器以降低重复索引开销;图示对比了 prefill 和 decode 阶段的相对吞吐量提升
综上所述,GLM-5.3 的技术路线表明,稀疏注意力并不能让长上下文推理彻底摆脱存储限制。模型侧通过减少单次 KV 读取量优化效率,推理引擎侧通过压缩、搬运和复用机制提升效能,系统侧则构建起由 HBM、主机 DRAM 及数据传输组成的分层缓存体系。评估一套推理方案是否足以应对智能体负载,不仅要看其是否采用稀疏注意力,更需考察缓存命中率、未命中数据路径以及在目标并发和上下文长度下的实际表现。