


Anthropic 近期发布了 Opus 5.5 的提示词优化指南。本文基于官方建议,结合五大核心使用场景对关键技巧进行梳理与总结,旨在帮助开发者更高效地调用模型能力。
场景一:优化思考档位,平衡效率与成本
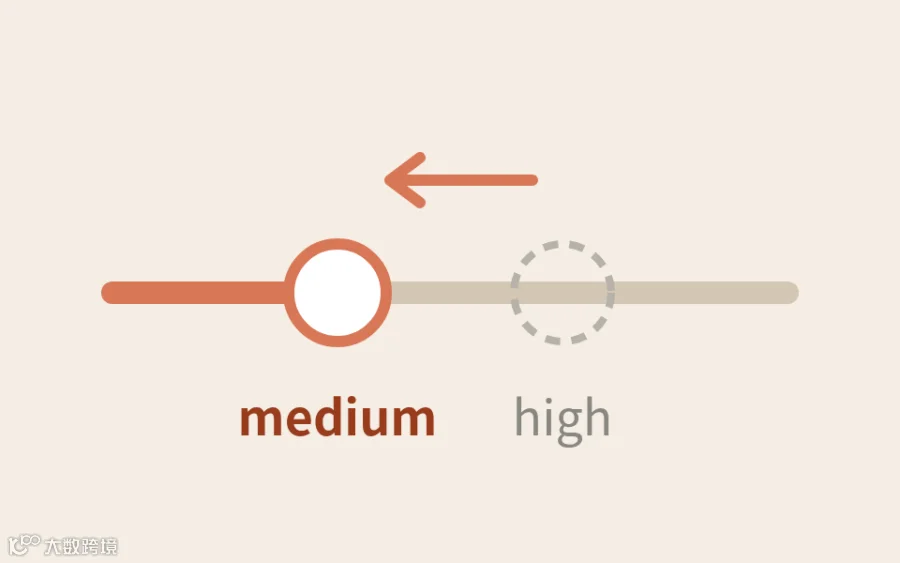
“effort”(思考档位)直接决定模型的推理深度。合理调整档位是提升响应速度、降低 token 消耗的关键。
Opus 5.5:日常任务使用 medium 档位即可。在代码编写及知识类工作中,其表现已能媲美上一代 high 档位,且速度更快、成本更低。
Sonnet 5.5:默认设为 high。针对目标明确的编程任务,建议先从 medium 尝试;日常对话则可选择 medium 或 low 档位。
优化策略:若模型响应缓慢,优先降低思考档位,而非在提示词中增加复杂性。同时,建议删除提示词中诸如“回答前请仔细思考”等冗余指令,模型具备自主判断思考时长的能力。
场景二:规范推理过程展示,避免无效重复

在 5.5 版本中,要求模型“将推理过程写入回答”可能导致请求被拒绝。若需了解模型逻辑,应直接读取“思考摘要”功能。
此外,多轮对话中模型常重复推演已解决的问题,导致响应延迟。建议在系统提示中明确设定:“已回答的问题视为完成,仅针对当前新问题进行分析”,以聚焦计算资源。
场景三:明确执行连续性,防止长任务中断

在执行长周期任务时,模型常在阶段小结后停滞等待。为确保持续执行,应在提示词中规定:除非需要用户配合或涉及高风险操作,否则在汇报进度后应自动继续执行下一步,无需额外确认。
场景四:约束过度发散,控制输出边界

高思考档位下,模型倾向于主动补充测试代码、文档或额外文件,甚至自行增加审查轮次。为抑制这种“加戏”行为:
建议在提示词中加入约束:“完成任务并确认无误后立即停止,额外想法留待最后说明”。实测显示,此类约束可在保持质量不变的前提下,将最高档位的成本降低约三分之一。
若仅需方案构思而非立即执行,应明确指示:“仅提供思路或方案,确认后再生成具体内容”,避免因模糊指令触发不必要的演示或报告生成。
场景五:细化指令要求,提升结果可靠性

代码开发:修改后必须执行实际测试或构建验证,而非仅依赖语法检查。
时效信息:涉及收费标准、规则等易过时内容,必须先联网搜索核实后再作答。
前端设计:避免使用“去 AI 味”等模糊描述,应具体指定排除项(如特定渐变色、字体等)。
图表分析:处理密集图表时,提供裁剪和放大工具比单纯提高思考档位更精准且经济。
综上所述,高效使用 Opus 5.5 的核心在于:精准调控思考档位,并提供清晰、具体的执行约束。