

导读StartLux-Decision 发布后,27B 版本报出 Decision Index 0.2.1 的 63.88 分,高于它所对照榜单中 Jev 的 57.91 分。但前者是项目方自测,早期「36 局赢 35 局」的对弈又有 21 局因接口故障失去比较意义。项目仓库已给出更新的棋局记录。我们沿着评分、对弈和使用许可三条证据,把「领先」能够成立的范围讲清楚。
本文 2030 字,阅读约 5 分钟|63.88 分从哪里来 → 35/36 局为什么不能当证据 → 快判断有价值,速度也要同条件读
63.88 分从哪里来
9 月底,StartLux 发布面向选择、是非判断和等级评分的 StartLux-Decision。它接收任务状态与一组预设候选项,为各选项返回概率,供 Agent 的下一步动作使用。项目当前公开五档稠密模型,以及一档 35B-A3B 混合专家模型。
最醒目的数字是 27B 版本在 Decision Index 0.2.1 上的 63.88 分。StartLux 用评测工具跑完整套测试,报告它在计入指数的 38 项中有 31 项高于 Jev 1.13。拿项目方引用的 9 月 28 日公开榜单快照看,Jev 是 57.91 分,差值为 5.97 分。
这里有一条必须同时读的注释:63.88 是项目方自行运行公开评测工具所得,StartLux 的结果没有进入它所对照的公开榜单。因此,能确认的是「项目方在所述测试口径下报告高于该榜单快照的 Jev」,不能把它写成「评测方已认证的榜首」。这不等于成绩必然有误:仓库提供评测脚本、结果和复现步骤,只是第三方上榜与厂商自测属于不同证据层级。
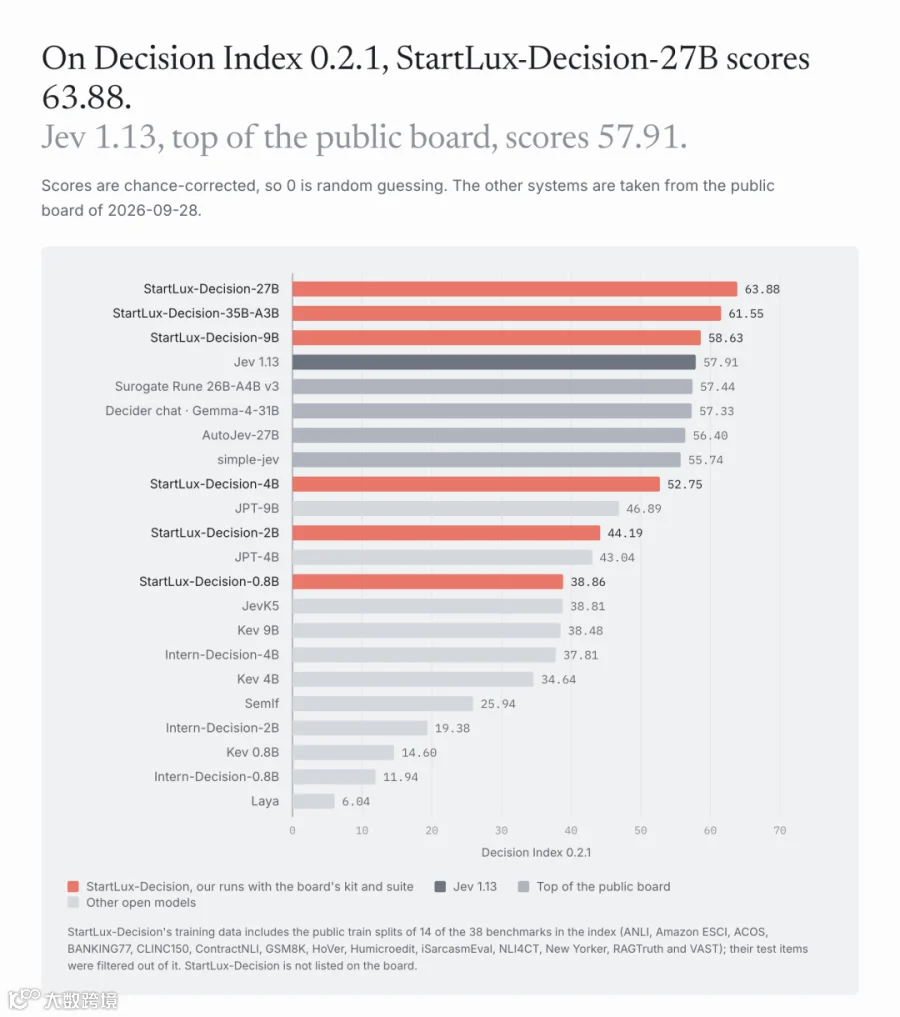 图片说明:橙色为 StartLux 自测成绩,灰色为 2026 年 9 月 28 日公开榜单快照中的成绩;图下注明 StartLux 尚未被该榜单收录。图片来源:StartLux-Decision 官方仓库
Decision Index 不是一道题的正确率。0.2.1 版把 38 项测试分到五个领域,先考虑未回答的题,再按随机猜中的机会校正,最后加权合成指数。总分高,也不表示每个任务都领先。项目方自己的分项表里,StartLux-Decision-27B 的「知识与推理」为 44.3,Jev 为 51.4;「工具与自动化」则是 82.2 对 75.1。如果 Agent 主要负责工具路由,这些差异值得继续验证;如果任务依赖复杂推理,就不能只看总分。
「31 项超过」也应按同样方式读。它是在这套测试的逐项结果里数出领先项目,不是 31 种真实工作流都已跑通。不同测试的题量、难度和评分指标并不相同,逐项领先的数量也不会直接变成综合分。综合分由评测协议规定的权重算出;换一套任务或权重,比较结果可能变化。它能帮助筛选值得继续测的候选,却不能代替业务里的成功率。
项目还披露,38 项中有 14 项的公开训练划分曾进入训练数据,并称已过滤测试题。仅凭这一点不能判定测试污染,也不能据此证明完全独立。对准备选型的团队,更稳妥的做法是保留这项训练范围说明,再用自己的任务样本复测。
35/36 局为什么不能当证据
机器之心的早期报道曾写「36 局赢了 35 局」。但 StartLux 现有的结果文档说明:那是正式对弈前的 36 局探索赛,其中 21 局对 Jev 的请求失败,原因是 API 密钥为空;对弈程序随后为 Jev 随机选取合法着法。项目方明确表示,这一批不算有效比较。
这个故障不会自动推翻 Decision Index 的自测结果,两组实验是不同证据。它直接影响的是「35/36 局证明棋力压倒 Jev」这个说法:当对手有 21 局并非由模型实际落子,原胜负比就失去应有含义。
项目随后公布了重新检查请求、保留原始棋谱的正式对弈。在预设开局、较完整的棋盘文字描述下,256 局为 64 胜、171 和、21 负;按胜一分、和半分计,StartLux-Decision-27B 得分率是 58.4%,其中约三分之二是和棋。换成提供战术事实的状态描述,同样 256 局,得分率为 48.6%。另一组随机初始局面的 Chess960 测试,也分别有自己的结果。项目方说正式记录里两侧请求均成功;这些对弈仍由项目方运行,本文未独立复测。
为什么同一对手会出现两种得分率?测试改变的不只是提问措辞,还包括送给模型的棋局信息。较完整的描述让模型自己从棋盘、历史走法和棋子位置判断下一步;加入战术事实后,输入已经替模型整理了一部分局面线索。两边模型都拿到相同版本的输入,因此各组内部仍可比较,但两组回答的是不同条件下的问题。把其中一组抽出来写成「棋力胜率」,会遮住这个关键条件。
所以现在更准确的表述是:在较完整的棋盘描述下,StartLux 的得分率高于五成;加入战术事实后,得分率低于五成。下方动图展示正式对弈中的一局,不能代替整组结果。对 Agent 开发者来说,模型拿到的状态如何组织,本身就是系统设计的一部分。
 图片说明:据项目方正式对弈动图制作的兼容版,保留棋局顺序与原播放时长。StartLux-Decision-27B 在第 19 回合将死 Jev 1.13;这只是 256 局中的一局,不代表整组得分率。图片来源:StartLux-Decision 官方仓库
快判断有价值,速度也要同条件读
StartLux-Decision 不生成一段自由文本再让程序解析,而是对开发者给出的候选项直接返回选择与概率。客服工单要选处理团队、紧急程度和严重等级时,这种接口确实方便接入工作流。概率还能提示系统何时追加信息、转交更强模型或让人确认;前提是这些概率在目标业务里经过校准,不能看到 0.9 就默认有九成正确率。
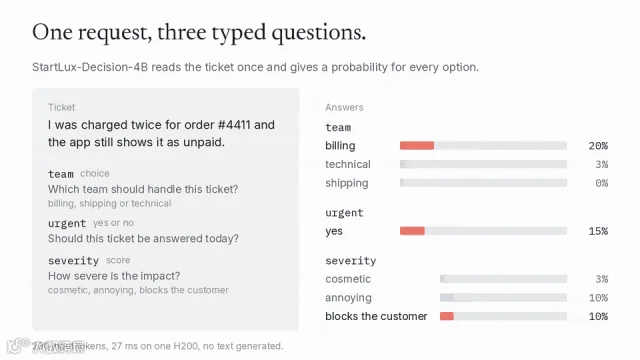 图片说明:项目方的 4B 工单演示中,一次请求同时返回处理团队、是否紧急和严重等级的选项概率。画面中的 27 毫秒是该次演示,下文的 26 毫秒是另一组平均测速。图片来源:StartLux-Decision 官方仓库
项目方给出的速度例子是:4B 模型在单卡 H200、BF16、本地 HTTP、一次回答三个问题的条件下,平均 26 毫秒。对照中的 Jev 64 毫秒来自其 API 网关报告的服务端时间。两个数字的硬件、部署和计时边界不同,不能直接推出某模型在同一环境里快多少。可以确定的是,项目公开了供工程师复测的请求格式和测速脚本;实际延迟仍要在自己的机器、问题长度与并发条件下测。
接入前,我会先在目标任务中保留三份记录:每一步有哪些候选项、模型选了什么、选错后由哪一层拦截或回退。随后再看同一批任务的正确率、概率与真实错误频率是否匹配,以及整条工作流实际节省了多少等待时间。这样得到的是本地业务条件下的判断,和公开榜单上一个综合分各有用途。
最后还有一个会改变使用决定的边界。StartLux 仓库代码采用 Apache-2.0,模型权重则采用 CC BY-NC 4.0,商业使用需要另行取得许可。「公开代码和权重」与「可以直接放进商业 Agent」是两回事。
我会把这次发布看作一个有复现入口、值得继续测的决策模型项目。63.88 分为它提供了有价值的线索,更新后的棋谱也比失效的 36 局更能说明问题。真正决定能否接入生产工作流的,是它在你的候选项、错误代价、运行环境和许可条件下,能否稳定完成那些高频的小判断。
Jev 发布后,Agent 终于有了自己的“快判断层”
参考资料
StartLux-Decision 项目仓库与许可: https://github.com/StartLuxLabs/StartLux-Decision
StartLux-Decision 评测方法: https://github.com/StartLuxLabs/StartLux-Decision/blob/main/docs/evaluation.md
StartLux-Decision 完整结果及棋局记录: https://github.com/StartLuxLabs/StartLux-Decision/blob/main/docs/results.md
Decision Index 0.2.1 评分与复现工具: https://github.com/apolinario/decision-index
机器之心早期报道(「36 局赢 35 局」说法与发布时间): https://mp.weixin.qq.com/s/finDwlosNkRSSstuKlwQbg
— THE END —
文章仅做学术分享,如有侵权请联系删除,非常感谢!