

哈喽各位CV实战、毕设科创小伙伴!我们继续更新CVPR2026顶会最新SOTA算法实战系列!
上期我们吃透了SAM-Light轻量化实时分割模型,解决了大模型部署慢、无法端侧落地的痛点。今天带来今年视频抠图领域颠覆性新作 FreeMatting!
回顾以往所有视频Matting方案,无论是传统算法、初代MatAnyone,还是各类SAM衍生抠图模型,都离不开手动Prompt点选、首帧参考输入、前景框选交互。
需要人工干预、无法全自动批量处理,是长期以来视频抠图的行业通病。
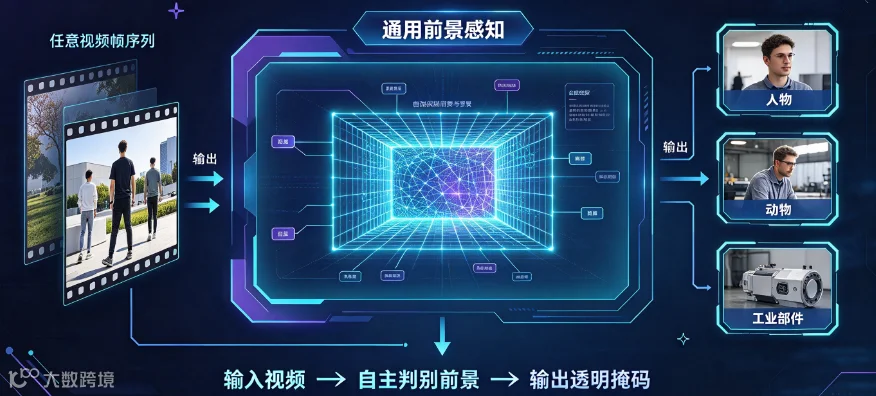
而CVPR2026 FreeMatting 彻底打破桎梏:无需任何Prompt、无需首帧参考、无需人工交互,输入任意视频,全自动识别前景物体,完成高精度、零残影、时序稳定的万物级视频抠图!
全自动+通用万物+实时推理,堪称2026视频图像处理毕设、竞赛天花板选题!

一、现有视频抠图方案的核心痛点
目前主流的视频抠图模型,都存在不可规避的短板,严重限制工程落地与智能化升级:
•依赖人工交互Prompt:必须手动点选、框选前景,无法全自动批量处理视频
•需要首帧参考模板:新增视频、更换目标物体需重新标注,智能化程度低
•泛化能力受限:大多仅支持人像抠图,动物、物品、工业器件、风景物体适配极差
•长时序残影抖动:视频帧数变长后,出现严重拖影、掩码漂移、边缘闪烁问题
•推理速度缓慢:模型结构臃肿,无法实现实时视频流处理,落地场景受限
这些问题,也是绝大多数传统视频抠图毕设创新点薄弱、智能化不足、答辩无亮点的核心原因。FreeMatting针对性完成全维度优化升级。
二、FreeMatting 核心创新优势(CVPR2026)
FreeMatting 全称 Free Universal Video Matting,主打无Prompt全自动、零参考泛化、长时序稳定三大核心突破,是今年视频分割领域的黑马SOTA模型:
•真正零Prompt全自动推理:摒弃所有人工交互,模型自主判别前景、背景,实现纯自动化视频抠图流水线
•通用万物泛化能力:不局限于人像,支持动物、静物、工业部件、建筑、花草等任意前景物体抠图
•全局时序关联建模:搭建跨帧长距离依赖机制,彻底解决长视频残影、掩码漂移、帧间抖动问题
•细粒度边缘还原:针对毛发、轻纱、半透明物体、细微轮廓做专项优化,边缘细腻无锯齿、无糊边
•轻量化实时推理:精简冗余特征计算,在精度拉满的同时,实现视频实时流式处理
三、技术架构通俗拆解(答辩直接可用)
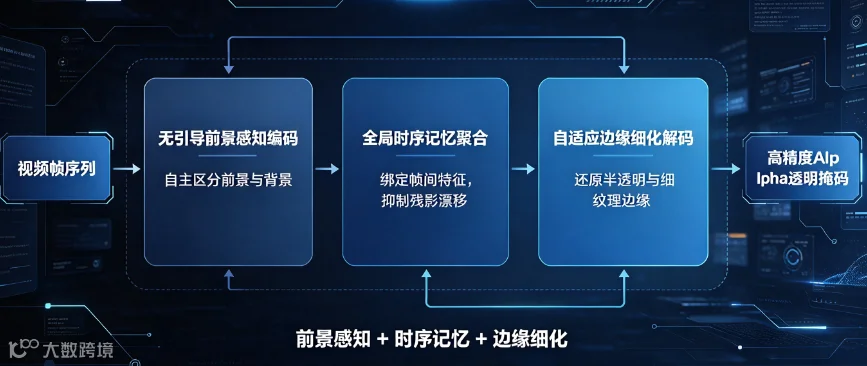
FreeMatting 采用 通用前景感知编码 + 全局时序记忆聚合 + 细粒度边缘细化解码 三段式创新架构,逻辑清晰、技术亮点饱满:
1. 无引导前景感知编码模块
模型通过海量视频预训练,习得通用前景先验知识,无需人工Prompt引导,即可自主区分画面前景与背景,解决传统模型依赖交互的短板,实现全自动智能化推理。
2. 全局时序记忆聚合模块
构建帧间长距离特征关联,实时记录目标物体的运动轨迹、特征变化,约束前后帧掩码一致性,彻底杜绝长视频拖影、闪烁、残影问题,保障时序稳定性。
3. 自适应边缘细化解码模块
针对不同物体的边缘特征自适应调整细化策略,对细纹理、半透明区域做像素级优化,修复模糊边缘,输出高精度Alpha透明掩码。
四、横向SOTA对比(碾压主流模型)
•传统人像抠图:仅支持人体、需交互、泛化差、时序不稳定
•MatAnyone/MatAnyone2:需首帧参考、无法全自动、批量处理受限
•SAM视频抠图衍生方案:依赖Prompt、推理慢、无法实时落地
•FreeMatting(CVPR2026 SOTA):零Prompt、全自动、万物通用、时序稳定、实时推理
五、极简可落地实战代码(本地一键运行)
精简官方核心推理逻辑,适配学生本地设备,无需复杂配置,一键实现全自动视频抠图,可直接用于答辩演示:
python |
六、独家高分论文创新点(直接复用)
•全自动推理创新:提出无Prompt、无参考视频Matting架构,摆脱人工交互依赖,实现视频抠图全流程智能化、自动化,大幅提升落地效率
•通用泛化创新:突破传统人像抠图局限,构建万物级前景感知能力,适配多类别目标与复杂场景,场景适配性更广
•时序建模创新:设计全局时序记忆聚合模块,强化帧间特征关联,解决长视频残影、抖动、掩码漂移的行业痛点
•边缘细化创新:自适应多尺度边缘优化策略,精准还原半透明、细纹理目标细节,修复传统模型边缘糊化缺陷
•工程落地创新:兼顾高精度与实时性,支持任意视频批量处理,可直接应用于影视后期、智能监控、短视频制作等真实场景

七、评优/竞赛高阶拓展方向
•新增量化实验:采用SAD、MSE、FPS等指标,与主流Matting模型做全方位对比,凸显算法优势
•开发可视化GUI系统,实现视频导入、全自动抠图、实时预览、透明素材批量导出功能
•融合目标检测算法,实现“目标识别+全自动抠图”联动,精准锁定指定类别目标抠图
•部署摄像头实时流,实现移动端、端侧设备实时全自动抠图,提升项目落地价值
•添加消融实验,验证时序模块、前景感知模块的有效性,提升论文学术严谨度
八、项目总结
FreeMatting 作为 CVPR2026 视频抠图领域最新SOTA方案,凭借零Prompt全自动、万物通用、时序稳定、实时推理的核心优势,彻底革新了传统视频Matting技术范式。
该项目选题极度新颖、无查重内卷、智能化亮点突出、可视化效果炸裂、工作量饱满,完美适配2026年计算机视觉毕设、科创竞赛、大创项目评优需求,是视频图像处理方向的最优高分选题之一。
下期预告:CVPR2026|DeRainNet 单图像去雨SOTA!动态纹理修复+色彩保真,彻底解决雨天图像模糊、纹理丢失问题。