


软硬件对齐的核心,是让 RTL 版本和 C++ 版本共享同一接口、同一结果、同一周期。用
.vlt声明分层编译,运行时替换eval(),Verilog 零改动,两版逐拍对拍,RTL 与 C++ 各自演化却始终一致。
目录
-
• 一、软硬件对齐的挑战 -
• 二、无侵入的三大支柱 -
• 三、目录结构 -
• 四、完整工作流 -
• 五、核心代码 -
• 六、三方视角 -
• 七、总结
一、软硬件对齐的挑战 🛡️
1.1 为什么软硬件会对不齐
软硬件对齐的目标很简单:同一个输入,RTL 和 C++ 必须给出同一个输出。但实际工程里,对齐往往做不到,原因通常有三个:
-
• 接口不同:RTL 是信号级,软件是事务级,中间隔着一层手工写的封装,容易错位。 -
• 速度不同:RTL 慢,软件团队跑不动大向量,只能用小样本,覆盖不足。 -
• 周期不同:RTL 有时序握手,软件没有周期概念,两边时序语义天然不一致。
传统做法是让软件团队手工写封装层,在 C++ 里推时钟、等握手。这种侵入式方案虽然能跑,但引入了新的问题:封装层本身是一份"仿真的 RTL",一旦 RTL 改了周期数,封装层要跟着改;一旦封装层写错了,软件团队拿到的是错的接口。
更麻烦的是,为了加速,很多团队会在 RTL 里塞 DPI 宏:
   `ifdef USE_DPI
    import "DPI-C" function longint add_c(...);
    assign {cout, sum} = add_c(a, b, cin);
`else
    // 原实现
`endif
这段代码的问题在于:
-
• RTL 被污染:可综合代码里混进了仿真器相关的宏,不再是流片的那份。 -
• 审查变复杂:评审要同时看 Verilog 和 C++,边界职责不清。 -
• 回退成本高:每次切换都要重新编译整个 RTL,迭代变慢。 -
• 可移植性差:换一个仿真器,宏和 import 要重新适配,被锁死。
这些问题的本质,是把仿真器的需求泄漏到了 RTL 层。RTL 本该只描述硬件行为,现在却要为对齐和加速承担额外负担。
1.2 对齐的三个层次
软硬件对齐不是一件事,而是三个层次:
三层缺一不可。只有接口对齐,结果可能错;只有结果对齐,周期可能乱;只有周期对齐,接口可能不兼容。
无侵入方案的目标,就是一次同时满足这三层对齐,而且不碰 RTL 源码。
1.3 无侵入的做法
RTL 源码一行不改,通过外部的 .vlt 控制文件声明分层编译:
   `verilator_config
hier_block -module "seq_adder"
hier_block -module "handshake_wrapper"
然后在 C++ 侧用运行时打桩替换目标模块的 eval():
   void seq_adder_eval_stub(void* obj) {
    Vseq_adder* m = static_cast<Vseq_adder*>(obj);
    uint32_t r = (uint32_t)m->a + (uint32_t)m->b + (m->cin & 1);
    m->sum  = r & 0xFF;
    m->cout = (r >> 8) & 1;
    m->done = 1;
}
这两段代码的关系:
-
• Verilog 完全无痕:RTL 里看不到任何仿真器相关的东西,和流片版本完全一致。 -
• 替换发生在 C++ 层:通过修改函数入口地址实现,不碰源码。 -
• 可运行时切换:随时恢复原实现,不需要重新编译。 -
• 硬件团队零感知:RTL 怎么写的,还是怎么写的,职责边界清晰。
关键在于,无侵入把"对齐"这件事从 RTL 层拉到了 C++ 层。RTL 只管描述硬件,C++ 只管对齐和加速,两者通过一个稳定的接口对齐。
1.4 侵入式 vs 无侵入

对比结论:
二、无侵入的三大支柱 🏛️
2.1 支柱一:分层编译
用 .vlt 控制文件,把模块拆成独立的 C++ 类。Verilator 的 --hierarchical 模式会为每个标记为 hier_block 的模块生成独立的 V<module> 类:
   obj_dir/
├── Vtop/                  ← 顶层
├── Vhandshake_wrapper/    ← 独立类
└── Vseq_adder/            ← 独立类
每个独立类的接口就是端口,父模块通过对象指针调用子模块的 eval()。这意味着模块之间不再是内联展开的扁平代码,而是对象之间的相互调用,也就有了被外部介入的可能。
分层编译对接口对齐的意义:
-
• 每个模块有独立的 C++ 类,接口就是端口,边界清晰。 -
• 模块之间通过对象调用,不是内联展开,可以被外部介入。 -
• 可以单独替换任意一层,不影响其他层,粒度灵活。 -
• RTL 源码不动,只加一个外部配置文件,零侵入。 -
• 编译单元隔离:改一个模块只重新编译一个模块,增量构建快。
这项能力并不是 Verilator 独有,但 Verilator 的实现最成熟,配置也最简单:一行 hier_block 就能让一个模块变成独立的编译单元,几乎不需要额外的适配。
2.2 支柱二:运行时打桩
打桩的本质是修改函数的入口地址,让调用方跳到自定义实现。在 C++ 里,这通过修改函数入口的机器码实现:
   void seq_adder_eval_stub(void* obj) {
    Vseq_adder* m = static_cast<Vseq_adder*>(obj);
    uint32_t r = (uint32_t)m->a + (uint32_t)m->b + (m->cin & 1);
    m->sum  = r & 0xFF;
    m->cout = (r >> 8) & 1;
    m->done = 1;
}
   Stub stub;
stub.set(ADDR(Vseq_adder, eval), seq_adder_eval_stub);
打桩对结果对齐的意义:
-
• 不修改 Verilator 生成的任何代码,只改函数入口。 -
• 不重新运行 Verilator,构建流程不变。 -
• 运行时动态替换,可以随时恢复。 -
• 零性能开销:一次地址改写,之后每次调用直接跳转。 -
• 可选择性:只替换需要的模块,其他模块保持原样。
打桩的技术原理并不复杂,但它的意义在于:把"换实现"这件事从编译期挪到了运行期。这让 A/B 对比、条件替换、回归测试都变得极其简单。例如,可以在同一个测试程序里先跑 RTL 版本,再跑桩版本,逐项对比结果和周期数,而无需重新编译任何 RTL 代码。
2.3 支柱三:RAII 守护
用 RAII 对象管理打桩的生命周期:进入作用域时打桩,离开时自动恢复。
使用方式:
   {
    SeqAdderStubGuard guard;    // 进入作用域 → 打桩
    run_tests();
}                               // 离开作用域 → 自动恢复 RTL
这一层看似简单,但正是它让"替换"和"恢复"变成了一对天然配对的操作:即使中途抛异常,也能保证恢复原实现,不会留下半打桩状态。在大型测试中,RAII 还能保证即使某个用例失败,也不会影响后续用例的执行。
2.4 三大支柱的协作
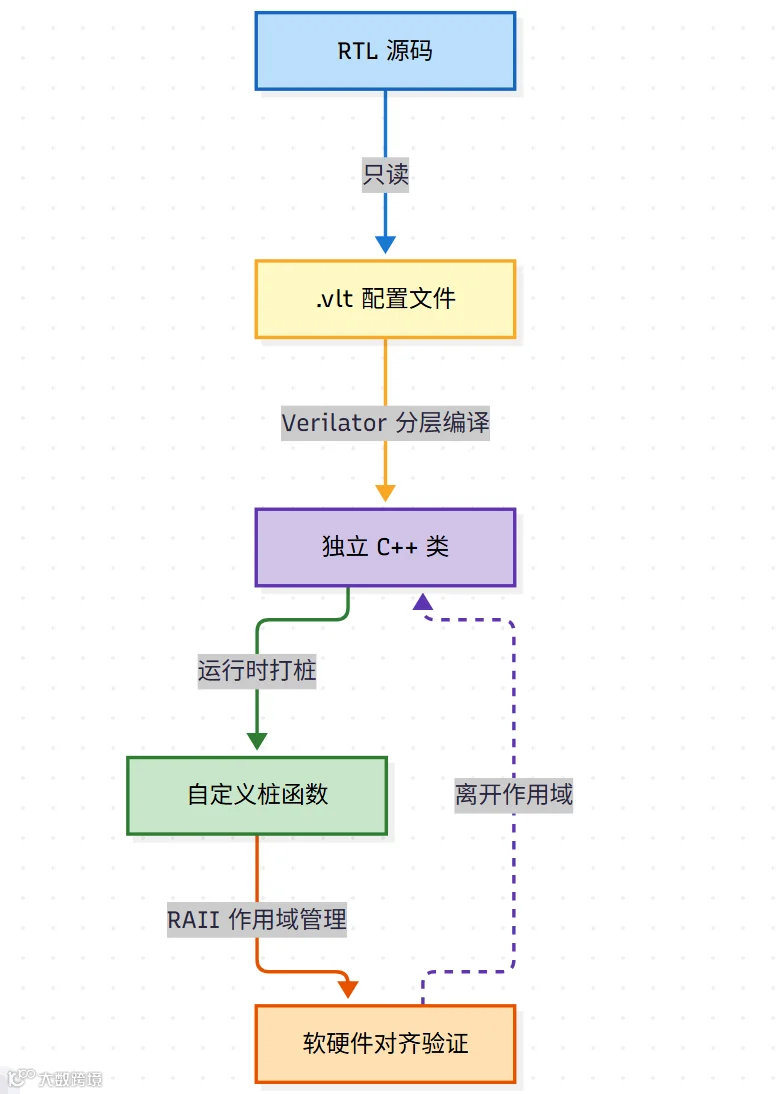
三个支柱的分工:
-
• 分层编译:提供 C++ 类接口,编译期完成,解决接口对齐。 -
• 运行时打桩:执行函数替换,运行期完成,解决结果对齐。 -
• RAII:控制作用域生命周期,工程层封装,保证对齐过程可重复、可回退。
三者缺一不可:没有分层编译,模块被内联无法介入;没有运行时打桩,只能改源码;没有 RAII,切换容易出错。三者组合起来,才是完整的无侵入对齐方案。
三、目录结构 🗂️
   project/
├── CMakeLists.txt
├── cfg/
│   └── hier.vlt              ← 分层编译配置
├── api/                      ← 事务级封装
│   ├── adder_api.h
│   └── adder_api.cpp
├── stub/                     ← 运行时替换
│   ├── seq_adder_stub.h
│   └── seq_adder_stub.cpp
├── rtl/                      ← 纯净的 RTL
│   ├── top.v
│   ├── handshake_wrapper.v
│   └── seq_adder.v
├── tb/
│   └── testbench.cpp
└── third-party/
    └── cpp-stub/src/
目录的职责划分:
-
• rtl/:硬件团队维护,零仿真器痕迹。 -
• cfg/:声明哪些模块独立,纯配置。 -
• api/:封装 Verilator 和时钟,对 testbench 隐藏细节。 -
• stub/:运行时替换逻辑,独立的软件实现。 -
• tb/:对拍测试,只调 API,不感知底层。
这种划分的核心是职责隔离:每个目录只关心一件事,互相之间通过明确的接口通信。改 RTL 不动 C++,改 C++ 不动 RTL,改桩函数不动 RTL 也不动 api。任何人只需要看懂自己关心的那部分,不需要了解全局。对于团队协作来说,这种隔离能大幅降低沟通成本,也能让新人更快上手。
四、完整工作流 🔄
4.1 数据流
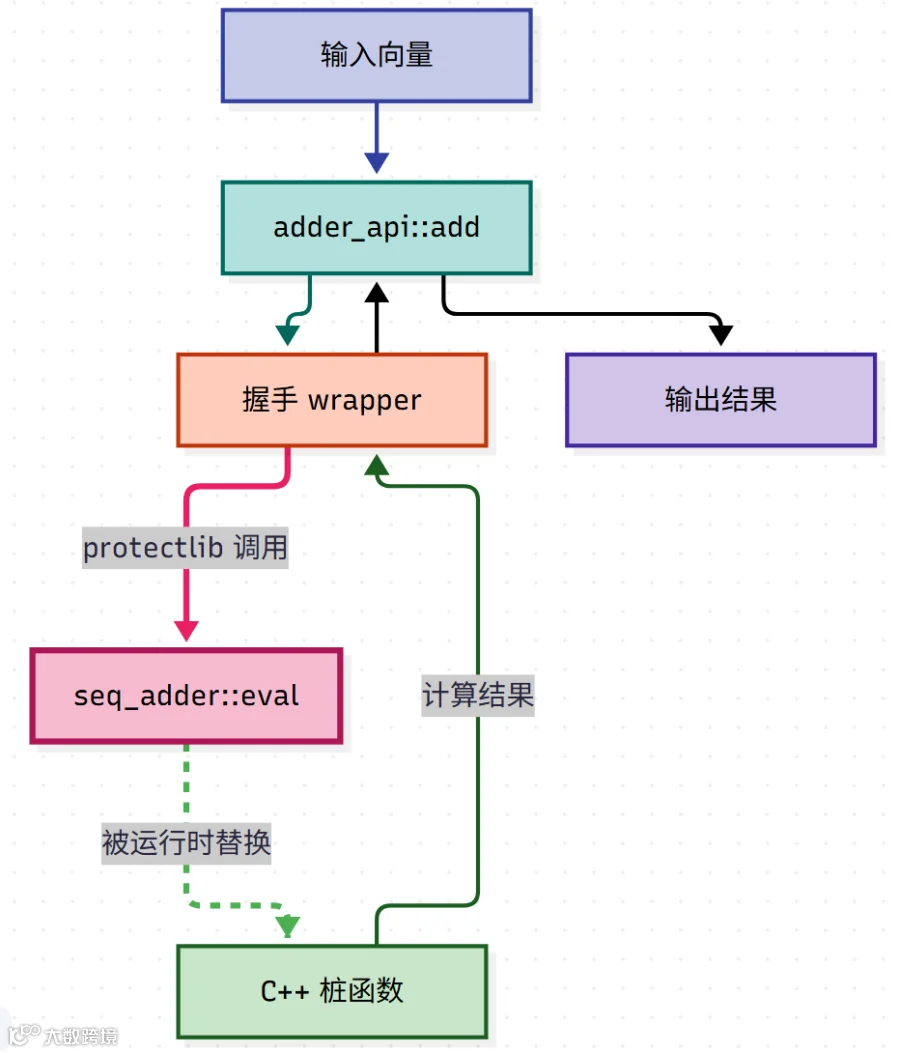
数据流的关键环节:
-
• RTL 侧:握手协议全部保留,周期语义不变。 -
• 替换点:只在 seq_adder::eval这一层,粒度最小。 -
• 桩函数:一次算完 a + b,无状态,纯函数。
4.2 时序对齐
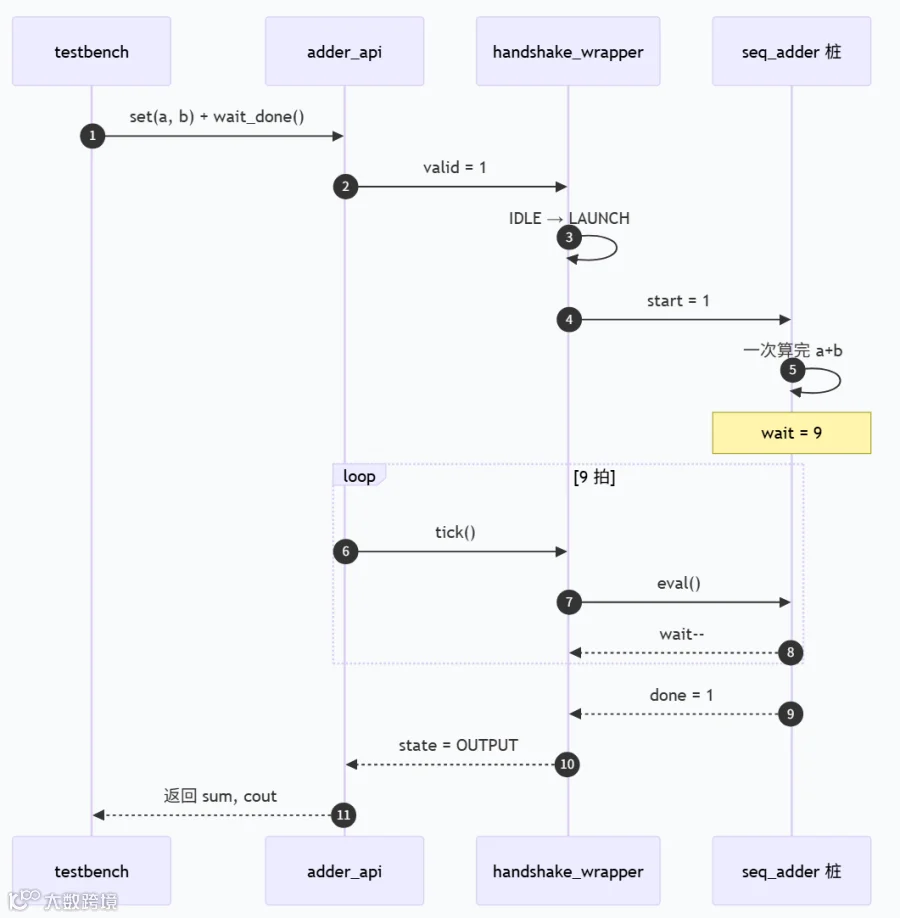
时序的关键点:
-
• 周期数由 wrapper 决定,和桩函数无关。 -
• 桩函数用计数器复现 9 拍, wait = 9。 -
• 外部看到的 done 时机,和 RTL 完全一致。
这一点很重要:无侵入不等于牺牲周期精度。只要把时序协议留在 RTL 里,桩函数只负责"算",周期数就完全由 wrapper 决定,桩函数只要复现对应的计数器就行。这就是周期对齐的实现方式。
五、核心代码 💻
5.1 纯净的 RTL
rtl/seq_adder.v —— 零仿真器痕迹:
   module seq_adder (
    input        clk, rst, start,
    input  [7:0] a, b,
    input        cin,
    output [7:0] sum,
    output       cout,
    output       done
);
    reg [2:0] i     = 3'd0;
    reg       carry = 1'b0;
    reg [7:0] sum_r = 8'd0;
    reg       busy  = 1'b0;

    assign sum  = sum_r;
    assign cout = carry;
    assign done = ~busy;

    always @(posedge clk or posedge rst) begin
        if (rst) begin
            i <= 0; carry <= 0; sum_r <= 0; busy <= 0;
        end else if (start && !busy) begin
            i <= 0; carry <= cin; busy <= 1;
        end else if (busy) begin
            sum_r[i] <= a[i] ^ b[i] ^ carry;
            carry    <= (a[i]&b[i]) | (a[i]&carry) | (b[i]&carry);
            if (i == 7) busy <= 0;
            else        i    <= i + 1;
        end
    end
endmodule
这段 RTL 的特点:
-
• 没有 ifdef USE_DPI。 -
• 没有 import "DPI-C"。 -
• 没有任何仿真器相关代码。 -
• 和流片版本 完全一致。
5.2 声明式配置
cfg/hier.vlt —— 只有声明,没有实现:
   `verilator_config
hier_block -module "seq_adder"
hier_block -module "handshake_wrapper"
配置文件的作用:
-
• 告诉 Verilator 哪些模块要独立编译。 -
• 不改 RTL 源码,只加一个外部文件。 -
• 和 RTL 是松耦合关系,可以删掉。
hier_block 本身不改变任何功能语义,只是告诉 Verilator"这个模块不要内联,编译成独立类"。删掉这行配置,Verilator 恢复内联,一切照旧。这也是无侵入方案可以放心使用的原因:它对 RTL 的语义没有任何影响。
5.3 运行时桩函数
stub/seq_adder_stub.cpp —— 一行加法替代 8 拍进位链:
   #include "seq_adder_stub.h"
#include "Vseq_adder.h"
#include "stub.h"

namespace {
uint64_t g_call_count = 0;

void seq_adder_eval_stub(void* obj) {
    Vseq_adder* m = static_cast<Vseq_adder*>(obj);
    uint32_t r = (uint32_t)m->a + (uint32_t)m->b + (m->cin & 1);
    m->sum  = r & 0xFF;
    m->cout = (r >> 8) & 1;
    m->done = 1;
    g_call_count++;
}
}

void register_seq_adder_stub() {
    static Stub stub;
    stub.set(ADDR(Vseq_adder, eval), seq_adder_eval_stub);
}
桩函数的特征:
-
• 无状态,纯函数。 -
• 不改 Verilator 生成的代码。 -
• 可随时恢复: Stub析构时自动还原。
5.4 RAII 守护
用 RAII 对象 SeqAdderStubGuard 在构造时打桩、析构时恢复,让"替换/恢复"成为一对配对操作,异常安全、作用域清晰。
5.5 对拍验证
tb/testbench.cpp —— 跑两遍,逐项对比:
   int main(int argc, char** argv) {
    adder_api_init(argc, argv);

    // ========== 第 1 遍:RTL 原版 ==========
    printf("=== RTL version ===\n");
    adder_api_reset_total_ticks();
    int err1 = run_all_tests();
    uint64_t rtl_ticks = adder_api_get_total_ticks();

    // ========== 第 2 遍:替换版 ==========
    printf("=== Stub version ===\n");
    {
        SeqAdderStubGuard guard;   // ← RAII 打桩
        adder_api_reset_total_ticks();
        int err2 = run_all_tests();
        uint64_t stub_ticks = adder_api_get_total_ticks();

        printf("  RTL  ticks: %llu\n", rtl_ticks);
        printf("  Stub ticks: %llu\n", stub_ticks);
        printf("  Match: %s\n",
               rtl_ticks == stub_ticks ? "✅ YES" : "❌ NO");
    }

    return (err1 || err2) ? 1 : 0;
}
对拍的重点:
-
• 同一份测试代码,跑两遍,保证可比性。 -
• 对比 tick 数,验证周期一致,证明时序没变。 -
• 对比结果,验证功能一致,证明计算正确。 -
• RAII 自动切换,不用手动复位,代码更简洁。
这里的 rtl_ticks == stub_ticks 是硬证据:如果替换后周期数变了,说明时序协议被破坏了;如果周期数一致、结果也一致,说明替换是等价的。这比任何主观判断都可靠。
三层对齐的验证方式:
六、三方视角 👥
6.1 分工
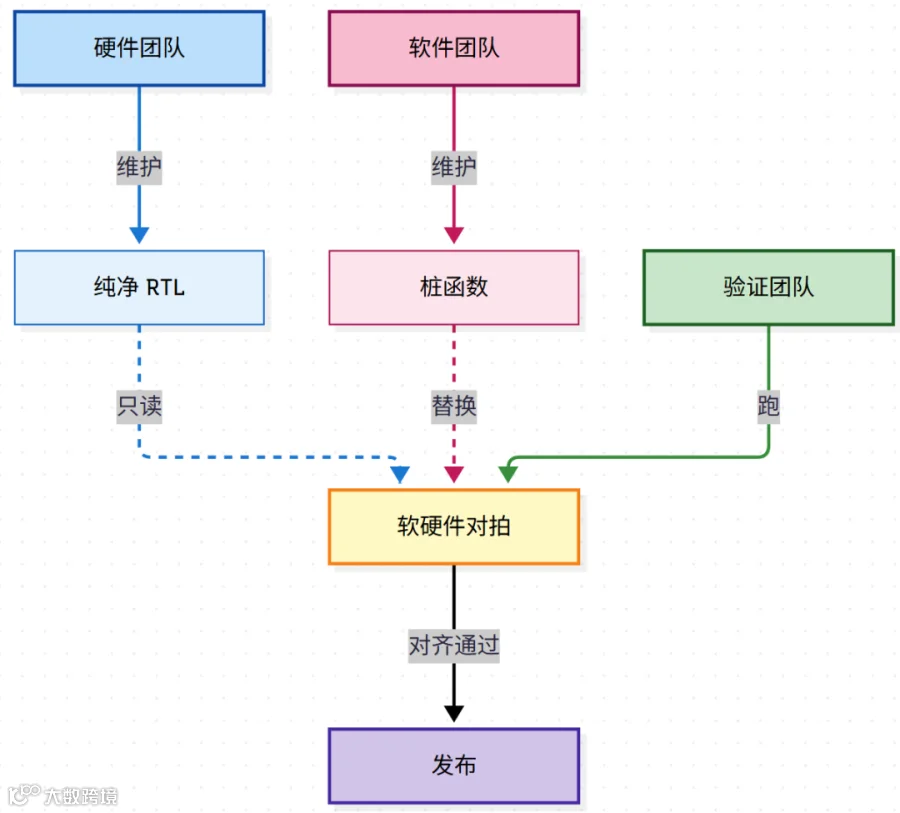
分工的边界:
-
• 硬件团队:只维护 RTL,不碰桩函数。 -
• 软件团队:只维护桩函数,不碰 RTL。 -
• 验证团队:跑对拍,两边都看但都不改。
6.2 交付形态
6.3 核心价值
软硬件对齐的本质:让 RTL 和 C++ 各自独立演化,只在接口层对齐。
具体体现:
-
• RTL 是 RTL:不因为仿真需求而变脏。 -
• C++ 是 C++:不因为要仿真 RTL 而畸形。 -
• 对拍是契约:接口一致,结果对齐,周期可验证。 -
• 可回退是保障:一行 RAII,随时切换。
七、总结 🎯
7.1 三步走
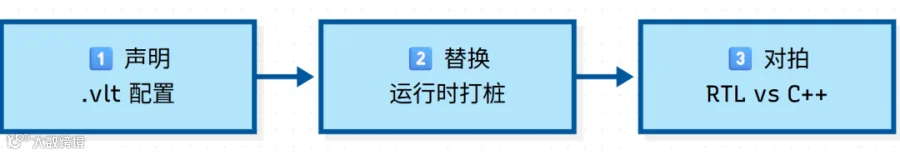
三步的内容:
-
• 第一步: .vlt声明hier_block,不改 RTL。 -
• 第二步:运行时替换 eval,不改生成的代码。 -
• 第三步:RAII 切换跑两遍,逐项对比。
7.2 关键洞察
7.3 结论
软硬件对齐不是让两边一样慢,而是让两边一样对。
这样做的效果:
-
• 硬件团队:专心写 RTL,不被仿真需求打扰。 -
• 软件团队:专心写 C++,不被 RTL 细节绑架。 -
• 验证团队:专心跑对拍,两边都是黑盒。 -
• RTL 源码:保持纯净,可流片。 -
• 软件代码:流片前就能跑通,和 RTL 严格对齐。
💎 这一切的支点,就是
.vlt的一行hier_block和一次函数入口的替换。