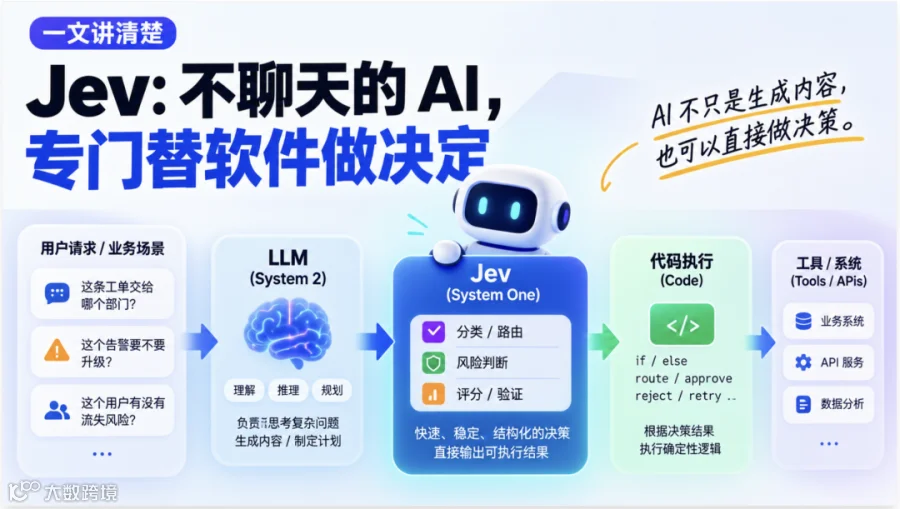
2026 年 9 月 15 日,TypeSafe AI 发布了一个很特别的 AI 模型:Jev。
它不会聊天,不会写文章,也不会生成代码。
它只做一件事情:
> 替软件做决定。
比如:
-
这条工单应该交给哪个部门? -
这个告警要不要升级? -
这个 Agent 动作是否需要人工确认? -
这个用户有没有流失风险?
它不会生成一段自然语言,而是直接返回结构化结果:
technical: 0.91
billing: 0.06
other: 0.03
if technical > 0.8:
    route_to("technical")
这就是 Jev 有意思的地方。
---
一、什么是 System One?
Jev 把自己定位成一种 System One Model。
这个名字来自 Daniel Kahneman 的《思考,快与慢》。
简单理解:
- System 1
:快速、直觉式判断 - System 2
:慢速、深度推理
过去几年,我们一直在训练 AI 做 System 2:
> “请分析一下这个问题。”
然后模型开始思考、推理、生成文字。
但软件系统里其实有大量问题根本不需要一篇答案:
> “这条消息属于哪个部门?”
> “这个动作安全吗?”
> “要不要转人工?”
这些问题真正需要的只是:
一个快速、稳定、结构化的判断。
所以 Jev 的核心思路可以概括成:
> LLM 负责生成内容,System One 负责生成决策。
二、为什么不直接让 LLM 做分类?
当然可以。
例如:
用户消息
↓
LLM
↓
“我认为这应该属于技术问题……”
↓
JSON
↓
解析 / 校验
↓
业务代码
问题是,软件其实只需要最后那个:
technical却不得不让 LLM 先生成一段文字,再让程序把它解析回来。
比较Jev 的处理过程:

两种方式最大的区别是:
> LLM 输出的是“内容”,System One 输出的是“决策”。
因此 System One 天然更适合进入软件的控制流:
Decision
↓
if / else
↓
route / approve / reject
三、它和传统分类模型有什么区别?
看到这里,很多人第一反应可能是:
> “这不就是分类模型吗?”
某种程度上,是。
但一个重要区别在于:
传统分类模型通常把分类任务写进训练过程;System One 则把“问题定义”放到了运行时。
传统分类模型:
利用特定标签数据训练:0 = billing
1 = technical
2 = other
↓
训练完成
↓
只能做这个分类
JEV (System One):
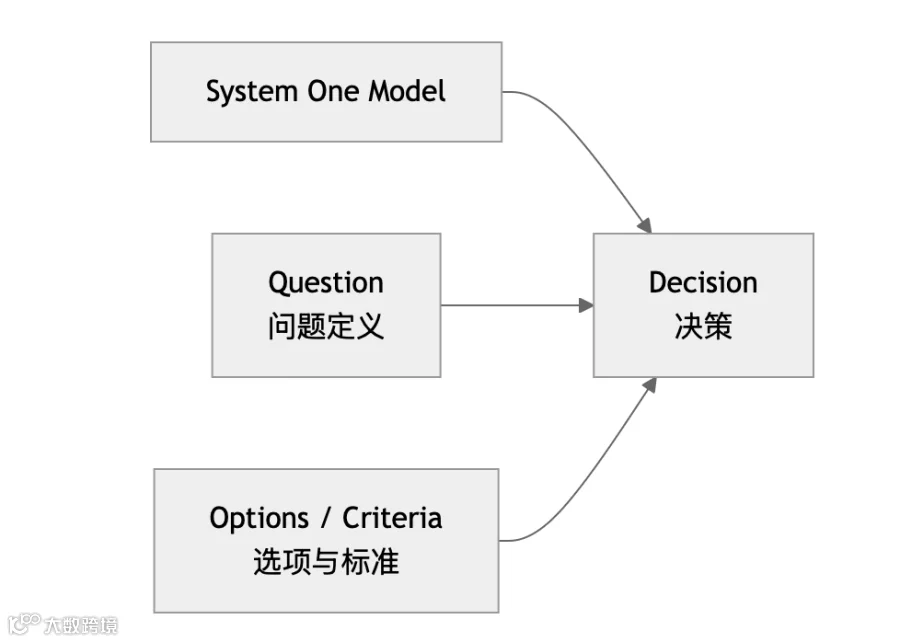
你可以根据业务重新定义问题和选项,而不一定需要重新训练模型。
所以它更像:
> 一个能读懂业务定义的通用决策器。
传统分类模型更像专用分类器。
JEV (System One Model) 更接近通用决策引擎。
四、真正值得关注的,是 Agent
如果只把 Jev 看成一个分类模型,其实低估了它的意义。
现在 Agent 的一个典型问题是:
> 是不是所有事情都需要交给大模型?
例如 Agent 在执行过程中不断需要判断:
-
这个工具能不能调用? -
这个参数安全吗? -
这个结果可信吗? -
下一步应该调用哪个 Agent? -
是否需要人工确认?
这些事情很多并不需要一个大模型进行长时间推理。
它们更像:
> 判断、路由、评分、验证、护栏。

一句话:
> LLM 负责想,System One 负责判断,Code 负责执行。
这可能是 Jev 真正值得关注的地方。
五、当然,它也不是万能的
我测试俄罗斯方块时,Jev 的表现就很差。
这反而说明了一个非常重要的边界:
> 能用确定性算法解决的问题,就不要使用 AI。
比如:
-
排序 -
对账 -
精确计算 -
明确规则的调度
这些事情传统算法通常更合适。
System One 真正有价值的区域是:语义决策。
六、还有一个容易忽略的问题
System One 虽然输出的是概率,但:
> 有概率 ≠ 不会错。
例如:
technical: 0.91并不意味着模型一定正确。
真正有价值的是:
if probability > 0.9:
    auto_execute()
else:
    human_review()
也就是说,概率最终应该进入业务控制流。
它的目标不是告诉人一个答案,而是让软件根据置信度决定下一步怎么做。
结语:AI 开始进入软件的“控制流”
过去几年,我们一直在让 AI 学会:
> 如何和人说话。
Jev 探索的是另外一个方向:
> 如何直接和软件对话。
传统 AI:
AI → 文字 → 人 / 程序
System One:
AI → Decision → 程序
这意味着 AI 不一定只是一个“聊天窗口”或者“内容生成器”。
它也可以成为软件控制流中的一个新组件:
> AI Decision Layer。
未来的软件架构,也许不只是:
Code + LLM
而是:
Code + System One + LLM
各自负责自己最擅长的事情:
> LLM 负责想。
> System One 负责判断。
> Code 负责执行。
这可能才是 Jev 最值得关注的地方。
附:关于本地System One模型(Laya)
JEV之后涌现了大量的开源System One模型,尤其是本地的System One模型引起了极大的关注和讨论,因为这里模型的数据安全性更好,使用成本更低,且速度更快。
我实际测试了目前非常火热的本地System One 模型Laya。(在 M2 Mac 上测试了开源社区的 Laya / laya-mlx)。
在我的测试环境里,单次决策大约:
14–45ms。
而且完全本地运行。
实验一:英文情感分析
使用 GLUE SST-2 标准测试集。
872 条电影评论。
使用 Choice 进行零样本判断:
准确率约 92.4%。
概率排序质量:
AUROC 约 0.958。
这已经足够说明:它并不是只能做一个 Demo。
实验二:多语言工单路由
我又测试了:
中文
英文
日语
法语
德语
西班牙语
直接做工单部门路由。
结果:
约 88% 的请求可以直接分到正确部门。
至少从这个实验来看,一个小型 System One 模型已经可以承担相当一部分“理解文本 → 做一个明确判断”的工作。