更多AI前沿科技资讯,请关注我们:
【closerAI ComfyUI】低显存配置福音!MiniMax H3的速度与质量平衡的解决方案:minimaxH3-QuantFunc 4-bit模型安装与实测指南
MiniMax H3具备文生视频、首尾帧控制、全能参考以及原生音频生成能力,但模型规模很大。即使使用FP8或W4A8混合量化,8GB显卡仍然需要频繁在内存和显存之间搬运权重,生成时间通常较长。minimaxH3的加速方法有很多,其中4~8步加速LORA是主流方法之一。但是在这么多的加速LORA当中,质量与速度权衡有VDN技术。最近发布的 QuantFunc/Minimax-H3-Quantfunc-4bit,提供了一条新的低显存路线:不仅压缩模型权重,还通过专用CUDA推理引擎运行W4A4 INT4计算。
它是否真的有价值?8GB显卡能不能使用?本文介绍其技术特点、ComfyUI安装方法、工作流设置和使用限制。
一、QuantFunc H3是什么?
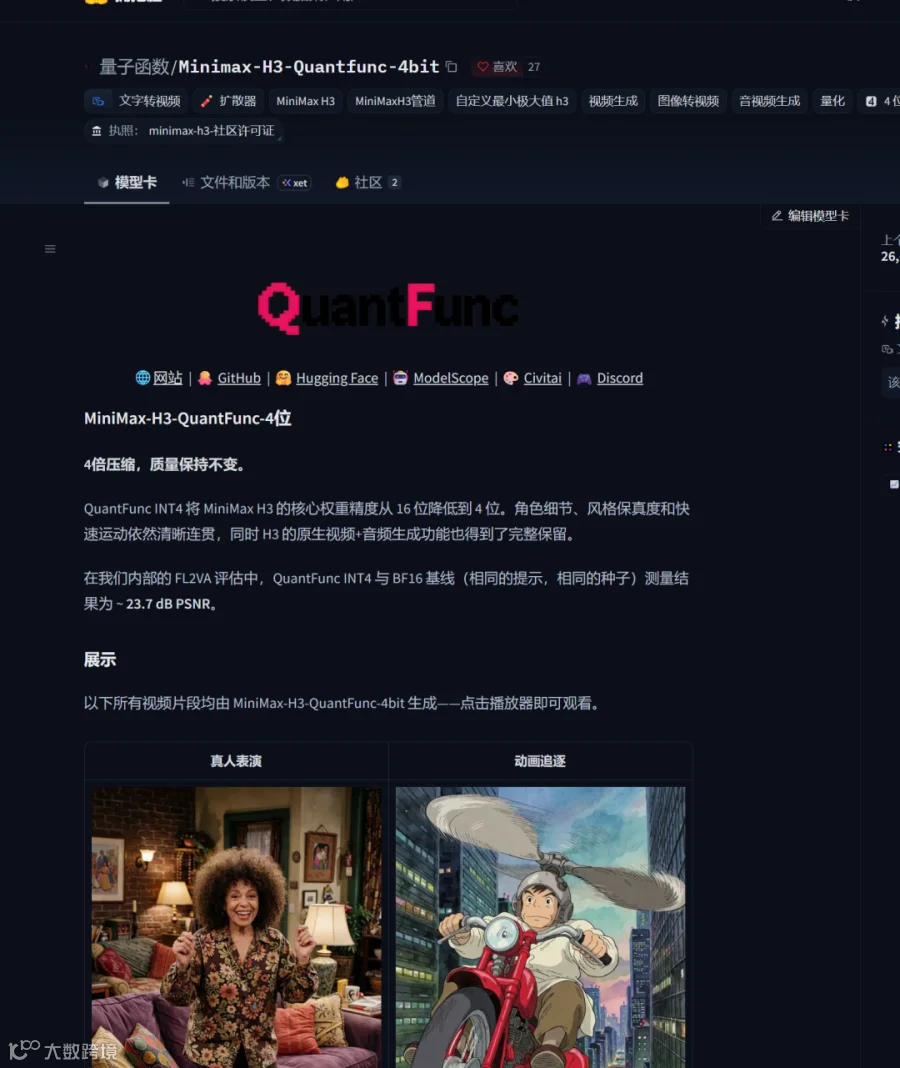
Minimax-H3-Quantfunc-4bit不是重新训练的全新视频模型,而是MiniMax H3的专用4-bit量化版本。
项目地址:https://huggingface.co/QuantFunc/Minimax-H3-Quantfunc-4bit
它采用:
-
INT4权重; -
INT4激活; -
SVDQuant低秩误差补偿; -
INT4 Token Refiner; -
INT8卷积Sidecar; -
专用C++/CUDA推理内核; -
融合后的LightX2V加速LoRA。
普通4-bit模型往往只是把权重压缩为INT4,运行时仍需要还原到FP16或BF16计算。QuantFunc采用W4A4,也就是权重和激活都使用INT4参与主要计算,理论上能够同时降低:
-
模型文件体积; -
显存占用; -
GPU计算量; -
权重传输量; -
低显存设备的CPU与GPU交换压力。
它的重点不是单纯“把文件压小”,而是模型格式和CUDA执行后端一起优化。
二、提供了哪些模型?
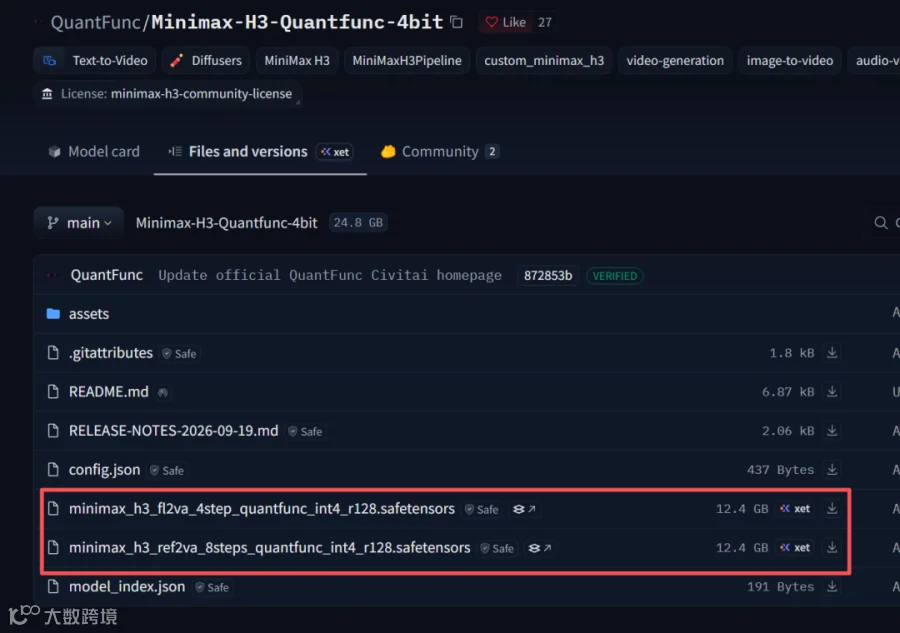
目前提供两个约12.37GB的模型。
1. FL2VA四步版本
文件名:minimax_h3_fl2va_4step_quantfunc_int4_r128.safetensors
支持:
-
文生视频; -
首帧图生视频; -
尾帧控制; -
首尾帧控制; -
原生视频与音频联合生成。
推荐使用4个采样步。
2. Ref2VA八步版本
文件名:minimax_h3_ref2va_8steps_quantfunc_int4_r128.safetensors
适合:
-
多张参考图; -
人物和场景参考; -
视频参考; -
音频参考; -
多模态全能参考生成。
推荐使用8个采样步。
两个模型都已融合对应的加速LoRA,不需要再添加普通H3四步LoRA、SLA
Turbo LoRA或FastH3 LoRA。
三、速度能提升多少?
QuantFunc官方在RTX 4090、768×768、124帧条件下公布的数据如下:
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
按照该结果:
-
相比INT8 ConvRot约快2.66倍; -
相比FP8约快3.19倍。
需要注意,这里统计的是Transformer核心推理时间,不包含:
-
文本编码; -
参考素材编码; -
Video VAE解码; -
Audio VAE解码; -
视频保存; -
长视频拼接。
因此,整条工作流的实际提速不会完全达到3.19倍。8GB显卡还会受到系统内存、PCIe传输速度和显存卸载策略影响。
这些数据目前主要来自官方测试,实际效果应以自己的设备和工作流为准。
四、安装ComfyUI-QuantFunc节点
下载节点:https://github.com/QuantFunc/ComfyUI-QuantFunc
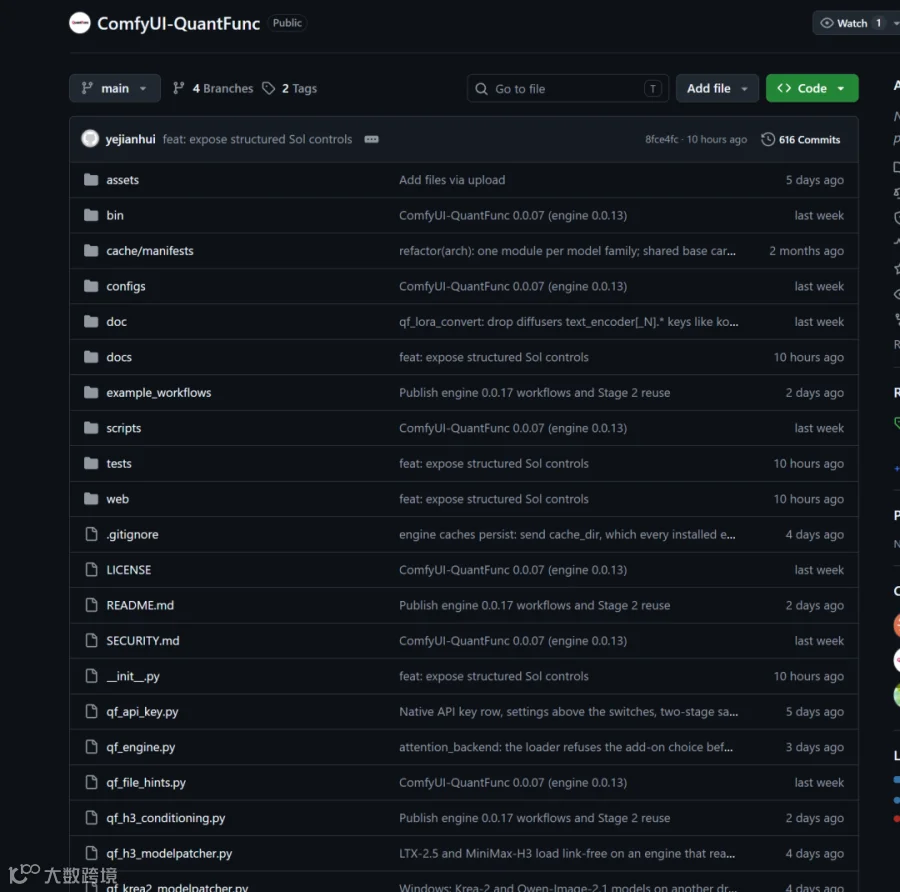
进入ComfyUI的自定义节点目录:ComfyUI/custom_nodes
执行:git clone https://github.com/QuantFunc/ComfyUI-QuantFunc.git
最终目录结构应为:
ComfyUI
└─ custom_nodes
   └─ ComfyUI-QuantFunc
重新启动ComfyUI。
首次启动时,插件会根据以下信息自动下载匹配的推理引擎:
-
Windows或Linux; -
PyTorch使用的CUDA版本; -
当前显卡SM架构; -
插件对应的引擎版本。
如果首次打开工作流提示引擎仍在下载,应等待控制台显示安装完成,然后重新执行工作流。
五、下载模型文件
按需求下载:minimax_h3_fl2va_4step_quantfunc_int4_r128.safetensors
或者:minimax_h3_ref2va_8steps_quantfunc_int4_r128.safetensors
放入:ComfyUI/models/diffusion_models
不要修改模型文件名。QuantFunc加载器会通过名称和元数据识别模型类型。
还需要准备MiniMax H3原有组件:
qwen3vl_32b_minimax_h3_int8_convrot.safetensors
minimax_h3_video_vae_fp16.safetensors
minimax_h3_audio_vae_fp32.safetensors
文本编码器放入:
ComfyUI/models/text_encoders视频和音频VAE放入:
ComfyUI/models/vae六、工作流
以下是其中的图生视频工作流,多参工作流同理,因为工作流很简洁。同时支持低配置显存设备实现二采放大而不爆!
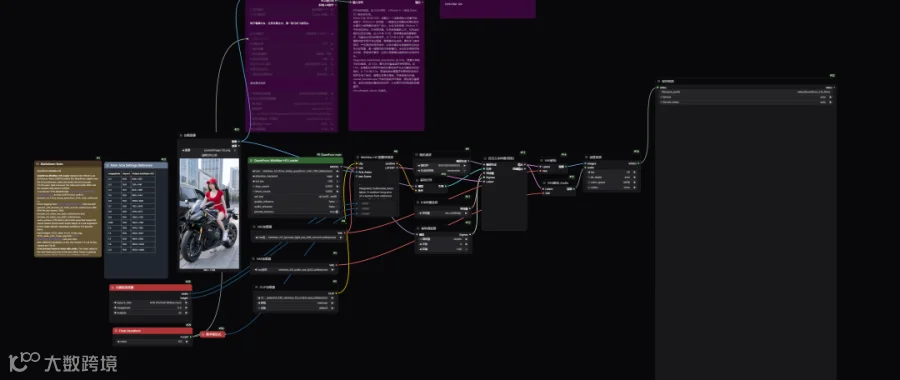
由于已经融合了很多LORA与修复技术,所工作流非常简洁,如上图所示。值得关注的是,这套方案工作流,让8G能生成1.0百万像素5秒的视频。更能让配置的设备生成长视频并保持质量。

quality_enhance
关闭:
-
速度优先; -
适合测试和预览; -
小物体、动作和人脸细节可能有所变化。
开启:
-
质量优先; -
人脸和局部细节通常更稳定; -
生成时间略有增加。
pinned_memory
开启后,模型会尽量使用锁页内存,提高CPU到GPU的传输效率。
audio_enhance
该功能会在普通采样结束后补充音频细化步骤,主要适合低步数模型。它不会重新生成视频画面,但会增加一些处理时间。双阶段采样工作流中可能不会生效。
七、总结
Minimax-H3-Quantfunc-4bit的意义,不只是发布了一个更小的模型文件,而是提供了一套完整的H3低精度推理方案:
-
W4A4 INT4计算; -
SVDQuant精度补偿; -
加速LoRA融合; -
Token Refiner量化; -
INT8卷积Sidecar; -
专用CUDA内核; -
低显存模型流送; -
保留视频和音频联合生成; -
支持FL2VA、Ref2VA和双阶段采样。
对于8GB显卡用户,它可能是目前较有潜力的MiniMax H3加速路线之一。但它并不是没有代价:专用格式、闭源引擎、授权体系以及一定的INT4质量损失,都需要使用者根据自己的需求权衡。
本地算力不够怎么办?
如果本地设备算力不好的小伙伴,推荐使用线上comfyUI来运行体验:runninghub.cn

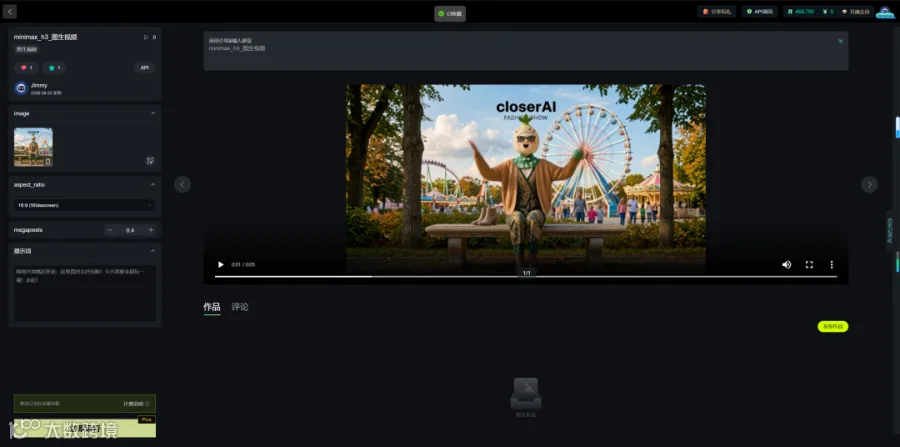
minimax_h3图生视频应用体验地址:https://www.runninghub.cn/ai-detail/2084286858103713794
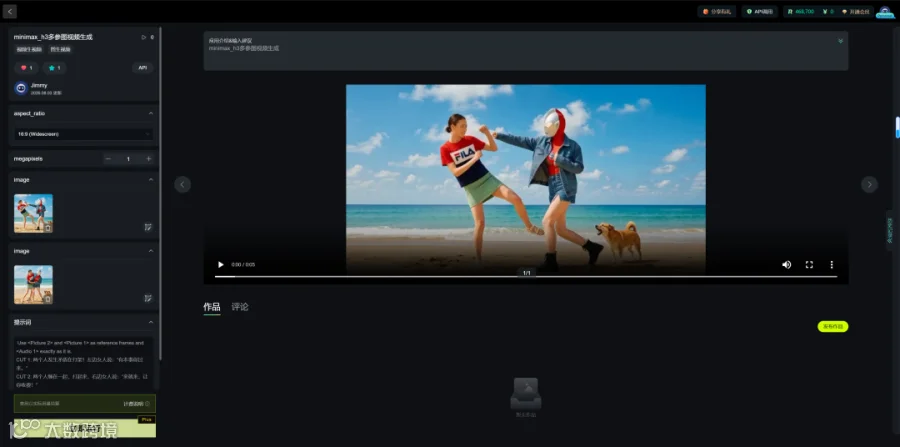
minimax_h3多参考视频生成应用体验地址:https://www.runninghub.cn/ai-detail/2084287787427262465
最后几句:
如果对你有帮助,请一键三连支持下我,感谢!以下是小站主流的一些AI工具应用:
CloserAI AI短剧工作台(本地化解决方案)
https://aigc.douyoubuy.cn/ai-agent/
closerAI FlowStudio本地AIGC无限画布创作工具
https://aigc.douyoubuy.cn/closerai-flowstudio/
closerAI AI绘画大师万象视界:
https://aigc.douyoubuy.cn/closerai-vision/
CLOSERAI POD电商印花批量生产工作站:
https://aigc.douyoubuy.cn/?page_id=420541
印花提取:
https://aigc.douyoubuy.cn/yinhua/
以上是就是本期的分享,当然,更多工作流、资讯、插件、工具也可以在我们closerAI会员站上获取(查看原文)。
以上,既然看到这里了,如果觉得不错,随手点个赞、在看、转发三连吧,如果想第一时间收到推送,也可以给我个星标⭐~谢谢你看我的文章,我们,下次再见。
>/ 作者:JimmyMo
更多AI前沿科技资讯,请关注我们: