


题目:Scaling Properties of Text Conditioning in Visual Generation
论文地址:https://arxiv.org/abs/2607.29679
代码地址:https://heheyas.github.io/context-scaling/
创新点
•首次揭示文生图条件文本的缩放规律,推翻 “单纯加长 prompt token 数量就能持续提升图像生成质量” 的固有认知,实验证明单纯增加自然语言文字长度反而会造成性能下降,真正符合 scaling 幂律的是提示词中结构化视觉信息含量,而不是 token 数量。
•提出两个可量化结构化信息的评估指标:白盒似然指标 GPG 与黑盒属性指标 ED,在控制变量训练中验证,收敛后的扩散损失随 GPG 近似线性下降、随 ED 满足幂律缩放关系,实现对提示词内可被图像模型利用信息的定量度量。
方法
本文以字节 Seed 图像生成模型为基础,围绕文本条件的缩放特性开展实验,先区分提示词 token 长度和提示词内结构化视觉信息这两个变量,设计可控数据集,分别用普通自然语言描述和结构化提示词 SP 做对照训练,同时构建 GPG 白盒似然指标与 ED 黑盒属性指标用来量化提示词中可供图像模型利用的有效视觉信息,在多组不同信息含量的文本条件下训练扩散主干模型,观测扩散损失随指标的变化趋势,验证幂律缩放关系,接着搭建提示生成器模块,采用监督微调完成冷启动,并引入验证器门控做在线蒸馏来优化提示的可提示性,在组合生成、空间推理、世界知识等多类图像评测基准上进行大量对比实验与消融实验,对比普通自然语言 prompt 和结构化提示词,以及提示生成器优化前后模型的生成效果,以此验证结构化信息才是图像生成文本条件缩放的核心,而非单纯增加 token 数量。
文本条件的缩放特性:token 长度、结构化信息与模型性能

本图由多张子图共同组成,左侧大图横轴是输入扩散模型的 caption token 长度,纵轴为 GSB 评测指标,用来对比不同模型随提示词长度变化的性能变化曲线,可以看到普通自然语言描述的基线模型在 token 变长后性能逐渐下降,而本文的结构化提示词方案,无论是零样本还是微调版本,都可以随着 token 增加持续提升生成性能,图中标注区分了 diffusability(可扩散性)与 promptability(可提示性)带来的增益;右侧四张小图进一步拆解内在规律,上方两张分别展示 GPG、ED 这两个信息指标随 caption token 长度的变化,蓝色结构化提示词的有效信息随 token 稳定上涨,红色自然语言提示词的有效信息增长很快陷入停滞,下方两张图展示扩散损失和 GPG、ED 指标的强相关关系,随着 GPG 与 ED 增大,扩散损失持续下降,自然语言提示词在低信息位置就不再继续提升,直观证明决定图像生成性能的不是提示词 token 数量,而是提示词内部结构化视觉信息含量。
结构化提示词 SP 的图像生成样例与可控编辑效果
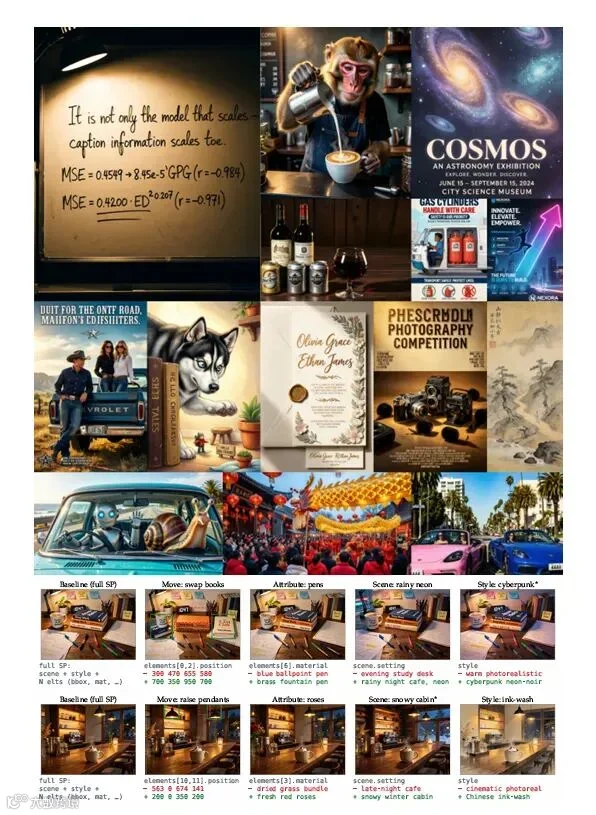
本图上半部分展示了多组使用结构化提示词生成的高质量图像样例,涵盖创意插画、写实摄影、海报、场景绘画等多种风格,左上角样例还标注了扩散损失 MSE 与 GPG、ED 指标的拟合公式和相关系数,直观展示 caption 信息与生成损失的强相关性;下半部分是两组结构化提示词的可控编辑对照实验,每组均保留基础完整结构化提示词 Full SP 作为基准图,随后只修改结构化描述里的指定字段,包括物体位置、物体属性、场景设定与画面风格,仅改动对应结构化字段就能精准实现图像局部修改,不会破坏画面其余部分,以此证明结构化提示词可以实现细粒度、解耦式的图像编辑,相比普通自然语言提示词,结构化字段能够让模型独立识别每个视觉要素,稳定完成对象、属性、场景、风格的单独操控。
整体系统框架:标注、训练与图像生成流水线

本图分为 Annotate 标注、Train 训练、Generate 推理生成三个阶段来展示整套系统流程,在 (a) 标注阶段,输入图像经由 VLM 与专家模块生成结构化提示词,再通过 GPG、ED 指标衡量提示词信息量,用来预测收敛后的扩散损失,以此验证结构化提示词相比普通自然语言提示词具备更高信息量与缩放特性;在 (b) 训练阶段,用户原始提示词送入 LLM 提示生成器转换为结构化提示词,再输入扩散模型生成图像,训练过程同时优化提示生成器的可提示性 promptability 与扩散模型的可扩散性 diffusability;在 (c) 推理生成阶段,流程和训练阶段保持一致,用户输入提示词经过 LLM 提示生成器转化为结构化提示词,直接送入扩散模型,实现单轮推理生成图像,完整展示了从数据标注、联合训练到上线推理的全链路方案。
实验
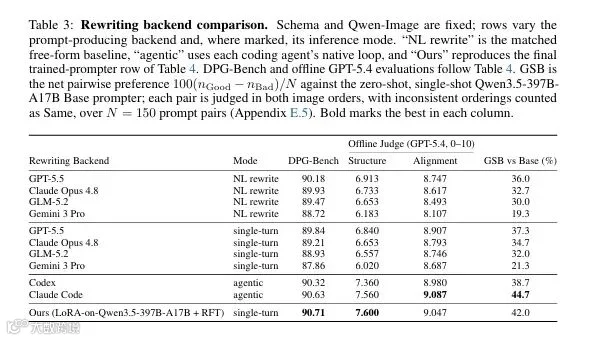
该表格固定结构化模式与 Qwen-Image 图像生成主干,只更换生成提示词的后端模型与推理模式,用来对比不同大模型作为提示改写后端的效果,实验分为自然语言改写 NL rewrite、单轮 single-turn、智能体 agentic 三种推理模式,评测指标包含 DPG-Bench、离线 GPT-5.4 评判的 Structure 结构化得分与 Alignment 对齐得分,还有 GSB 偏好指标,GSB 代表相对于基础 Qwen3.5-397B-A17B 提示器的成对偏好增益,评测在 150 组提示对上完成,每张样本会交换图片顺序进行双向判定,不一致的判定结果记为相同,从结果来看,agentic 智能体模式整体表现优于普通自然语言改写和单轮模式,Claude Code 在 agentic 模式下取得最高的 Alignment 分数,本文基于 Qwen3.5-397B-A17B 搭配 LoRA 与 RFT 训练得到的提示生成器,在单轮推理模式下取得很高的结构化得分与 GSB 增益,整体性能比肩顶尖闭源大模型 agentic 方案,证明自研提示生成器可以高效产出高质量结构化提示词。