大数跨境

WAM架构突然分叉:DreamX-Phi曾登顶、ForeWAM砍掉视频生成,机器人还需要“做梦”吗?

WAM架构突然分叉:DreamX-Phi曾登顶、ForeWAM砍掉视频生成,机器人还需要“做梦”吗? 机器人产业应用
2026-10-04
22
导读:机器人到底需要“看见未来”,还是只需要“理解未来”?


作者:余柯  


如果把今年上半年的具身智能比作一场“机器人到底该怎么学会干活”的争论,那么到了 8 月,争论突然具体了。

8 月 2 日,SG-WAM 把未来预测塞进具有几何约束的策略潜空间;8 月 5 日,DreamWAM 提出未来不能只看 RGB,还应该同时理解运动、几何和语义;8 月 12 日,ForeWAM 更进一步:训练时可以学视频,但机器人真正干活时,未来视频干脆别生成了。第二天,DreamX-Phi 1.0 上线,把另一条路线推到极致——既然要生成,就让视频尽量真的服从机器人手臂的三维运动。

几篇论文表面上都叫 WAM,做的事却已经越来越不像同一种东西。真正的分水岭正在出现:机器人到底需要“看见未来”,还是只需要“理解未来”?


01

WAM到底比VLA多了什么?一句话:多了一点“后果感”


传统 VLA——Vision-Language-Action——可以粗暴理解成:看见环境 + 听懂指令 → 直接输出动作。

比如桌上放着杯子,你说“把红杯子放到盘子里”,模型识别杯子和盘子,然后预测机械臂应该向哪里移动。这已经很强,但它有一个结构性的短板:模型非常擅长回答“现在该怎么动”,却未必真正建模“我这么动之后,世界会发生什么”。

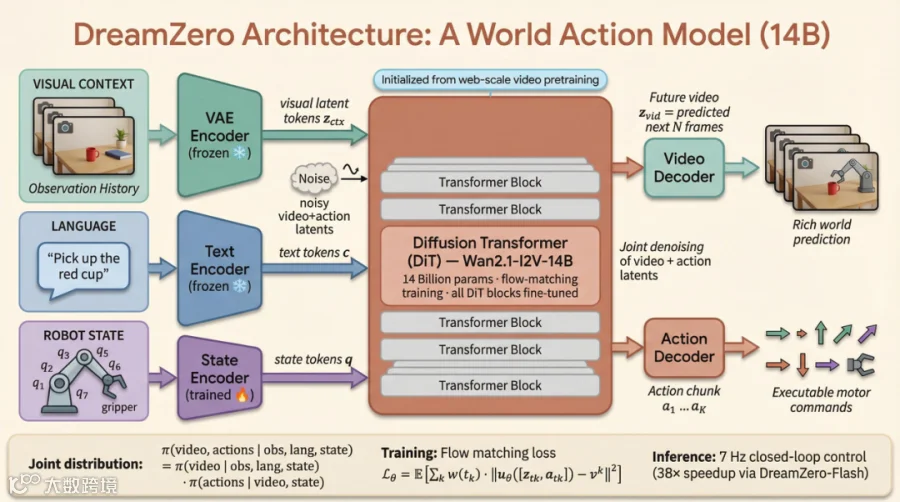
DreamZero 在提出 World Action Model 时,把这个区别说得很清楚:VLA 擅长语义泛化,却容易在从未见过的物理运动和新环境中掉性能;WAM 则把“未来世界状态”和“机器人动作”放在一起学习,通过视频获得运动、接触和物体变化的动态先验。

人其实也是这么干活的。伸手拿一个快倒的水杯时,大脑不是只识别“这是杯子”;你会下意识判断:手从这个角度碰过去,杯子会不会倒?夹爪夹太高会不会滑?拿起来以后水会不会洒?

VLA更像条件反射,WAM试图给条件反射装上一台“后果模拟器”。但麻烦也正是从这里开始的:这台模拟器到底应该模拟成什么样?


02

第一条路线:DreamX-Phi——既然要做梦,就把梦做得像物理世界


DreamX-Phi 代表的是最直观的一派:显式预测未来视频。给模型一张当前画面、语言指令,以及机械臂未来准备执行的动作轨迹,它直接生成“如果照这个轨迹执行,接下来的视频会变成什么样”。其底座是 Wan2.2-TI2V-5B。但普通视频生成模型有一个致命问题:

画面可以非常漂亮,动作却可能是错的。你让左机械臂向右移动,它可能生成一段“看起来很像机器人操作”的视频,却让右臂动了;机械臂明明抓住了瓶子,下一帧瓶子却凭空留在桌上。

对短视频模型来说,这可能只是一个小瑕疵;对机器人来说,这是物理规律被写错了。DreamX-Phi 的做法是把每条机械臂的 SE(3) 刚体变换——也就是三维位置和姿态——直接注入 Transformer 的注意力机制,再用深度分支约束场景几何,用 SAM3 找出正在操作的物体,用冻结的 V-JEPA 作为教师模型维持物体在抓取过程中的一致性。

换句话说,它不是只告诉视频模型:“机械臂往那边走。”而是尽可能告诉它:“左臂从这个三维坐标,以这个姿态,沿这条轨迹运动,同时夹爪在这里闭合。请让画面严格服从它。”

在 DreamX-Phi 论文采用的 8 月 12 日 WorldArena 2.0 快照中,它以 60.65 的 EWMScore-P 排在 31 个 Track 1 提交中的第一名,其中轨迹准确率达到 57.15,明显高于当时的 Alpha-World 和 FlowWAM。

但这里有个常被标题忽略的细节:DreamX-Phi 1.0 严格说还是 Forward Dynamics Model。

动作由外部给定,它负责预测执行动作以后世界会怎样,本身并不直接生成机器人动作。论文也明确把“未来联合生成视频和动作”列为后续方向。因此,与其说它已经是 WAM 的终极形态,不如说它把 WAM 的“W——World”这一侧推到了很远。


03

第二条路线:ForeWAM——机器人可以想未来,但没必要把它渲染成视频


ForeWAM 的思路几乎反过来。

它问了一个非常工程的问题:机器人真正需要的是未来,还是“未来的视频文件”?

扩散视频生成之所以慢,是因为模型需要从噪声开始,一步一步把未来画面去噪出来。对聊天机器人来说等一两秒没什么,对机械臂却完全不是一个概念——控制系统几十、几百毫秒就可能需要重新做一次判断。

于是 ForeWAM 设计了 Future-KV。推理时,它保留当前画面的视觉 latent,再往未来位置填入随机噪声,只让 Video DiT 跑一次 prefill。模型不把这些未来槽位继续去噪成视频,而是直接把每一层已经算出来的 Key/Value 状态缓存起来,交给 Action DiT 使用。

这很像一个人脑子里已经有了“杯子被推之后大概会往哪边走”的感觉,但并没有真的在眼前播放一段 4K 慢动作。

未来存在,但不再被渲染。为了防止这些 latent 最后学成一团没意义的特征,ForeWAM 又加入 Dynamics Registers,并用冻结的 latent-action teacher 在训练时告诉模型:哪些内部状态应该表示物体移动、接触改变和任务进度。

部署时,这个教师同样被扔掉。结果是,ForeWAM 在没有具身机器人数据预训练的情况下取得 LIBERO 96.7%,ForeWAM-Flash 为 96.9%;论文的测试配置中,标准版动作生成延迟约 568ms,Flash 进一步降至 220ms,并且策略参数约 2B。

所以,“ForeWAM砍掉视频生成”这句话没错,但还需要补半句:它砍掉的是推理阶段反复生成、解码未来视频的过程,不是把 Video DiT 整个扔了。世界模型还在,只是它越来越像机器人的“潜意识”。


04

第三条路线:DreamWAM——问题可能根本不是要不要视频,而是RGB承载了太多废话

DreamWAM 提出了另一个方向。一张 RGB 图片里,绝大部分信息其实跟机器人当前任务没关系。

机械臂要拿杯子时,桌布是深蓝还是浅蓝,墙上的光线亮了 20%,背景纹理换没换——对动作本身都不重要。

但如果训练目标只有 RGB 视频,模型必须花大量能力解释这些像素变化。

DreamWAM 因此把“未来”拆成四种互补信息:外观、运动、几何和语义。

RGB负责“长什么样”;光流负责“东西怎么动”;几何表示“东西在哪里、前后关系怎样”;语义则回答“哪个东西是什么”。训练时,这些信息共同塑造 VideoDiT,并通过共享注意力影响 ActionDiT。真正部署时,额外的 beyond-RGB 监督分支全部关闭。

效果最明显的地方,不是在普通 LIBERO,而是在场景被故意折腾之后。

DreamWAM 的 no-rollout 版本在 LIBERO-Plus 上从 RGB 基线的 51.36% 提升至 63.44%;联合视频—动作推理则从 69.16% 提升到 75.47%。真机遇到未见过的光照、背景和物体布局变化时,成功率从基线的 55.6% 提高到 74.4%。这组结果透露出的东西可能比“又一个 SOTA”更重要:

世界模型不一定需要把世界画得更像,它更需要留下那些真正决定动作的变量。


05

三条路线到底差在哪?


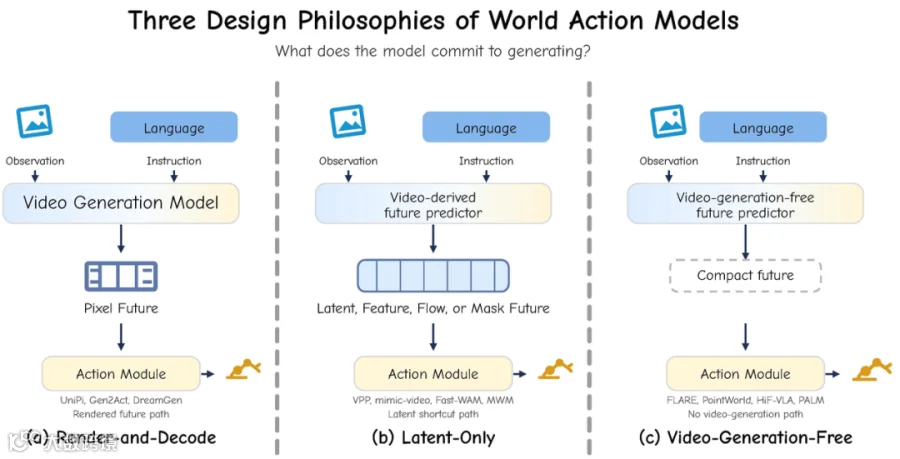
这里其实还有一个容易被忽略的事实:这三条路线并不真正互斥。

“是否生成视频”是推理架构问题;“未来用 RGB、深度、隐空间还是光流表示”是表征问题。

未来完全可能出现这样一个模型:训练时同时学习 RGB、深度、光流和语义;普通控制时只走隐空间快速通道;遇到高风险动作,再临时打开显式视频 rollout 做验证。这可能比押注某一条单一路线更接近技术终局。


06

为什么大家突然开始补空间和运动结构


换一个维度看:大家补的不是 RGB,而是空间与运动结构。前面二、三、四节,其实是按“推理时要不要显式生成未来视频”来分的:DreamX-Phi 选择显式生成,ForeWAM 选择不渲染,DreamWAM 选择拆监督。但 WAM 的分叉不止这一条。

如果把镜头从“推理架构”移到“未来表征”,会看到另一组代表:DreamX-Phi、SG-WAM、FlowWAM。它们不是另起三条互斥路线,而是从不同入口回答同一个问题:除了 RGB 像素,未来还应该用什么结构来表示?

DreamX-Phi 从机器人坐标入口补。它使用 SE(3) 刚体变换——也就是机械臂末端的三维位置和姿态——并把它注入 Transformer 的注意力机制,让生成画面尽量服从机械臂的真实运动。优势是“控制坐标系”非常明确,尤其适合双臂机器人精确执行。

SG-WAM 则从内部表征入口补。它不把未来先渲染成像素,而是把未来动力学直接预测在策略自身的隐空间里,再利用几何监督让这个空间获得空间结构。其 0.9B 模型在没有大规模具身预训练的情况下报告 LIBERO 98.5%、LIBERO-Plus 73%。

FlowWAM 从图像运动入口补。它不直接描述机械臂关节角,而是用光流描述图像中每个像素下一刻往哪里移动。光流本身和视频同构,而且可以直接从没有机器人动作标签的视频中提取,因此特别适合吃海量互联网视频。它在 RoboTwin Clean/Random 上分别达到 92.94% 和 92.14%,论文还报告 WorldArena EWMScore 63.71。

把三者放在一起看,趋势很清楚:纯像素不够用了。DreamX-Phi 补机器人坐标,SG-WAM 补策略潜空间几何,FlowWAM 补图像运动。它们入口不同,但都在做同一件事:别让模型只学“画面像什么”,还要学“空间和运动到底怎么组织”。

这也说明,WAM 正在经历一次很像自动驾驶早期的转变:一开始大家觉得摄像头看得够多,神经网络自己会学出来;后来才发现,看见三维世界和真正按照三维世界做事,中间还差一层结构。

补上这层结构,是 WAM 从视频生成走向机器人控制的关键一步。但它也带来下一节的问题:结构有了,为什么 WorldArena 里的“物理分”和控制精度仍然不漂亮?


07

为什么模型已经这么强,WorldArena里的“物理分”还是不漂亮?


DreamX-Phi 在 8 月 12 日快照拿第一时,总分只有 60.65。后来 WorldArena 2.0 更新 Dynamic Degree、Flow Score 和 Motion Smoothness 的评分方式并重新计算榜单,目前公开结果已经发生变化,FlowWAM-FiveAges 的 Track 1 总分达到 67.62。挑战赛本身也仍未结束。

所以“榜首只有60分”不能再当作当前事实。但它背后的问题依然成立。WorldArena 把视频质量拆成视觉质量、运动质量、内容一致性、物理遵循、3D准确性和可控性等维度,其中“Physics Adherence”直接考察 Interaction Quality (交互质量)和 Trajectory Accuracy(轨迹准确率)。

有意思的是,在目前公开表中,不少模型的 Depth Accuracy (深度准确率)已经能接近 0.9 甚至更高,Trajectory Accuracy(轨迹准确率)却往往只有 0.3—0.5 左右。翻译成人话就是:模型可能已经知道杯子在哪里、桌子有多深、场景长什么样,却仍然不能保证机械臂沿着精确轨迹把杯子送到那个位置。

因为“像物理”与“数值上 obey physics”完全不是一回事。视频生成模型擅长的是产生一个概率上合理的未来;机器人控制需要的却经常是毫米级位置、角度、接触时刻以及夹爪开合的确定性。

在视觉世界里,瓶子落点差三厘米还是一段不错的视频。在装配线上,差三厘米叫事故。这才是 WAM 接下来真正难啃的骨头。


08

ForeWAM会成为工业机器人的主流吗?      


很可能会影响主流,但不太可能“一统天下”。Fast-WAM 今年 3 月就给过一个很重要的实验信号:WAM的价值可能主要来自训练阶段学习未来,而不一定来自测试阶段真的把未来生成出来。它保留视频联合训练,却关闭测试时未来生成,论文报告约 190ms 推理延迟,比当时 imagine-then-execute WAM 快 4 倍以上。

ForeWAM 把这个思路继续推进:不是简单“不做梦”,而是把梦留在 KV Cache 和 dynamics latent 里。DreamWAM 则从另一边证明:训练时可以把监督做得越来越重,部署时再把辅助分支全部拆掉。

这两条线最终指向同一个工程原则:训练的时候尽量“重”,部署的时候尽量“轻”。

工厂机器人最关心的从来不是模型能不能生成漂亮视频,而是稳定、延迟、显存、功耗和故障率。能够把视频世界模型带来的物理先验保留下来,同时避免每个控制周期都跑完整视频 diffusion,这条路天然更适合进入真实设备。

不过,在机器人需要评估多个候选动作、做长时规划,或者希望工程师能够直接检查“模型认为接下来会发生什么”时,显式视频世界模型仍然有不可替代的价值。所以视频生成大概率不会消失。它可能只是从“每一步都跑”,变成“需要的时候再打开”。

09

传统VLA会被WAM替代吗?大概率不会,两个名字可能先消失一个


把 WAM 理解成“下一代 VLA”其实有点太简单。VLA 擅长的是语言、语义和开放世界知识;WAM补的是物理动态和结果预测。真正实用的机器人,需要两样都要。

未来更可能出现的不是:VLA → 被 WAM 淘汰。而是:VLM/VLA 负责理解任务和高层规划 + 世界动态表征负责预测后果 + Action Expert 负责输出连续控制。至于中间那套世界动态究竟表现为一段 RGB 视频、一组光流、一套3D latent,还是 ForeWAM 式 KV 状态,对最终用户可能根本不可见。

换句话说,WAM 的终局甚至可能不是“一个会生成视频的机器人模型”。它更可能变成机器人基座模型内部的一种训练原则和世界表征方式。机器人仍然会“想象未来”。只是未来最先进的机器人,可能再也不会把这个梦画给我们看。它只需要在真正伸手之前,知道这一伸手之后,会发生什么。


连界创新


推荐阅读


产业应用场景


·出海!中国具身智能企业在全球市场大“杀”四方!

·比人形更快进入家庭?具身智能宠物机器人迎爆发!

·文娱巨星!人形机器人“表演大乱斗”,谁赢了?

·商业导览成具身智能商业化破局点?

·巡检机器人之困,场景刚需,但这一问题亟待解决


机器人本体企业


·仿生机器人=伴侣机器人?一文为仿生机器人正名!

·乐聚Taskor,为人形机器人规模化进厂按下“快进键”

·具身智能争霸赛打响!四大核心区都有哪些“扛把子”?

·CES 2026|星动纪元携人形机器人家族亮相

·智元CES放大招!开源Genie Sim 3.0强的可怕!


供应链动态


·零部件企业跨界突围!这些企业上大分!

·夺取物理世界的入场券:具身智能操作系统拆解

·人形机器人关节生死局:执行器路线之争与技术博弈

·灵巧手赛道“激战”,新老玩家各执什么王牌?
·开源数据集图鉴!这份具身智能“军火库”请查收

【声明】内容源于网络
0
0
机器人产业应用
由连界创新具身智能中心发起,以场景应用为导向,专注具身领域科技与产业的链接。我们将围绕投资+服务双轮驱动,为科技增长赋能。业务涵盖垂直行业峰会/沙龙、私董会、标杆走访,具身智能行业研究报告与咨询,产业生态系统搭建等。
内容 580
粉丝 0
机器人产业应用 由连界创新具身智能中心发起,以场景应用为导向,专注具身领域科技与产业的链接。我们将围绕投资+服务双轮驱动,为科技增长赋能。业务涵盖垂直行业峰会/沙龙、私董会、标杆走访,具身智能行业研究报告与咨询,产业生态系统搭建等。
总阅读5.9k
粉丝0
内容580