

Agent 的终局:从模型能力到系统工程的演进
真正卡脖子的并非模型本身,而是包裹在模型之外的那套执行系统。它决定了 AI 能否将一项复杂任务从头至尾完整落地。
过去一年,“Agent”一词被广泛使用。随着模型能力提升、上下文窗口扩大以及 MCP(Model Context Protocol)成为连接外部系统的标配,理论上构建 Agent 应愈发容易。然而,在企业级实际落地中,开发者普遍面临“Demo 易做,生产难推”的困境:任务中断、工具调用失败、长上下文逻辑混乱、误操作风险以及故障归因困难等问题频发。
当前行业共识已逐渐从关注“哪个模型更聪明”,转向关注“如何让模型稳定地完成任务”。纵观 OpenAI、Anthropic 等头部团队的工程实践,Agent 正从单一的 AI 应用演变为一种全新的运行时环境。
01 Agent 的本质重构:从线性调用到执行系统
早期认知的局限
早期对 Agent 的理解较为朴素,链路通常为用户提问、模型解析、调用工具、返回结果。这种 User → LLM → Tool → LLM → Answer 的短链路在简单场景(如查询销售额)下表现良好。
但在真实业务场景中,需求往往具有复合性。例如,“找出华东区销售额同比下跌超 10% 的客户,分析原因并发送邮件提醒”。这要求 Agent 具备跨系统取数、数据判断、逻辑分析、权限检查及执行留痕的能力。此时,Agent 不再是一次简单的模型调用,而是一个微型软件系统在运行。
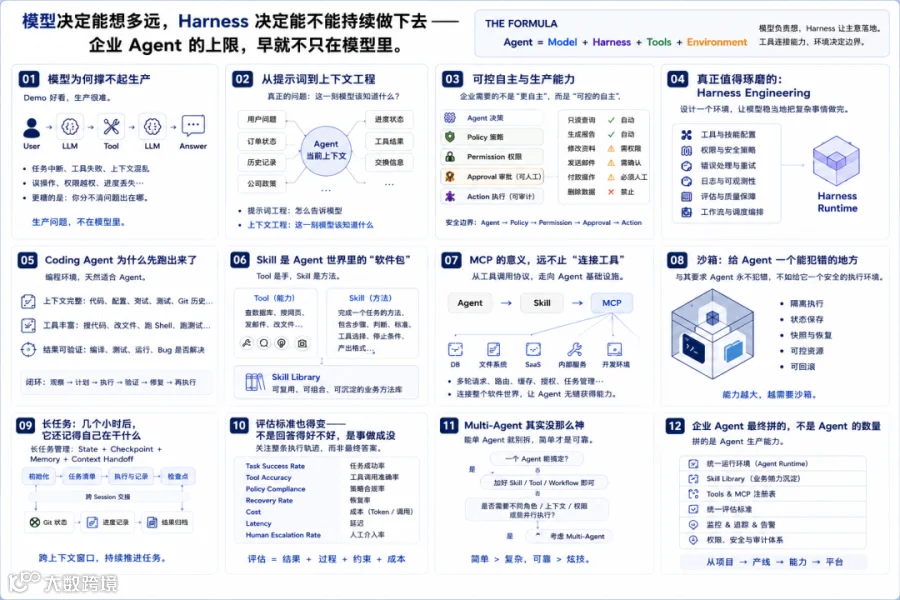
核心公式:Agent = Model + Harness + Tools + Environment
理解 Agent 需要一个更全面的视角:
- Model(模型):负责推理与决策。
- Harness(执行框架):包在模型外的执行系统,负责管理上下文、记忆、状态、权限、重试、检查点、沙箱及可观测性等。
- Tools(工具):外部能力的接口。
- Environment(环境):执行所需的上下文与资源环境。
OpenAI Agents SDK 的最新更新表明,基础设施的重心已从“如何调用模型”转向“如何运行模型”。Harness 承担着将模型意图转化为连续、可靠动作的关键职责。
02 关键工程要素解析
Coding Agent 为何率先突破
编程场景之所以成为 Agent 能力的最佳展示区,源于其具备三个核心条件:
- 上下文完整:代码仓库包含代码、配置、依赖、文档及 Git 历史,形成自洽的工作环境。
- 工具丰富:支持搜索、修改、编译、测试、日志查看等操作。
- 结果可验证:编译通过、测试达标、Bug 修复是客观标准,形成了“观察-计划-执行-验证-修复”的扎实闭环。
提示词工程让位给上下文工程
随着任务复杂度增加,单纯优化提示词(Prompt Engineering)已不足以支撑 Agent 运行。核心挑战转变为“模型在当前时刻应当知晓什么”。
上下文工程(Context Engineering)关注的是跨窗口的任务状态管理、进度交接及信息筛选。Anthropic 的实践表明,影响 Agent 持续工作能力的关键,在于如何高效管理长期任务中的状态流转,而非单次提示词的精美程度。
Skill:Agent 世界的“软件包”
需区分 Tool 与 Skill 的概念:
- Tool是基础能力(如查库、发邮件),相当于“手”。
- Skill是完成特定任务的方法论(如竞品分析流程、财务对账规范),包含步骤、判断标准及业务知识,相当于“方法”。
企业沉淀 AI 资产的重点,应从提示词转向构建可复用的 Skill Library。
MCP:从连接工具到连接世界
2026年发布的 MCP 新规范强化了无状态协议、路由、缓存及授权管理能力。MCP 的定位已从单纯的“工具调用协议”升级为“Agent 基础设施”,旨在解决 Agent 如何连接整个软件世界(数据库、SaaS、内部服务等)的问题。
未来架构可能呈现为:Agent → Skill → MCP → External Systems。
03 企业级落地的安全与稳定性
可控的自主:风险与边界
企业 Agent 与个人 Agent 的核心差异在于风险控制。企业需要的是“可控的自主”,即建立明确的安全边界:
Agent → Policy(策略) → Permission(权限) → Approval(审批) → Action(执行)
例如,查询数据可自动执行,但修改核心数据或对外付款必须经过人工审批或严格权限管控。
沙箱:隔离的执行环境
为防止 Agent 误操作破坏生产环境,沙箱机制不可或缺。通过提供隔离的执行环境、支持状态快照与恢复,确保 Agent 在犯错时不会造成不可逆的损失。这是传统软件工程测试思维在 AI 时代的延伸。
长任务处理:状态持久化
针对耗时数小时甚至跨天的长任务,模型无法始终停留在同一上下文窗口。成熟的 Agent 需具备 State + Checkpoint + Memory + Context Handoff 机制,确保任务中断后能基于上一轮的结果和状态继续执行,类似传统后台任务系统的断点续传。
04 评估体系与架构反思
评估标准的转变
Agent 的评估不应仅看最终答案,而应关注整条执行轨迹。关键指标包括:
- Task Success Rate:任务完成率。
- Tool Accuracy:工具调用准确率。
- Policy Compliance:合规与安全遵从度。
- Recovery Rate:故障自愈率。
- Cost & Latency:资源消耗与耗时。
- Human Escalation Rate:人工介入率。
Multi-Agent 的理性看待
多智能体(Multi-Agent)架构并非越复杂越好。每增加一个 Agent,都会带来通信、状态同步及错误处理的复杂度指数级上升。架构设计应遵循奥卡姆剃刀原则:若单 Agent 配合 Skill 和 Workflow 能解决问题,则无需强行拆分。真正的成熟架构是在满足需求前提下的极简主义。
结语:软件范式的反转
企业竞争的下半场,拼的不是 Agent 的数量,而是 Agent 生产能力——即构建统一运行时、技能库、工具注册表、监控评估及安全审计体系的能力。
软件交互正在经历一次根本性反转:从“人告诉软件如何操作”转变为“软件理解人的目标并代为执行”。Agent 不仅是传统软件上的聊天插件,更是重新定义软件使用方式的基础设施。
未来的核心议题,不再是“是否开发 Agent”,而是“哪些工作流值得被重构为 Agent 可稳定执行的任务”。这标志着我们从设计软件流程,迈向设计“让 Agent 工作的环境”。