


SenseVoice 专注高精度多语言语音识别、情感辨识和音频事件检测,支持超过 50 种语言识别,效果优于 Whisper 模型,中文与粤语提升显著。其推理速度比 Whisper-Small 快数倍,比 Whisper-Large 快十余倍。
针对网络上关于 SenseVoice 的各项数据传闻,经查阅官方 README、论文、ModelScope 模型页及 GitHub 接口数据,现将可追溯的官方信息与存在争议的数据进行梳理,以正视听。
核心结论:模型本身真实可靠,官方已于 2026 年发布补丁澄清早期夸大宣传。但在速度、参数量、训练数据量及许可证等方面,官方不同文档间存在口径差异,媒体转载时往往选取了其中某一版本,导致信息混乱。
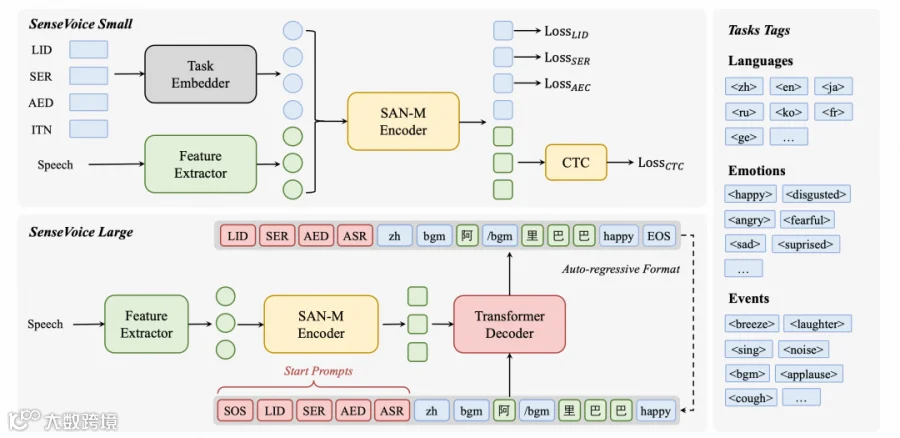
图:SenseVoice 官方主视觉(来源:SenseVoice 官方仓库,MIT)
一、核心功能与定位
根据官方 README 定义,SenseVoice 是一款具备音频理解能力的音频基础模型,集成了以下四大任务:
- 语音识别(ASR)
- 语种识别(LID)
- 语音情感识别(SER)
- 声学事件分类/检测(AEC/AED)
该项目归属于通义系开源动作之一,GitHub 仓库创建于 2024 年 7 月,目前挂在 QwenAudio 组织下。其技术架构为非自回归端到端框架,通过在语音特征前拼接 LID(语种)、SER(情感)、AED(事件)及 ITN(逆文本正则化)四个嵌入向量来指定任务。输出格式通常为标签前置形式,如 <|en|><|NEUTRAL|><|Speech|><|withitn|>。
官方提供了便捷的 WebUI,通过 python webui.py 即可启动。

图:SenseVoice 官方 WebUI 界面(来源:SenseVoice 官方仓库,MIT)
重要澄清:说话人分离并非 SenseVoiceSmall 模型的原生能力。演示中看到的“区分说话人”功能,实则是 FunASR 结合 FSMN-VAD 和 CAM++ 构建的 Pipeline 能力,而非该模型单独完成。
二、支持的情感、事件与语种
以下标签集合均源自官方 README,属于可严格核对的基础信息。
1. 情感标签(7类)
包括:<|HAPPY|>、<|SAD|>、<|ANGRY|>、<|NEUTRAL|>、<|FEARFUL|>、<|DISGUSTED|>、<|SURPRISED|>。此外还有 emo_unk 表示情感未定。部分媒体报道仅列举了前四种,遗漏了后三种,易造成误解。
2. 音频事件标签(8类)
包括:<|BGM|>、<|Speech|>、<|Applause|>、<|Laughter|>、<|Cry|>、<|Sneeze|>、<|Breath|>、<|Cough|>。
3. 语种标签(5类)
当前公开模型支持:<|zh|>(中文)、<|en|>(英文)、<|yue|>(粤语)、<|ja|>(日文)、<|ko|>(韩文)。
在情感识别方面,官方在 CREMA-D、MELD 等 7 个数据集上进行了评测,并提供了复现脚本,展现了较高的透明度。在事件检测方面,虽然在 ESC-50 等数据集上与 BEATs、PANNs 进行了对比,但官方明确指出:受限于训练数据,其事件分类效果与专业事件检测模型仍有差距,不建议完全替代专用模型。
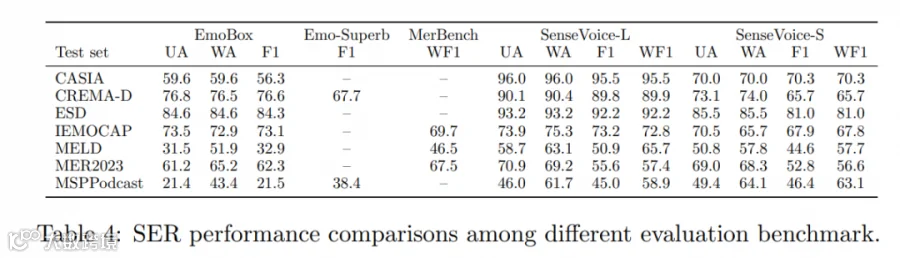
图:官方情感识别结果表(来源:SenseVoice 官方仓库,MIT)
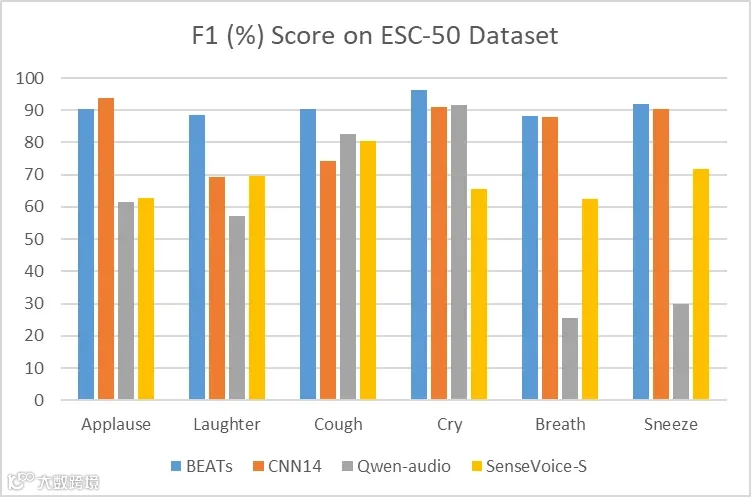
图:官方音频事件检测对比(ESC-50)(来源:SenseVoice 官方仓库,MIT)
三、速度与性能:官方数据的差异
关于推理速度,官方不同渠道给出的数据存在不一致,需仔细甄别。
- GitHub README 与论文:指出 SenseVoiceSmall 推理速度比 Whisper-Small 快 5 倍以上,比 Whisper-Large 快 15 倍。
- ModelScope 模型页:声称比 Whisper-Small 快 7 倍,比 Whisper-Large 快 17 倍。且同一页面内同时出现了“15 倍”和“17 倍”两种表述。
其中,“10秒音频推理耗时 70ms”的数据源自论文 Table 7(RTF 0.007),这一具体数值是可信的。因此,关于“快几倍”的说法,取决于引用的文档版本。媒体转载时多采用 ModelScope 的较高数值,读者在引用时应注明出处。

图:官方推理效率对比(来源:SenseVoice 官方仓库,MIT)
四、参数量与语种范围的真相
1. 参数量 234M
官方 README 和 ModelScope 仅表述为“与 Whisper-Small 相当”。具体数字 234M 仅出现在论文 Table 7 中,与 Whisper-Small 的 224M 确实处于同一量级。
2. 语种范围:5种 vs 50+种
这是一个常见的混淆点。
- 开源模型(SenseVoiceSmall):仅支持中、粤、英、日、韩 5 种语言。
- 研究模型(SenseVoiceLarge):支持 50+ 种语言,但该模型并未开源。
官方在 2026 年澄清指出:“40万小时/50+语种”是整体研究项目的训练数据规模,而用户可下载的 Checkpoint 仅支持 5 种语言。此外,训练数据量在 README(40万小时)与论文摘要(30万小时)中也存在表述差异,建议以最新更新的 README 为准,或同时引用两者。
关于“中文与粤语提升 50% 以上”的说法,经查证仅见于部分媒体报道,官方文档中仅有“明显效果优势”的定性描述,并无具体百分比数据。

图:官方多语言 ASR 结果对比(来源:SenseVoice 官方仓库,MIT)
五、许可证与商用规则
许可证问题极易产生合规风险,需特别注意代码与权重的区别。
- 代码:遵循 MIT License。
- 权重:遵循 FunASR 模型开源协议。虽然 ModelScope API 返回字段显示为 Apache-2.0,但这与官方说明不符,应以 README 和模型卡为准。
针对 FunASR 协议中“仅供参考和学习”的条款,官方已明确澄清:允许商业使用官方 SenseVoiceSmall 权重,该条款仅为免责声明。但使用时必须遵守署名要求,保留模型名称。自行微调后的衍生权重可保持私有。需注意,此澄清仅适用于官方权重,第三方转换版本(如 GGUF)需单独核实其条款。
六、生态现状与应用
截至 2026 年 10 月 3 日,SenseVoice 在 GitHub 上拥有近万 Stars,ModelScope 下载量突破 6000 万次,显示出极高的实用价值。约 940 MB 的模型体积使其在轻量级应用中具备优势。
社区生态方面,已有多个优秀的第三方适配项目:
| 项目 | 特点 |
|---|---|
| Triton + TensorRT | GPU 部署加速,支持 fp16 |
| sherpa-onnx | 支持 10 种编程语言,覆盖 iOS/Android/树莓派等多平台 |
| SenseVoice.cpp | 基于 GGML 的纯 C/C++ 推理,支持多比特量化,无依赖 |
| streaming-sensevoice | 通过截断注意力实现伪流式推理,牺牲少量精度换取实时性 |
| OmniSenseVoice | 轻量推理库,支持 Batch 推理 |
此外,仓库地址已从 FunAudioLLM/SenseVoice 迁移至 QwenAudio/SenseVoice,旧地址虽设有重定向,但部分资源链接可能失效,建议开发者直接使用新地址。