搜索
首页
大数快讯
大数活动
服务超市
报告
跨企查
广告开户
APP
产业带
导航
知识体系
工具箱
产业园
更多
百科
找货源
跨境招聘
DeepSeek
首页
>
#内存学习 16|GDDR和DDR有什么区别?为什么GPU不直接使用普通DDR?
>
#内存学习 16|GDDR和DDR有什么区别?为什么GPU不直接使用普通DDR?
检芯外贸手札
2026-10-03
16
导读:DDR 服务 CPU,讲容量和通用性;GDDR 服务 GPU,讲带宽和并行。GPU 为什么带宽敏感、GDDR 怎么从 DDR 分化出来、单颗 x32 显存如何并行出 256-bit/512GB/s、为
前面我们讲了 LPDDR。LPDDR 和普通 DDR 虽然都属于 DDR 技术体系,但因为手机、平板等移动设备对功耗、尺寸和带宽有特殊要求,所以逐渐形成了一条针对移动平台优化的路线。到了 GPU,问题又发生了变化。GPU 并不是特别需要一块“容量很大的普通内存”,它更在意的是:能不能在很短的
时间
里,把大量数据持续送到 GPU。
这就是 GDDR 出现的背景。
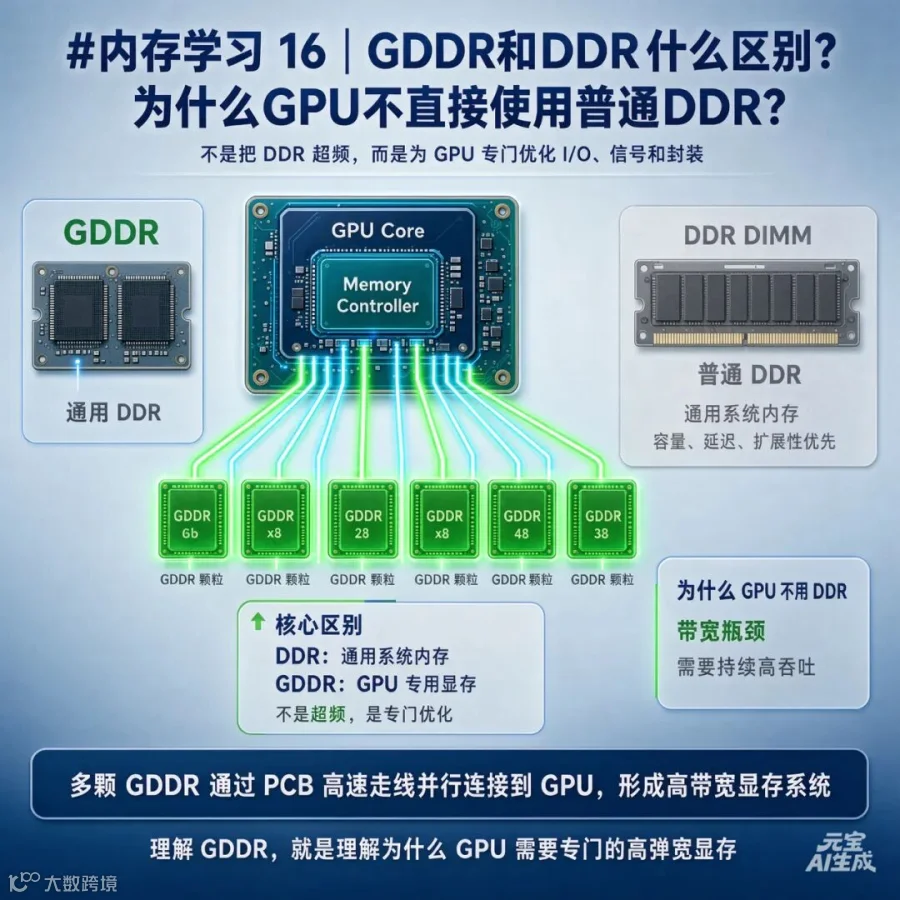
GDDR 的全称是 Graphics Double Data Rate,通常称为图形双倍数据速率存储器。它与 DDR 都属于 DRAM 家族,在存储单元的基本原理上并没有发生根本变化,但随着图形处理能力不断提高,普通 DDR 的设计方式越来越难以满足 GPU 对高带宽的需求,于是内存厂商开始针对图形处理进行专门优化,逐渐形成了 GDDR 这条独立的 Graphics DRAM 演进路线。
GPU为什么特别需要内存带宽?
CPU 和 GPU 都需要内存,但它们的工作方式并不完全一样。CPU 更擅长处理复杂、变化多的任务,经常需要根据前面的计算结果决定下一步做什么,因此除了性能,也非常关注响应时间和通用处理能力。
GPU 则更适合大量并行计算。比如一张高分辨率图片包含大量像素,需要同时进行颜色、纹理、光照等计算,GPU 可以利用大量计算单元并行处理这些任务。问题是,计算单元越多,需要同时读取和写入的数据也越多。
这些数据从哪里来?就是显存。
GPU 在工作过程中,需要不断读取纹理、像素、顶点、帧缓冲以及各种计算数据。如果 GPU 的计算能力不断提高,而显存提供数据的
速度
没有同步提高,那么计算单元就可能因为等待数据而无法充分发挥作用。
因此,GPU 的性能不能只看计算核心数量和频率,还要看 Memory Bandwidth,也就是内存带宽。简单来说,就是单位时间内显存能够向 GPU 提供多少数据。
这和 CPU 的系统内存需求形成了一个很重要的区别。CPU 当然也需要带宽,但它面对的是更加复杂和通用的任务;GPU 则经常需要大量相似的数据同时流动。对于 GPU 来说,“数据能不能持续送过来”本身就可能成为性能瓶颈。
GDDR是怎么从DDR发展出来的?
既然 GPU 需要这么高的带宽,为什么不能直接使用普通 DDR 呢?
并不是说普通 DDR 完全不能给 GPU 使用,而是如果按照普通 DDR 的设计思路去满足高端 GPU 的带宽需求,系统会越来越困难。提高内存带宽,最直接的办法有两个:一个是提高每个数据引脚的数据传输速度,另一个是增加数据通道,让更多数据同时传输。高性能显存实际上会同时利用这两个方向。
普通 DDR 需要在容量、延迟、模块化、扩展性和系统兼容性之间取得平衡,而 GPU 更关注大量数据能否持续、高速地传输。因此,GDDR 并不是简单地把普通 DDR “超频”,而是在 DDR 类技术基础上,针对图形处理的工作方式,对 DRAM 的 I/O、信号、电压、内部数据通路以及与 GPU 的连接方式进行专门优化。
GDDR 的产生过程,其实就是 GPU 性能不断提高以后,内存带宽逐渐成为瓶颈的过程。
早期图形处理相对简单,显存需要处理的数据量没有今天这么大。随着 3D 图形的发展,纹理、像素、光照和几何数据越来越复杂,GPU 的计算能力也不断提高,于是出现了一个越来越明显的矛盾:GPU 计算得越来越快,但内存不一定能够同样快地把数据送过来。
因此,内存厂商开始针对图形应用优化 DRAM。早期 GDDR 与 DDR 技术关系非常密切,之后随着 GPU 性能不断提升,逐渐形成 GDDR2、GDDR3、GDDR4、GDDR5、GDDR6 等连续的产品路线。它们虽然不断采用新的接口和信号技术,但解决的问题始终比较明确:让 GPU 能够获得更高的显存带宽。
所以,GDDR 中的“Graphics”非常重要。它并不是因为 GPU 需要一种完全不同于 DRAM 的存储原理,而是因为 GPU 使用 DRAM 的方式与普通 CPU 系统不同,需要一套专门针对高带宽场景优化的 Memory Interface。
GDDR颗粒和普通DDR颗粒有什么不同?
理解到这里,很容易产生一个疑问:既然 GDDR 和 DDR 都属于 DRAM,那么显卡上的 GDDR 颗粒,是不是其实就是普通 DDR 颗粒,只是工作频率更高?
不是。
两者在最基本的存储原理上都属于 DRAM,但一颗 DRAM 芯片并不只有“存储阵列”。可以简单把它理解成两部分:里面负责保存数据的存储阵列,以及负责与外部系统通信的 I/O、命令地址和相关外围电路。
真正让不同类型 DRAM 形成差异的,很大一部分就在这些外围电路和接口体系上。
普通 DDR 需要
服务
于 CPU、内存控制器、DIMM、插槽以及整个 PC 或服务器系统,需要在容量、延迟、扩展性、功耗、信号完整性和兼容性之间取得平衡。GDDR 则从应用场景出发,更强调高速 I/O 和持续的数据吞吐,需要让 GPU 周围的多颗显存能够并行工作。
因此,GDDR 颗粒并不是把普通 DDR 颗粒简单提高频率后得到的产品。它的 I/O 设计、数据传输方式、内部数据通路、工作电压以及封装和连接方式,都针对高速图形显存进行了优化。
这一点也可以从“x8、x16、x32”这样的数据组织方式看出来。
我们前面讲普通 DDR 时提到过 x4、x8、x16。这里的“x8”并不是说芯片内部只有8个存储单元,而是表示数据 I/O 的宽度。例如一颗 x8 DRAM,可以理解为一次通过8个数据 I/O 传输8 bit数据。
GDDR 同样存在类似的数据组织方式,但具体接口宽度和代际设计并不能直接套用普通 DDR 的规则。因此,看到两颗芯片都标注16Gb,也不能认为它们就可以互换。
例如,一颗16Gb DRAM理论上可以存储:
16Gb ÷ 8 = 2GB
但这只说明它们的存储密度可能相同,并不能说明它们的 I/O、数据速率、电压、命令地址接口、时序和封装都相同。
也就是说:
容量相同,不代表芯片相同;都是DRAM,也不代表可以直接替换。
这对实际看料号非常重要。以后看到一颗三星、SK hynix 或 Micron 的 Memory 芯片,不能只看最后的“8Gb、16Gb、24Gb、32Gb”,还需要确认它究竟属于 DDR、LPDDR、GDDR 还是其他 Memory 产品线,再进一步确认 Organization、I/O、Speed、Voltage、Package 等参数。
从外观上也不能简单判断。一颗普通 DDR DRAM 和一颗 GDDR DRAM 都可能采用 BGA 类封装,单独拿出来看,外形甚至可能比较接近。真正可靠的方法还是看完整料号和 Datasheet。
一颗GDDR到底怎样和GPU连接?
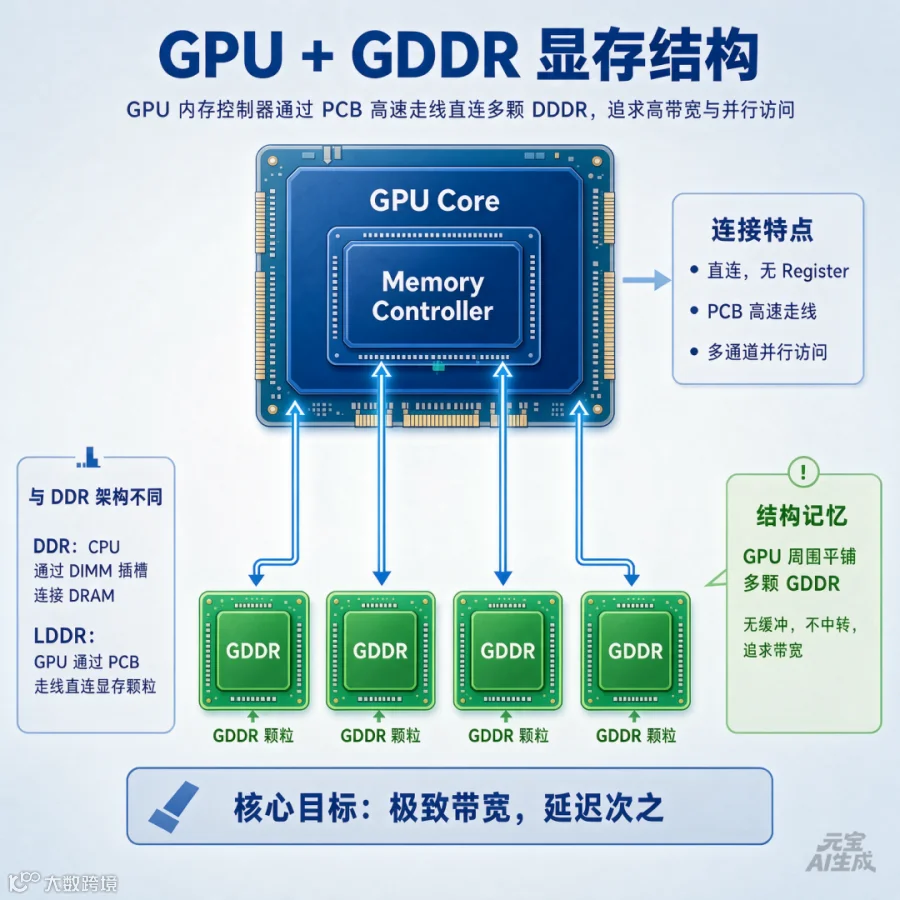
理解了 GDDR 颗粒本身的区别,还需要进一步看它是怎么工作的。显卡上的 GDDR 并不是一颗颗串起来工作的,而是由 GPU 内部的 Memory Controller 分别管理。
也就是说,基本关系是:
GPU ↔ PCB高速走线 ↔ GDDR
而不是:
GDDR ↔ GDDR ↔ GDDR
每一颗 GDDR 都通过 PCB 上的高速走线与 GPU 连接。GPU 内部的 Memory Controller 负责向这些显存发出命令、地址和时序信号,同时接收或发送实际的数据。
一颗 GDDR 与 GPU 之间,并不只有数据线。通常可以把相关信号简单分成几类:DQ 是数据线,DQS 是数据选通信号,CA 用于命令和地址,CK 是时钟,另外还有电源和地等连接。不同 GDDR 世代的具体接口定义会有所不同,但基本任务都是一样的:告诉 GDDR“访问哪里、做什么操作、按照什么节奏传输”,然后把真正的数据高速传递给 GPU。
因此,当 GPU 要读取显存中的数据时,并不是 GPU 直接去“碰”某一个 DRAM 存储单元。Memory Controller 首先发出相应的命令和地址,GDDR 根据地址找到对应的 Bank、Row、Column 等位置,再通过内部的 Sense Amplifier 和数据通路把数据送到 I/O,最后通过 PCB 高速走线传回 GPU。
写入数据则反过来:
GPU → PCB高速走线 → GDDR I/O → 内部数据通路 → DRAM存储阵列
从这里可以看到,GDDR虽然最终也是把数据存放在 DRAM 单元中,但从 GPU 发出访问请求,到数据真正进入或离开存储阵列,中间经过了完整的 Memory Interface。
多颗GDDR如何形成高带宽?
理解了单颗 GDDR 的工作方式,就可以理解为什么一张显卡通常需要多颗 GDDR。假设一颗 GDDR 的数据接口为 x32,数据速率为 16Gb/s per pin,那么它的理论带宽就是:
16Gb/s × 32 ÷ 8 = 64GB/s
如果 GPU 同时连接8颗这样的 GDDR,那么总数据位宽可以达到:
32 × 8 = 256 bit
理论总带宽就是:
16Gb/s × 256 ÷ 8 = 512GB/s
因此,显卡规格中看到的
256-bit Memory Interface
,并不是说某一颗 GDDR 本身就是256-bit,而是 GPU 同时连接多颗显存后形成的总数据位宽。每颗 GDDR 都提供自己的数据通道,多个通道并行工作,最终形成整个 GPU 的显存带宽。
这就是 GDDR 的一个重要特点:
单颗高速 + 多颗并行 + 较宽总接口
而这种设计也决定了 GDDR 为什么通常直接焊接在 GPU 周围,而不是做成普通 DDR 那样的 DIMM 内存条。
GDDR到底是怎样提高带宽的?
理解 GDDR,还需要掌握一个非常实用的关系:
内存带宽 ≈ 数据传输速率 × 总数据位宽 ÷ 8
例如,一颗 GDDR 器件的数据接口是 x32,每个数据引脚的数据速率是 16Gb/s,那么理论带宽就是:
16Gb/s × 32 ÷ 8 = 64GB/s
如果显卡使用8颗这样的显存,并行连接到 GPU,那么理论总带宽就可以达到:
64GB/s × 8 = 512GB/s
这也是为什么我们在显卡规格中经常看到 192-bit、256-bit、320-bit、384-bit 这样的数字。它们描述的是 GPU 与显存之间的数据接口总宽度。
例如 256-bit 就相当于32 Byte的数据通道。如果显存数据速率为16Gb/s,那么理论带宽就是:
16Gb/s × 256 ÷ 8 = 512GB/s
所以以后看到一张显卡的显存参数时,可以同时关注
两个东西:显存数据速率和显存总位宽
。两者共同决定理论显存带宽。
这也解释了为什么 GDDR 不能简单理解成“把普通 DDR 的频率提高”。如果只是不断提高速度,功耗、信号完整性等问题都会越来越明显;如果只是增加位宽,又会增加显存颗粒数量、PCB 走线和系统成本。因此实际的 GDDR 演进,需要同时考虑速度、位宽、功耗、信号和封装。
显卡上的 GDDR 通常不会像普通 DDR 那样做成可以插拔的内存条,而是直接
焊接在
GPU 所在的 PCB 上,并尽可能缩短 GPU 与显存之间的高速连接路径。原因很简单:当信号速度越来越高以后,连接距离、PCB 走线以及连接器都会影响信号
质量
。
GDDR 的发展也不仅仅是不断提高频率。到了更高速的显存,信号传输方式本身也开始发生变化。例如 GDDR6X 引入了 PAM4,也就是四电平信号技术。传统二
进制
信号可以简单理解为两个电平,对应0和1;PAM4使用四个电平,使一个符号能够携带2 bit信息,因此可以在不简单把信号频率翻倍的情况下,提高每个引脚的数据传输能力。
这说明高速 Memory 的发展已经不只是“把频率做高”,而是逐渐涉及内部数据通路、高速 I/O、信号编码、PCB 和封装等整个系统。
GDDR和普通DDR,究竟有什么区别?
把前面的内容放在一起看,两者的区别就比较清楚了。
普通 DDR 更像是面向通用计算系统的系统内存,需要兼顾容量、延迟、扩展性、模块化和系统兼容性。GDDR 则是面向高带宽数据吞吐的专用显存,更强调高速 I/O、较高的数据传输速率,以及 GPU 与显存之间的大量并行数据传输。
因此,GPU 不直接使用普通 DDR,并不是因为普通 DDR “不够先进”,而是因为两者解决的问题不同。普通 DDR 是为了让 CPU 等通用处理器方便、高效地使用系统内存;GDDR 则是为了让 GPU 在进行大量并行计算时,能够持续获得足够的数据。
如果用一个简单的比喻来理解,普通 DDR 更像一个综合仓库,而 GDDR 更像一条专门为大型数据运输设计的高速
物流
通道。两者都在运输数据,但面对的工作方式不同。
不过,GDDR 的路线也并不是没有限制。
如果 GPU 的计算能力继续提高,想要获得更高的显存带宽,就需要不断增加显存数据速率、接口数量以及 PCB 上的高速连接规模。但 PCB 空间、功耗和信号完整性都会逐渐成为新的限制。
于是,Memory 又出现了另一种思路:不再只是把更多 DRAM 颗粒平铺在 GPU 周围,而是把 DRAM 垂直堆叠起来,再通过先进封装让 Memory 与 GPU 更紧密地连接。
这就是 HBM 出现的重要背景。
从 DDR 到 LPDDR、GDDR,再到 HBM,并不是简单的一代代“升级关系”,而是针对不同计算平台和不同需求形成的几条 Memory 路线。
DDR解决通用系统内存问题,LPDDR重点解决移动设备的功耗与带宽平衡,GDDR重点解决 GPU 的高带宽需求,而 HBM 则进一步通过 DRAM 堆叠和先进封装,把内存带宽推向更高水平。
下一篇,我们继续讲 HBM。重点不只是知道 HBM 是“高带宽内存”,而是要弄清楚一个更重要的问题:
为什么把 DRAM 一层一层堆起来,就能够解决 AI GPU 对超高内存带宽的需求?
#往期回顾
#内存学习 15|LPDDR4、LPDDR4X、LPDDR5、LPDDR5X 为什么越来越重要? #内存学习 14|UDIMM、RDIMM、LRDIMM到底有什么区别?——服务器内存为什么要加“Register”? #内存学习 13|DDR5已经有On-Die ECC,为什么还需要ECC内存?——芯片内部纠错,和系统级ECC不是一回事 #内存学习 12 DDR5为什么把PMIC放到内存条上?——从供电到内存电源管理
【声明】内容源于网络
0
0
检芯外贸手札
1234
内容
214
粉丝
0
关注
在线咨询
检芯外贸手札
1234
总阅读
8.1k
粉丝
0
内容
214


 检芯外贸手札