

从共识比例推断喜好强度:
消费者为何会高估多数人偏好选项的优势
——中国营销工程与创新研究中心2026-2027年第一学期第4次研讨会
2026年9月28日9:00,中国营销工程与创新研究中心(以下简称“MEI”)2026-2027年第一学期第4次研讨会(以下简称“Seminar”)在MEI如期举行,参与本次研讨会的有黄敏学老师及MEI各位成员。
本次Seminar由李云芝研读文章《People Believe If 90% Prefer A over B, A Must Be Much Better than B. Are They Wrong?》。

一、研究内容
在产品盲测、酒店选择、赛事预测和选举民调中,人们经常通过“有多少人更偏好某一选项”来了解他人的评价。例如,90%的人偏好A而非B,既容易表达和传播,也能成为社会认同的依据。作者在 Journal of Consumer Research 2025年发表的研究中指出,消费者往往会进一步推断:既然绝大多数人选择A,那么A应该比B好很多。然而,共识比例只描述偏好方向,并不直接说明每个人在喜好程度上的差异有多大。
现有研究已经解释了消费者如何依据已知线索推断未知属性,以及他人选择为什么能够影响判断,但较少检验从共识信息推断喜好强度是否准确。本文的核心问题是:消费者是否会从共识比例中高估喜欢程度的差异?这种推断能否被纠正,并进一步影响后续选择?
作者将“偏好A的人更多”与“平均而言更喜欢A多少”区分开来,并利用理论模拟与真实评分数据建立比较基准。研究提出,消费者没有充分认识到小差异通常比大差异更常见,因此会高估多数人偏好选项的相对优势。这种推断不仅影响对他人评价的估计,还会改变消费者自己的选择,而展示真实的差异分布可以减弱这一偏差。研究同时强调,何种信息更有用取决于决策目标,共识信息与平均评分不能相互替代。
二、文献综述
研究首先界定了几个关键概念。偏好(Preference)表示个体会选择哪个选项;喜好(Liking)是对选项的连续评价;同一人对两个选项的喜欢程度之差被称为喜好差异(difference in liking)或相对喜好(relative liking);共识(Consensus)是偏好多数人所选选项的人数比例。评分差同时包含偏好方向和强度,但二选一选择只保留方向。因此,90%偏好A并不能唯一决定A与B的平均评分差,甚至不能保证A的平均评分一定更高。
从形式上看,若p = P(LA > LB)表示偏好A的比例,则平均喜好差异为Δ = E(LA − LB)。正差异的比例不能识别差异的大小或总体均值。消费者通常会根据已知维度的大小及其与未知维度的关系进行推断,例如由价格推断质量。由于共识与喜好差异之间存在正向关系,消费者可能把两类信息视作近似替代品,却忽略了给定共识水平下不同差值的相对可能性。
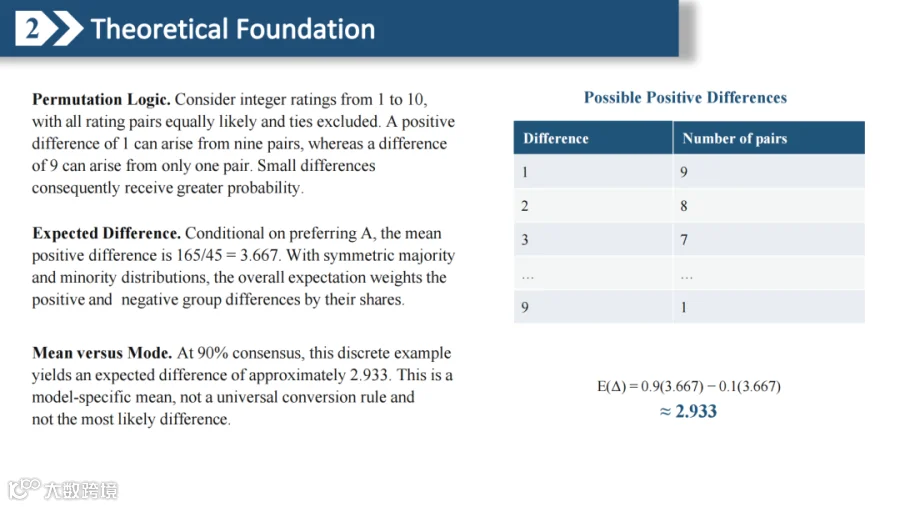
作者通过组合逻辑说明小差异为何更常见。在1–10整数评分组合等可能且排除平局的设定下,产生1分正差有9种组合,而9分差只有1种组合,因此小差异会获得更高概率。在偏好A的条件下,平均正差异为165/45 = 3.667。若假设多数和少数群体分布对称,则整体期望根据正负群体差异的份额加权。在90%共识下,该离散示例得到约2.933的期望差异,即E(Δ) = 0.9(3.667) − 0.1(3.667) ≈ 2.933。但作者特别强调,这是特定模型下的均值,不是普遍换算规则,也不是最可能的差异。
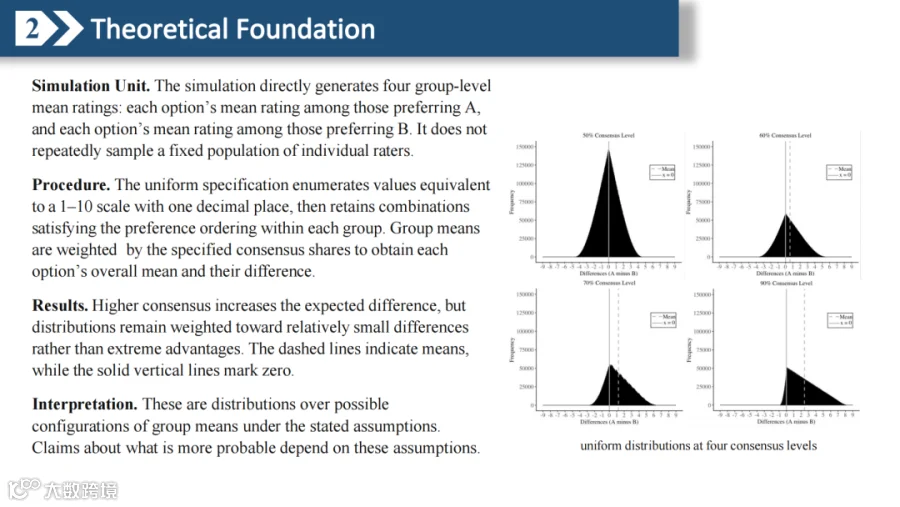
模拟进一步表明,更高共识确实会提高期望差异,但差异分布仍倾向于相对较小的差异,而非极端优势。允许小数评分而非仅整数评分对总体模式影响很小,说明小差异更常见并不只依赖于整数标度。截断正态分布使极端评分更不可能;正群体内相关倾向于更小差异,负相关则增加更大差异,但在所测试的强负相关设定中,平均差异仍然相对较小。
研究也指出边界条件:当偏好呈现明显的爱—恨结构,即各群体强烈喜欢其偏好选项并强烈不喜欢另一选项时,大差异可能变得更常见。因此,证据支持的是在所测试设定下的稳健性,而非无分布定理;共识本身不能唯一识别实际平均差异。
相对既有社会认同研究,本文进一步提出,消费者可能不仅跟随多数人的选择,还会夸大多数人的偏好强度。核心预测并不是90%共识时的估计高于60%共识时,而是在同一共识水平下,相对于可比较基准,消费者估计的差异过大。
三、研究概览及总体设计
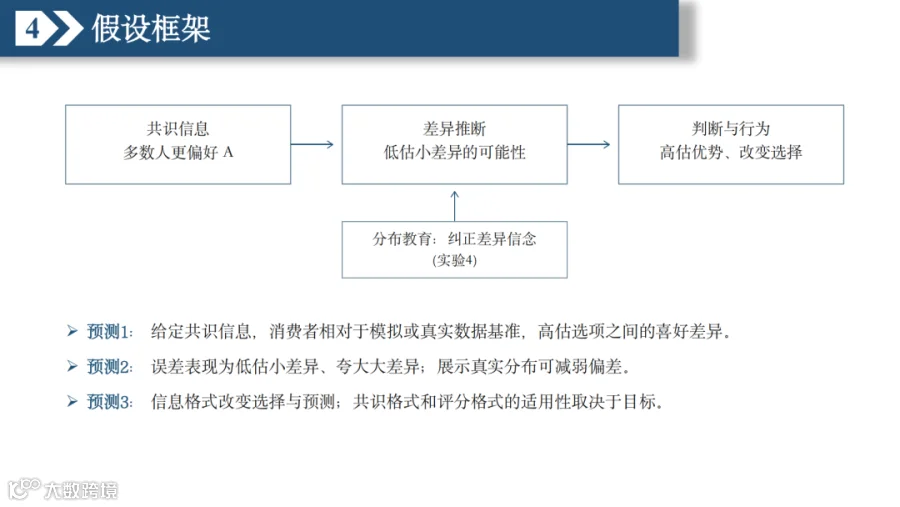
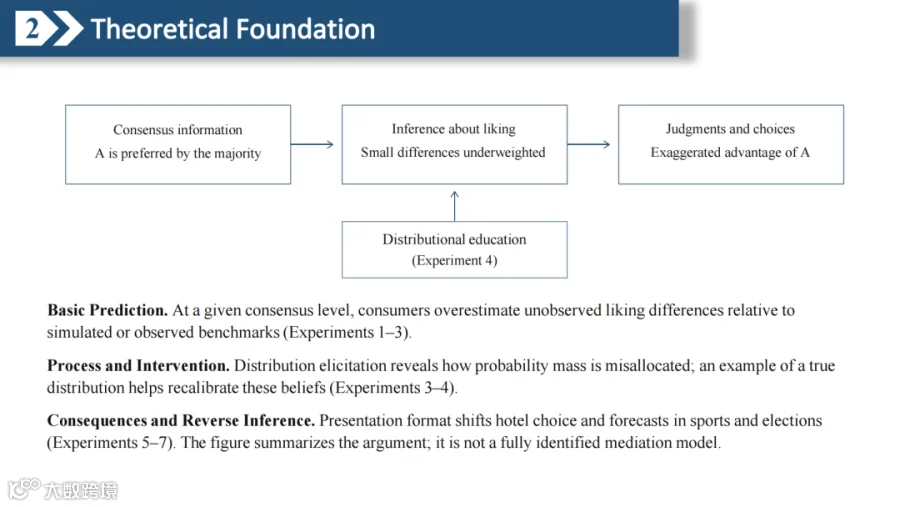
研究提出三项预测。预测1:给定共识信息,消费者相对于模拟或真实数据基准,会高估选项之间的喜好差异。预测2:误差表现为低估小差异、夸大大差异;展示真实分布可以减弱偏差。预测3:信息格式会改变选择与预测;共识格式和评分格式的适用性取决于决策目标。
总体框架为:共识信息表明多数人更偏好A,进而引发低估小差异可能性的差异推断,最终导致高估优势和改变选择的判断与行为,而分布教育被用于纠正差异信念。汇报PPT明确注明,该框架图是对论证的总结,而不是完全识别的中介模型。
论文采用七项预先注册实验,分别覆盖基于模拟和真实数据的检验、对完整分布信念的引出、纠偏干预,以及对酒店选择、体育预测和选举预测的影响。实验概览显示:实验1为两组随机实验,N=86;实验2为两阶段研究,N=499/402;实验3为组内设计,N=200;实验4为两组随机实验,N=300;实验5为三组随机实验,实际N=451;实验6为两组随机实验,有效N=368;实验7为两组随机实验,N=600。
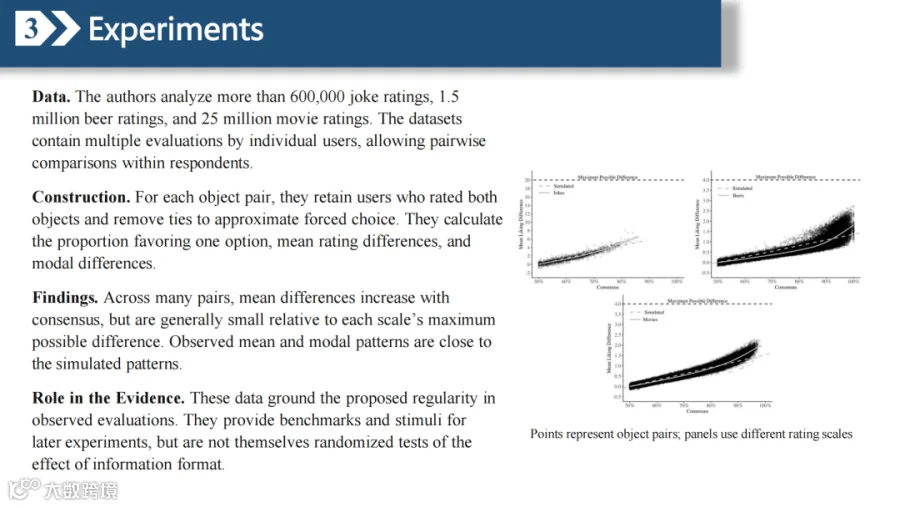
作者还分析了超过600,000条笑话评分、150万条啤酒评分和2500万条电影评分。这些数据包含同一用户的多次评价,因而可以在受访者内部进行成对比较。对每个对象对,研究保留同时评价过两个对象的用户,剔除平局以近似二选一,并计算偏好比例、平均评分差和众数差异。结果发现,在许多对象对中,平均差异随共识上升,但相对于量表的最大可能差异通常较小;观察到的平均和众数模式与模拟模式接近。这些真实数据为后续实验提供基准和刺激,但其本身不是对信息格式效应的随机化检验。

四、研究工具与判断基准
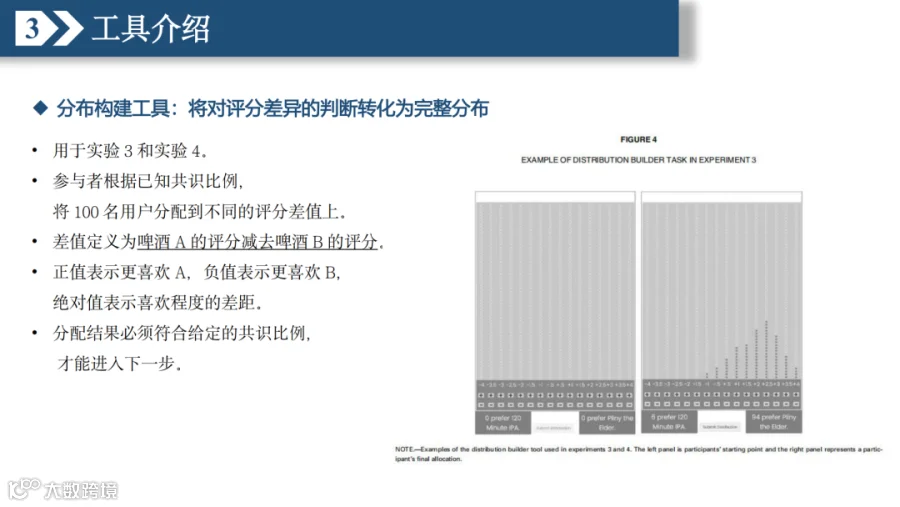
实验3和实验4使用了分布构建工具。参与者根据已知共识比例,将100名用户分配到不同的评分差值上。差值定义为啤酒A评分减去啤酒B评分,正值表示更喜欢A,负值表示更喜欢B,绝对值表示喜欢程度差距。分配结果必须符合给定的共识比例,才能进入下一步。
研究从每位参与者构建的分布中提取五项指标:平均差异、众数差异、众数对应差值的概率、最小正差值概率,以及最大差值概率。在啤酒任务中,最小正差值为0.5分。
基准构建方式为:从真实啤酒评分差分布中,在保持对应共识比例的条件下抽取100名用户,重复10,000次。分类规则是,估计超过对应基准分布第95百分位记为高估,低于第5百分位记为低估。
五、实证分析
(1)Study 1:模拟葡萄酒评分中的共识推断
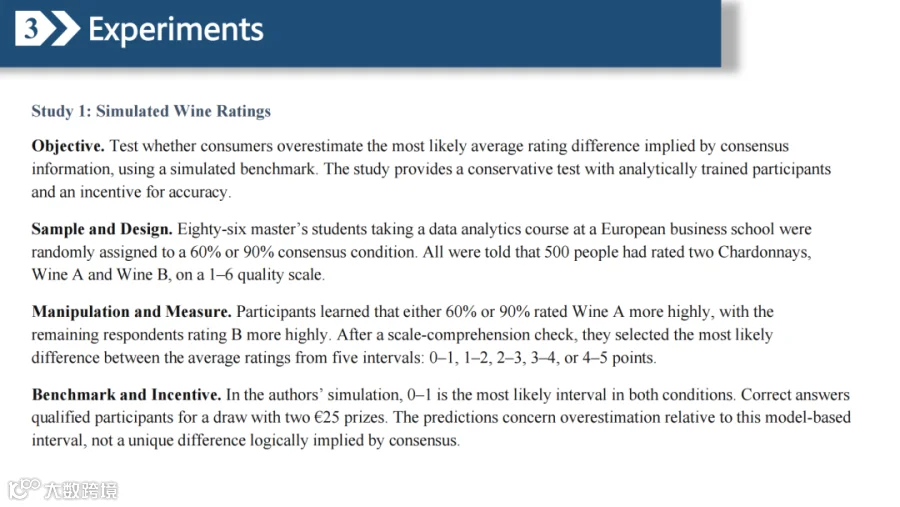
Study 1的目的是检验消费者是否会高估共识信息所暗示的最可能的平均评分差。研究使用模拟基准,并招募具有分析训练背景的参与者和设置准确性激励,构成较保守的测试。86名欧洲商学院修读数据分析课程的硕士生被随机分配到60%或90%共识条件。所有参与者被告知500人曾用1–6质量量表评价两款霞多丽葡萄酒A和B。参与者得知60%或90%的人对葡萄酒A评价更高,其余受访者对B评价更高。在完成量表理解检查后,他们从五个区间(0–1、1–2、2–3、3–4、4–5分)中选择最可能的平均评分差。
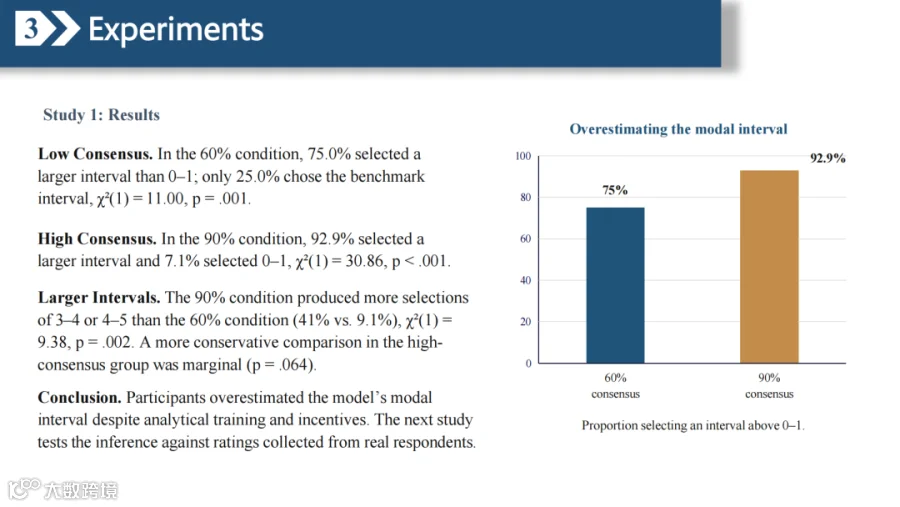
在作者模拟中,0–1分是两种条件下最可能的区间。正确答案可使参与者获得两张25欧元奖金的抽奖资格。结果发现,在60%共识条件下,75.0%的人选择了大于0–1的区间,只有25.0%选择基准区间,χ²(1) = 11.00,p = .001。在90%共识条件下,92.9%的人选择大于0–1的区间,7.1%选择0–1,χ²(1) = 30.86,p < .001。90%共识条件比60%条件产生了更多3–4或4–5的选择,比例为41%对9.1%,χ²(1) = 9.38,p = .002;高共识组中一个更保守的比较则为边际显著,p = .064。因此,尽管参与者具有分析训练且存在激励,仍然高估了模型的众数区间。
(2)Study 2:真实评分与个人先验
Study 2使用观察到的基准重复检验高估现象,并考察形成个人评价是否有助于消费者推断他人的评分差。阶段1中,作者招募501名Prolific参与者,保留499名。参与者以随机顺序阅读两则笑话,选择更好笑的一则,并以1–10量表为两则评分。61%选择笑话A;观察到的差异分布中位数为1,众数为2;只有14名参与者给出相同评分。
阶段2中,另一样本402名Prolific参与者进入控制组或先读后评组。控制组只收到61%对39%的共识信息;先读后评组先阅读并评价两则笑话,然后收到同样的共识信息。两组都在−9到9量表上估计最可能的评分差。研究预注册原本提出以中位数作为较保守基准,但中位数低于众数,因此报告分析使用更保守的众数2,这是对预注册的公开偏离。
结果显示,控制组中81.2%的估计高于观察众数2,先读后评组中77.5%如此,两个比例均超过50%(ps < .001),但组间比例差异不显著,p = .429。平均众数估计方面,控制组为4.24,先读后评组为3.80,两者均超过2(ps < .001),而组间差异不显著,t(400) = 1.44,p = .150。也就是说,在此实验中,阅读和评价笑话并未显著减少高估。作者强调,这一零比较并不证明先前经验永远没有帮助,补充研究Study S1报告了一定程度的减弱。
(3)Study 3:分布信念的引出
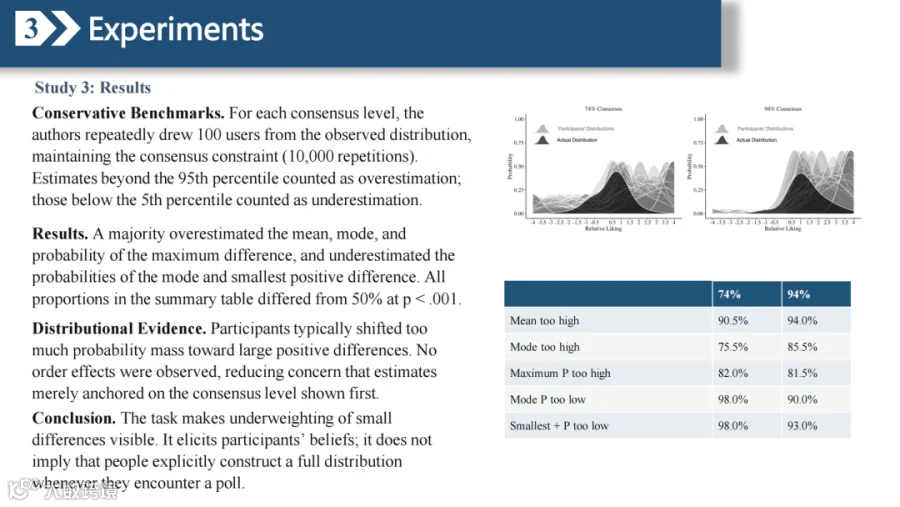
Study 3的目的是引出对评分差异的完整信念,而不是单一的点估计。200名Prolific参与者完成两个共识条件,呈现顺序随机化。74%共识对为Old Rasputin对Fat Tire Amber,有638名配对评分者;94%共识对为Pliny the Elder对120 Minute IPA,有601名配对评分者。评分使用1–5量表,增量为0.5。对每个啤酒对,参与者将100名用户分配到可能的评分差上,正值和负值分配必须复现所述共识。与实际数据匹配的分布可获得20美分奖金。
作者提取每位参与者的均值、众数、众数概率、最小正差概率和最大差概率,以识别概率质量被错误分配的位置。对每个共识水平,作者从观察分布中反复抽取100名用户并维持共识约束,共进行10,000次重复。估计超过第95百分位计为高估,低于第5百分位计为低估。
结果显示,大多数人高估了均值、众数和最大差概率,低估了众数概率和最小正差概率,所有比例均以p < .001与50%存在差异。在74%共识条件下,均值过高90.5%、众数过高75.5%、最大差概率过高82.0%、众数概率过低98.0%、最小正差概率过低98.0%。在94%共识条件下,均值过高94.0%、众数过高85.5%、最大差概率过高81.5%、众数概率过低90.0%、最小正差概率过低93.0%。参与者通常把过多概率质量转移到大的正差异上,且未观察到顺序效应。作者指出,该任务揭示的是参与者的信念,并不意味着人们每次遇到民调时都会明确构建完整分布。
(4)Study 4:分布教育的纠偏作用
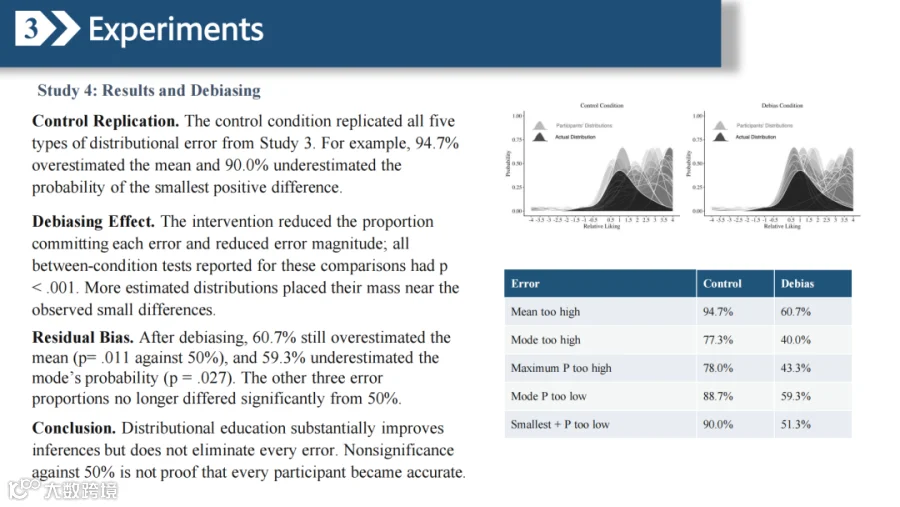
Study 4检验学习真实差异分布的形状是否能减少消费者在随后推断另一啤酒对的分布时的错误。300名Prolific参与者被随机分配到控制组或纠偏组。两组都为与Study 3相同的94%共识啤酒对构建分布。纠偏组在目标任务之前看到Trois Pistoles对Maudite的正确分布,这是一个50%共识的独立啤酒对。该分布近似对称,随着差异远离零,频率递减。作者预测,该示例可以教导小差异的普遍性,而不是直接提供目标答案,因此成功学习应改变推断分布的形状,而不仅仅是把对称分布向右移动。
控制组复制了Study 3中全部五类分布错误,例如94.7%高估均值,90.0%低估最小正差概率。纠偏干预降低了每类错误的犯错比例和错误幅度,报告的所有组间比较均p < .001。但纠偏后残余偏差仍然存在:60.7%仍高估均值,与50%相比p = .011;59.3%低估众数概率,p = .027。控制组与纠偏组的具体错误比例分别为:均值过高94.7%与60.7%,众数过高77.3%与40.0%,最大差概率过高78.0%与43.3%,众数概率过低88.7%与59.3%,最小正差概率过低90.0%与51.3%。因此,分布教育显著改善推断,但并未消除所有错误,相对于50%不显著也不能证明每个参与者都变得准确。
(5)Study 5:共识信息与酒店选择
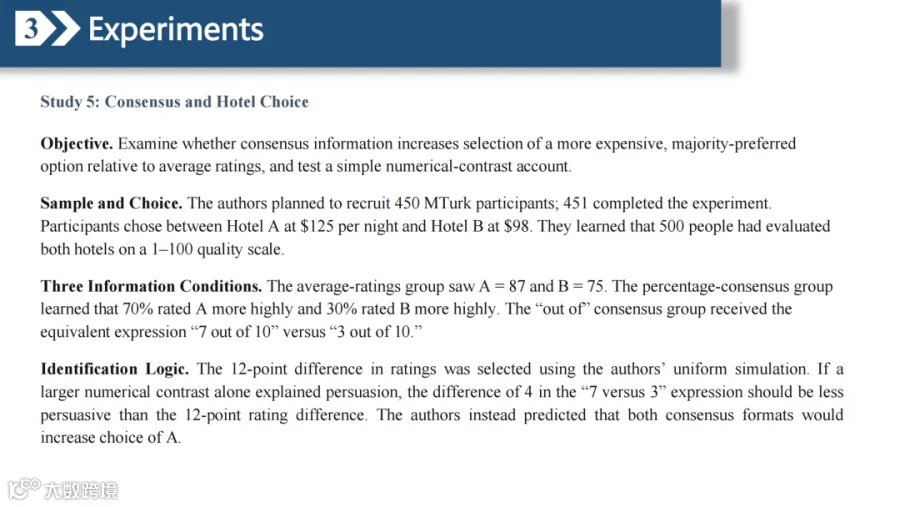
Study 5检验共识信息是否相对于平均评分提高对更昂贵、多数人偏好选项的选择,并检验简单数字对比解释。作者计划招募450名MTurk参与者,451人完成实验。参与者在每晚125美元的酒店A与每晚98美元的酒店B之间选择,并得知500人曾用1–100质量量表评价过两家酒店。平均评分组看到A=87、B=75;百分比共识组得知70%认为A评分更高,30%认为B更高;“out of”共识组收到等价表述“10分之7”对“10分之3”。
识别逻辑是,12分的评分差使用作者均匀模拟选取。如果较大的数字对比本身就能解释说服效应,那么“7对3”表述中的4分差应比12分评分差更弱。研究者反而预测两种共识格式都会增加对A的选择。结果显示,百分比共识条件下选择较贵酒店A的比例为75.7%,显著高于平均评分条件的42.1%,χ²(1) = 34.85,p < .001。“out of”共识条件下同样如此,79.5%对42.1%,χ²(1) = 44.34,p < .001。两种共识格式之间的选择份额无显著差异,χ²(1) = 0.62,p = .431,这一结果与“更大显示数字差产生效应”的简单说法不一致。该研究说明呈现格式可以因果性地改变选择,但并未独立识别从估计喜好差异到感知价值和选择的完整中介路径,且评分基准是基于模型的。
(6)Study 6:体育预测民调
Study 6将效应从产品偏好扩展到具有知识背景的参与者和外部基准的预测领域。研究使用ESPN专家对两届超级碗比赛的预测。在Super Bowl LIII中,97名专家中62%预测A队获胜,平均预测分差为0.97;在Super Bowl LI中,100名专家中72%预测A队获胜,平均分差为1.87。队名以A和B替换,以减少基于队名识别的回答。
研究招募400名MTurk员工作为橄榄球爱好者,通过两道橄榄球知识筛查题限制进入,移除重复参与后剩余368名受访者。参与者被随机分配到一场比赛的共识信息,并估计专家的平均预测分差。估计在真实专家均值10%以内的回答可获得0.10美元奖金。按预注册,回答在5%和95%分位处进行缩尾处理。这里的基准是专家平均预测,而非比赛最终比分差;维加斯让分提供额外比较。
结果显示,在62%共识条件下,参与者估计平均分差为13.13分(SD = 14.14),而专家均值为0.97(SD = 5.67),t(273) = 8.12,p < .001。在72%共识条件下,参与者估计13.64分(SD = 13.85),而专家均值为1.87(SD = 5.86),t(288) = 8.12,p < .001。该模式在更严格的缩尾阈值下以及与维加斯让分2.5分和3分比较时仍然存在。因此,即使是经过筛查且获得准确性激励的橄榄球爱好者,也从预测获胜的比例中推断出较大的获胜分差,说明共识与量级的区分可以扩展到喜好评分之外。
(7)Study 7:反向推断与选举预测
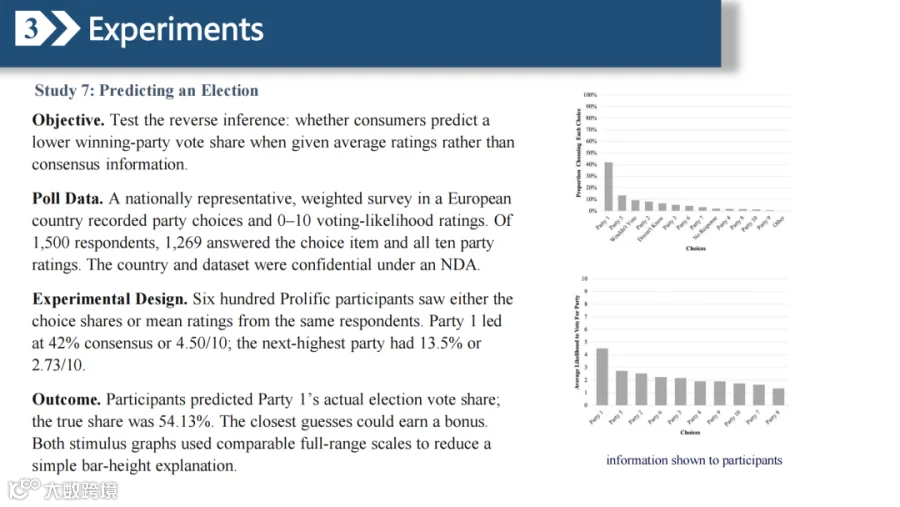
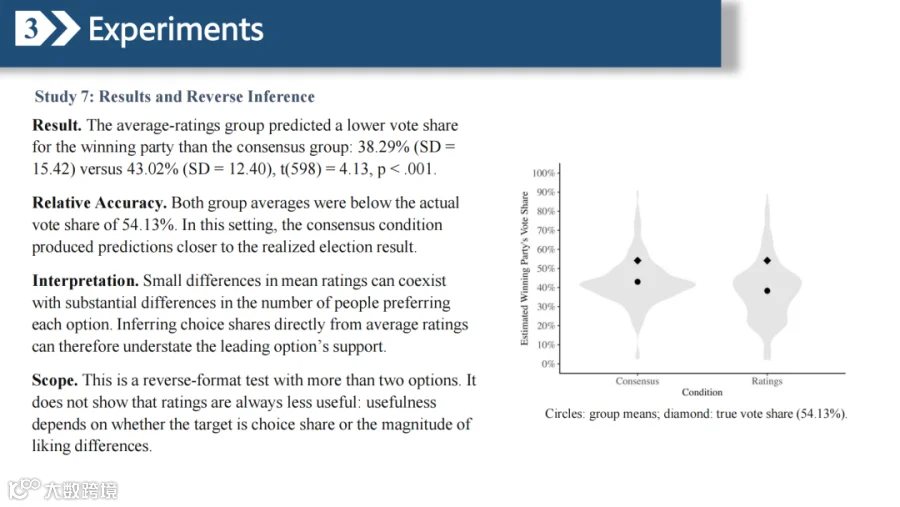
Study 7检验反向推断,即消费者在获得平均评分而非共识信息时,是否会预测更低的获胜党得票率。民调数据来自欧洲某国一项全国代表性加权调查,记录了政党选择和0–10投票可能性评分。1,500名受访者中有1,269人回答了选择项和全部十个政党评分。国家和数据集因保密协议而保密。
600名Prolific参与者看到同一批受访者的选择比例或平均评分。政党1以42%共识或4.50/10领先;次高政党为13.5%或2.73/10。参与者预测政党1的实际选举得票率,真实得票率为54.13%,最接近的猜测可获得奖金。两个刺激图均采用可比的全范围量表,以减少简单的柱高解释。
结果显示,平均评分组预测获胜党的得票率低于共识组,为38.29%(SD = 15.42)对43.02%(SD = 12.40),t(598) = 4.13,p < .001。两组均值均低于54.13%的实际得票率,但在该情境下,共识条件产生的预测更接近实现选举结果。这一结果说明,平均评分中的小差异可以与偏好每个选项的人数上的大差异同时存在,因此直接根据平均评分推断选择份额可能低估领先选项的支持。不过,该研究是超过两个选项的反向格式检验,并不表明评分总是更没有用;有用性取决于目标是选择份额还是喜好差异的量级。
六、研究结论
(1)总体来看
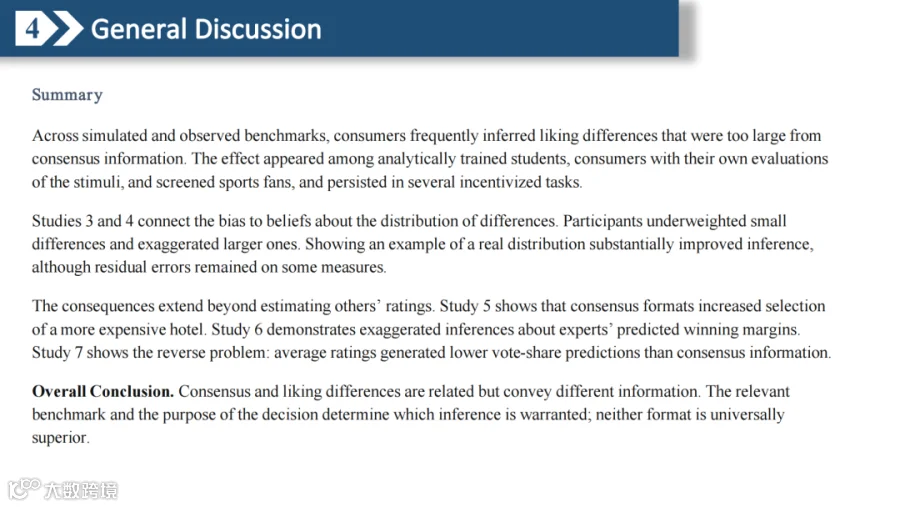
在模拟和观察基准下,消费者经常从共识信息中推断出过大的喜好差异。这一效应出现在受过分析训练的学生、对刺激有自己的评价的消费者以及经过筛查的体育爱好者中,并在若干激励任务中持续存在。Study 3和Study 4将偏差与对差异分布的信念联系起来,参与者低估了小差异并夸大了较大的差异,而展示真实分布示例显著改善了推断,尽管部分指标上仍有残余错误。
该偏差的后果超出估计他人评分。Study 5表明共识格式提高了对更昂贵酒店的选择;Study 6显示对专家预测获胜分差的夸大推断;Study 7则显示反向问题,即平均评分比共识信息产生更低的得票率预测。总体结论是:共识与喜好差异相关但传递不同信息,何种推断合理取决于相关基准和决策目的,两种格式并非普遍更优。
(2)理论贡献
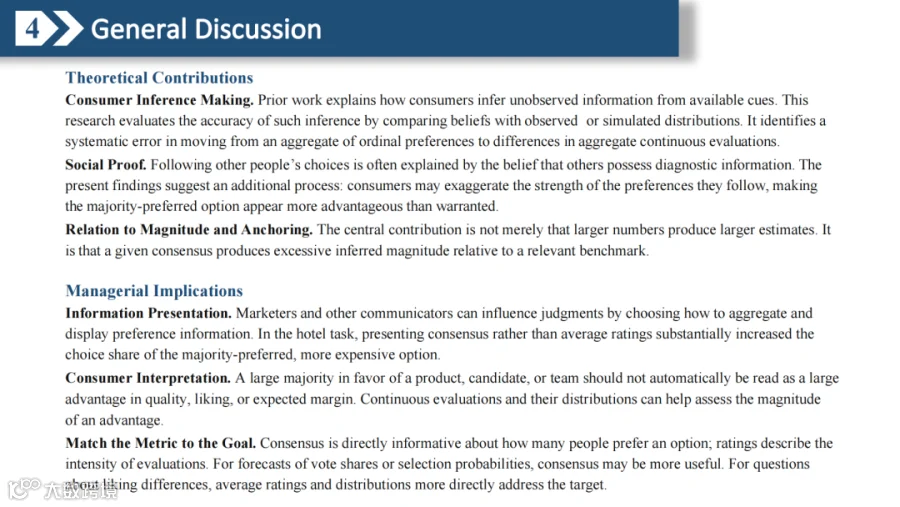
本研究通过与观察或模拟分布比较信念来评估消费者推断的准确性,识别了从序数偏好聚合到连续评价差异聚合中的系统性错误。同时,研究为社会认同提供了额外过程解释:消费者可能不仅相信多数人拥有诊断性信息,还会夸大其跟随的偏好强度,使多数人偏好选项显得比应得的更有优势。其核心贡献也不是仅仅证明更大的数字产生更大的估计,而是证明给定共识水平会相对于相关基准产生过大的推断量级。
(3)管理启示
营销人员和其他传播者可以通过选择如何聚合和展示偏好信息来影响判断。在酒店任务中,呈现共识而非平均评分显著提高了对多数人偏好且更昂贵选项的选择份额。消费者也不应把产品、候选人或队伍获得的大多数支持自动解读为质量、喜好或预期分差上的巨大优势,连续评价及其分布有助于评估优势的量级。更一般地,共识信息直接说明多少人偏好某选项,评分则描述评价强度;预测得票率或选择概率时共识可能更有用,而考察喜好差异时平均评分和分布更直接。
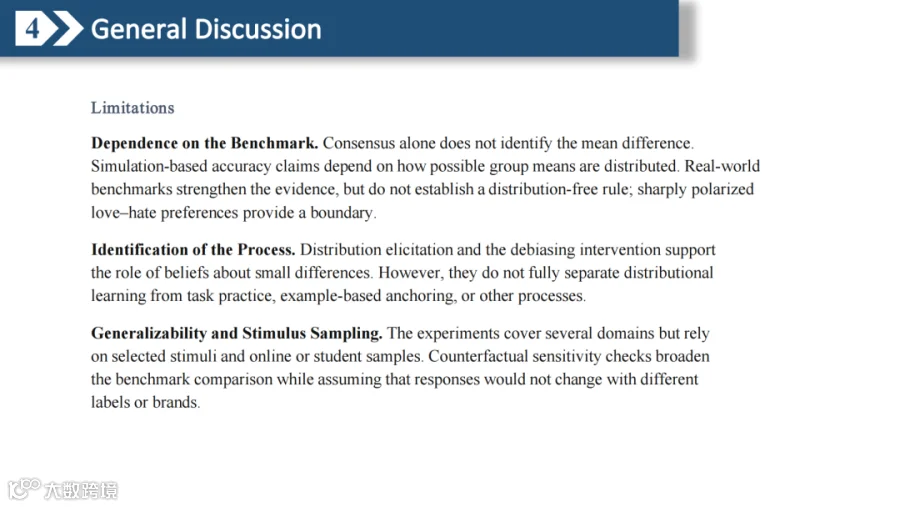
(4)研究局限。
第一,共识本身不能识别平均差异,基于模拟的准确性主张取决于群体均值可能分布的方式;真实世界的基准增强证据,但未建立无分布规则,强烈极化的爱—恨偏好构成边界。
第二,分布引出和纠偏干预支持小差异信念的作用,但无法完全区分分布学习与任务练习、示例锚定或其他过程。
第三,实验覆盖多个领域,但依赖于选定刺激和在线或学生样本;反事实敏感性检查扩展了基准比较,同时假设回应不会因不同标签或品牌而改变。
七、文献PPT
















MEI 中心简介
营销工程与创新研究中心(Research Center for Marketing Engineering and Innovation,简称MEI,网址:www.whueb.com)于原武汉大学管理学院院长甘碧群教授创建的武汉大学电子商务研究中心,自2000年成立以来,一直从事互联网与营销管理相结合研究,是最早从事网络营销与电子商务学术研究机构之一。由武汉大学经济与管理学院的黄敏学教授担任中心主任,致力于将复杂网络分析与文本挖掘技术应用到营销管理研究中,采用工程化思维构建基于大数据的营销模型和实时营销系统,力求推动中国营销研究和管理实践的计算化和工程化,提升营销管理的科学性和前瞻性。