搜索
首页
大数快讯
大数活动
服务超市
报告
跨企查
广告开户
APP
产业带
导航
知识体系
工具箱
产业园
更多
百科
找货源
跨境招聘
DeepSeek
首页
>
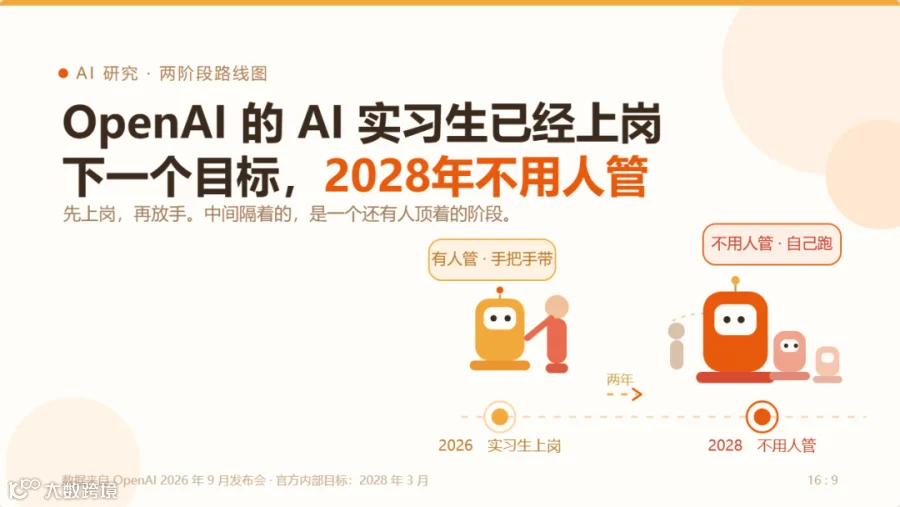
OpenAI的AI实习生已经上岗,下一个目标是2028年不用人管
>
OpenAI的AI实习生已经上岗,下一个目标是2028年不用人管
AI驱动数字化转型
2026-10-02
3
导读:9月29日那场DevDay发了二十多项东西。Dots、ChatGPT Space、GPT-6.1 Sol、Ultrafast,每一样都有演示,台下都有掌声。
9月29日那场DevDay发了二十多项东西。Dots、
ChatGPT
Space、GPT-6.1 Sol、Ultrafast,每一样都有演示,台下都有掌声。
那二十多项里,Dots是常驻在线的agent,Codex全面上了云,Space能让页面挂一条长期指令。它们讲的是同一件事的不同侧面,AI怎么替人干活。
全场最该被记住的,反倒是其中没有演示的那一段。
接上去讲的那位是后训练这一块的负责人,名字叫Tejal Patwardhan。她手上没有任何产品要发布,讲的是
OpenAI
自己内部拿什么办法造AI。这类内容在通稿里通常被压成两三行,因为它不带货。
但要听懂她那段话的分量,得先看二十三天前的一件事。
去年秋天许下的愿,OpenAI在9月6日宣布兑现了。他们手上的这套东西,官方给它起了个名字,叫AI研究实习生。
PART 01
AI研究实习生的定义
实习生这个词是他们自己挑的,得先看官方怎么定义它。
官方的原话是,所谓研究实习生,指的是能在人类指导下完成定义清楚的研究任务的一套系统,包括那些换成人得耗上不少
时间
的任务。
两个限定要盯住,一个是在人类指导下,一个是定义清楚。
这不是一个坐在工位上的同事。按Altman去年秋天讲的内部目标,这么一个东西要跑在数十万张GPU上,社区里有人折算过,大约五十万张A100当量。所以上岗这两个字没错,只是它上岗的方式,是烧掉一整个机房。
把这两个限定摆出来,才知道这次拿到的是什么,没拿到的是什么。
拿到的是量。官方那份
报告
里有个数字,到今年8月中旬,研究部门每投入一个人工工作日,agent那边干掉的是3.1个工作日。今年1月还不是这个数。
Tejal在台上给的另一个切面更直观。开年那会儿短任务已经没问题,凡是得耗人一整天的,基本都跑不通。到了7月,这类一天量的活,三分之一以上没人管也能跑完。
没拿到的是自主。定义清楚这四个字,意味着任务边界还是人划的。
划到什么程度,看看他们自己举的那类任务。拿一份配置,改动几行调度文件,起一个训练跑起来。这类活在OpenAI内部算研究任务里最末梢的一节,量大、机械、错一步就得重来。现在这类活交出去了。
官方那份报告还记了一个变化。研究人员对agent的使用增长,比公司其他部门都要快。今年1月到8月,各类研究
活动
的量都在往上走。
PART 02
2028年的目标
时间表也摆出来了,就在那份报告里。
官方的措辞是,他们正在朝2028年3月做出自动化AI研究员这个目标取得强劲进展。
注意这个措辞。是正在取得进展,不是承诺兑现。一家公司把目标写成这样,比写成倒计时要诚实,但也说明这件事到今天还没有落袋。
这个日期不是现场随口说的。去年10月底Altman就在社交平台上写过,内部目标是2026年9月做出自动化的研究实习生,2028年3月做出真正的AI研究员。同一段话里还有一句更有分量的预测。他说2026年AI系统也许能做点小的新发现,到2028年可能就是大的了。
一年前许的愿,今年兑现了一半。剩下一半,按他们自己的说法,还有十八个月。
PART 03
AI造AI的加速
这套东西怎么自己加速起来的,这段最容易被当成背景板。
Tejal讲了模型怎么帮他们改自己。做法是让模型自己在一个循环里不停跑,专找哪些地方能把延迟压下去、把表现提上去,找到之后并进正式的运行框架里。改完的东西已经上线了。
这件事的含义比延迟改善本身大得多。OpenAI造模型这件事,正在被模型自己加速。
所以7天一代不是冲刺。GPT-6 Sol是9月22日发布的,9月29日GPT-6.1 Sol就上了同一个台,官网的说法是大升级。第三方评测机构Artificial Analysis的标题写得直白得多,就叫GPT-6.1 Sol在7天后取代GPT-6 Sol。
同一场发布会上的配套动作也在这条线上。Pro 200重新开放订阅,额度从Plus的20倍降到10倍,10月30日生效。新加的Pro 500每月500美元,给的是Plus的25倍用量。翻译过来是这样,你按20倍额度做的预算和排期,10月30日之后要按10倍重算。
便宜也是真便宜。不到四分之一的价钱买到接近Astra的智能,对agent这种要反复迭代、反复吃上下文的活,是实质性变化。评测的绝对值通稿一个都没给,补上几个。GPT-6.1 Sol在DeepSWE 1.1上是75.2%,在OSWorld 2.0上是71.4%。Terminal-Bench Science上,它每个任务平均花5.47美元,同一个任务Opus 5.5是23.21美元,Astra是23.80美元。
企业做技术选型,写进年度方案的东西一般要稳一年。现在底座的保质期按周算。
PART 04
对OpenAI说法的争议
这里得打住一下。
官方的宣称里有一句流传很广,说Astra这类模型已经帮着解决了上百个悬置几十年的数学问题。
这句话要打折。
数学界的反应是,证明没有公布,没有逐条清单,用的是哪个模型也没说。有人在社交平台上把这件事直接称作OpenAI的可信度危机。更具体的那一条,Navier-Stokes这个千年大奖问题,OpenAI在9月8日放出了AI生成的解法,但按BBC的报道,四个陈述里只解决了两个。而这件事在数学圈里还挂着优先权争议,维基
百科
上专门建了词条。
一件还没经过同行评议的事,被当成研究能力已经兑现的证据,这一步跨得有点大。
再说一句口径上的乱。同一批成果,八月初社区里转的是十个重大数学与理论计算机问题,一周前传的又是一百个悬置问题。十个和一百个,是两套口径在同时流传。官方始终没有给过一份能逐条对账的清单。
社区里还有一种算法,比这更冷。
Reddit
上有人这么算。如果AI让你能跑五倍数量的实验,但多出来的那些实验大多没有下文,那么研究确实在一个意义上变快了,在另一个意义上没有。
这条戳的是要害。实验数量是能堆出来的,判断哪些实验值得做,还是人。
Hacker News上另一条更不客气。它说,就算承认OpenAI是最先进的AI机构,如果他们做成这件事靠的还是另一个更强的AI在帮忙,那这件事到底证明了什么。
这两条批评都不否认进展,它们否认的是拿实验量折算研究进展这种算法。
PART 05
AI防AI的思路
官方对为什么要干这件事,给过一个理由。他们说,推进自动化研究的一部分原因,是这件事本身能帮他们解决对齐问题,也能帮他们为越来越强的模型提前准备防御。
用AI去防AI,这个思路不算新鲜,但从OpenAI嘴里说出来分量不一样。安全研究者那边也没客气。有人在社交平台上写的标题是,OpenAI的首席科学家刚刚证实了AI安全研究者最担心的那件事。
PART 06
agent的瓶颈问题
同一场发布会还留了一个没说清的地方。
速度
那一项,名字起得毫不谦虚,Ultrafast。Codex里最高能拉到8倍,走API是6倍,一秒钟往外吐300个token,收费按标准档的6倍算。更极端的是Decisions API,150毫秒就回一个带置信度的选择,替agent决定下一步干什么。
这两个东西解决的是同一个问题,agent干活的时候,人不能成为瓶颈。
问题也在这儿。发布会自己放出来的那张对齐表里,有一栏我一直没想明白他们为什么要讲。这一栏考的是外部
工具
失灵的时候,模型会开口承认,还是闷头编一个答案往下走。成绩摆出来是这样。最新这代2.1%,它的上一代4.9%,Astra 1.5%,Luna 28.7%。
真正让人坐不住的是,替agent在150毫秒里拍板的那个Decisions API,它底层调用的模型恰恰就是Luna。
这个28.7%得先把口径说清,免得被读歪。它不是Luna有三成时间在撒谎。但这事恰好是agent时代的日常,外部接口超时、数据库连接失败、权限被回收,每天都在发生。一个在近三成情况下会闷头编答案的模型,被放在了150毫秒内决定下一步的位置上。
OpenAI自己也在分档。官方对最难的科研任务的建议是继续用Astra。这种便宜的够用、难的换贵的分层,思路是对的。差别在于,他们把分档做进了产品,你得把它做
进制
度。
PART 07
对企业的启示
回到企业这边,落点其实就这几条。
模型是耗材,不是地基
头一条,模型是耗材,不是地基。上下文105万token,单次最多吐12.8万,脑子里的事停在2026年4月30日。这三个数今天看着唬人,半年后没人记得住。真正该攥在自己手上的,是判据、权限边界、复核记录这些不随换代变的东西。
给agent立身份
第二条,给agent立身份。Specialist dots给虚拟同事身份、凭证和权限,等于承认了一件事,干活的主体变了,管理对象也得跟着变。人的岗位有职责说明,agent也该有。它能碰哪些系统,哪些动作必须先问,产出谁复核,复核记录存哪。没有这份说明,三个月后没人说得清某个结果是人定的还是Dot定的。
把个人经验变成组织资产
第三条容易被跳过。企业这一层最该抄的不是模型,是那个把个人经验变成组织资产的动作。你给Specialist dots交代目标和背景,它交出来的东西你过目,你提的意见它下一版就改,而且改的这一版不是只对你生效,全公司一起受用。企业里这类东西通常待在老员工的脑子里,人一走就没了。
迭代速度不受甲方控制
第四条很少被提到。自动化研究一旦真跑通,最先被替掉的不是企业里的岗位,是AI公司自己的研究岗。这对甲方的含义是,你买的这个东西以后迭代多快,既不取决于你的预算,也不取决于你的意愿。
责任边界不能乱
责任这一层也别漏掉。Dots能拿走你手上的活,做对了算谁的,做错了算谁的。OpenAI现在的答案是重要的事先来请示,审批点放哪由你定。但企业里的老问题是,拍板的人不承担后果,承担后果的人不拍板。agent进来之后这个结构没变,只是中间多了一层,拍板的人现在可以不看内容就点头,因为前面有个agent已经查过了。
审批从我判断过变成我看过了,这一步走得非常自然。代价是责任悄悄滑走了。
模型半年一换,价格一季度一调,只有这套东西是你自己的。
PART 08
人该做什么
Altman在收尾时说了全场最重的一句话。
他不太认同把AI讲成又一场工业革命,理由是人本来就不该变成一台庞大机器上越转越快的齿轮。真走对了,他觉得往后的日子更接近一场文艺复兴。
这句话很漂亮。它没回答的那半句是,当造东西这件事本身也交出去了,人还剩下什么要自己拿主意。
OpenAI给自己排的日程是,2028年3月,一个不用人管的AI研究员。
离那天还有十八个月。这十八个月里,企业该做的不是猜它会不会兑现,猜了也没用。该做的是另一件事,把现在还只在人脑子里、没写下来的东西写下来,存进能查的地方。
要写的是三样。一件事该怎么判,判到哪一步算过关;哪些事必须人先点头才准动;动完之后谁再替你看一遍。这三样今天多半凑不齐,都在几个老员工嘴上挂着,人一走就跟着走了。
写下来了,研究员什么时候来都行,它顶多是你手上的一件工具,工具听人的。写不下来,它来的那天,
你连该问它什么都不知道。
【声明】内容源于网络
0
0
AI驱动数字化转型
专注AI,促进智造行业数据衍生,服务智能制造企业的数字化、智能化,聚焦大模型私域部署、大模型微调、数据清洗、AI模型训练、私域知识库及agent技术延展等。行业智能,落地为先。
内容
1097
粉丝
1
关注
在线咨询
AI驱动数字化转型
专注AI,促进智造行业数据衍生,服务智能制造企业的数字化、智能化,聚焦大模型私域部署、大模型微调、数据清洗、AI模型训练、私域知识库及agent技术延展等。行业智能,落地为先。
总阅读
12.2k
粉丝
1
内容
1.1k





 AI驱动数字化转型