


一份让软件工程师"像调用普通 C++ 库一样调用 RTL"的工程笔记 📓
在芯片项目里,硬件团队交付的是 RTL 模块,软件团队想要的是 一个能调用的函数。中间这道落差,往往成为软硬件协同的瓶颈。本文分享一种实践:把 testbench 封装成函数,并把 RTL 与 C++ 参考模型做成接口一致的等价实现,让软件团队在硬件流片之前就能用上它。 🚀
一、问题的由来:两个世界的语言差异 🌐
1.1 硬件团队交付了什么
以 8 位位串行加法器为例,RTL 长这样:
   module seq_adder #(
    parameter WIDTH = 8
)(
    input  wire             clk,
    input  wire             rst_n,
    input  wire             start,       // 单周期脉冲:启动运算
    input  wire [WIDTH-1:0] a,
    input  wire [WIDTH-1:0] b,
    input  wire             cin,
    output reg              busy,        // 运算进行中
    output reg              done,        // 单周期脉冲:结果有效
    output reg  [WIDTH-1:0] sum,
    output reg              cout
);
    // 每个时钟周期处理一位:sum_bit = a[0]^b[0]^carry
endmodule
对硬件工程师来说,这再自然不过了:时钟推进、握手信号、时序约束——全是熟悉的味道。
1.2 软件团队想要什么
但软件工程师看到这些会一脸茫然 😵:
-
• ⏰ 时钟是什么?我只想传参数、拿返回值 -
• 🤝 start/busy/done怎么用?我的函数又不会"忙" -
• 📏 WIDTH参数怎么映射?我要的是uint32_t -
• 🐛 出错了怎么办?我习惯用异常或错误码
1.3 落差的可视化
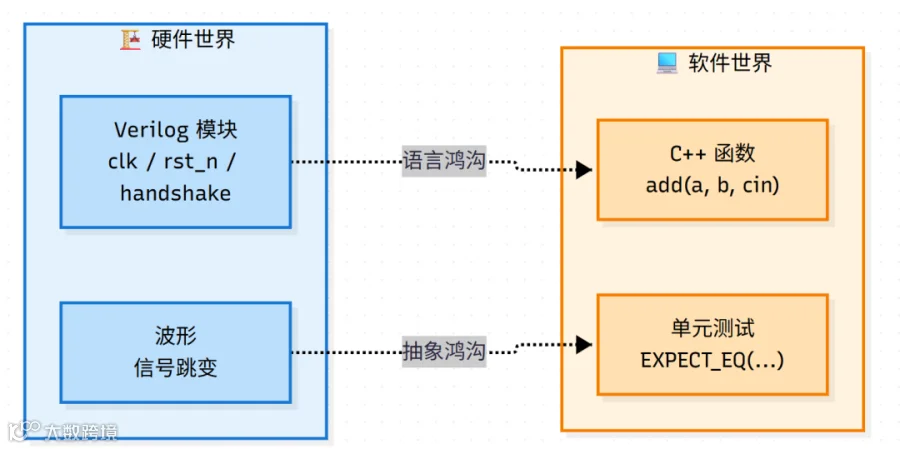
这道鸿沟不是技术问题,是抽象层级问题。本文的核心思路就是:用一层 C++ 封装,把 RTL 变成函数。 🎯
二、三层封装结构 🏛️
2.1 整体架构

软件工程师只看最上层,中间的时钟推进、握手等待、状态复位统统封装在类内部。
2.2 各层职责一览
2.3 封装的具体实现
封装的核心是把"信号级操作序列"压缩成"一次函数调用":
   class SeqAdder {
public:
    struct Result { uint32_t sum; uint32_t cout; };

    // 🌟 对外只暴露这一个函数
    Result add(uint32_t a, uint32_t b, uint32_t cin = 0) {
        // 步骤 1:拉起 start 一拍
        dut_->a     = a & MASK;
        dut_->b     = b & MASK;
        dut_->cin   = cin & 1u;
        dut_->start = 1;
        tick();                 // 一个时钟周期
        dut_->start = 0;

        // 步骤 2:等待 DUT 完成逐位运算
        int guard = 0;
        while (!dut_->done && guard++ < WIDTH + 4) {
            tick();             // 每个周期处理一位
        }

        // 步骤 3:返回结果
        return { dut_->sum & MASK, dut_->cout & 1u };
    }

private:
    Vseq_adder* dut_;

    void tick() {
        dut_->clk = 0; dut_->eval();
        dut_->clk = 1; dut_->eval();
    }
};
2.4 参考模型:接口完全一致
   class NativeAdder {
public:
    AddResult add(uint32_t a, uint32_t b, uint32_t cin = 0) const {
        uint32_t full = (a & 0xFF) + (b & 0xFF) + (cin & 1);
        return { full & 0xFF, (full >> 8) & 1 };
    }
};
两个类接口一模一样——这是整个方法论的关键 🔑。上层代码只依赖 add(),不依赖实现。
三、封装前后的时序对比 ⏱️
3.1 信号级的繁琐操作
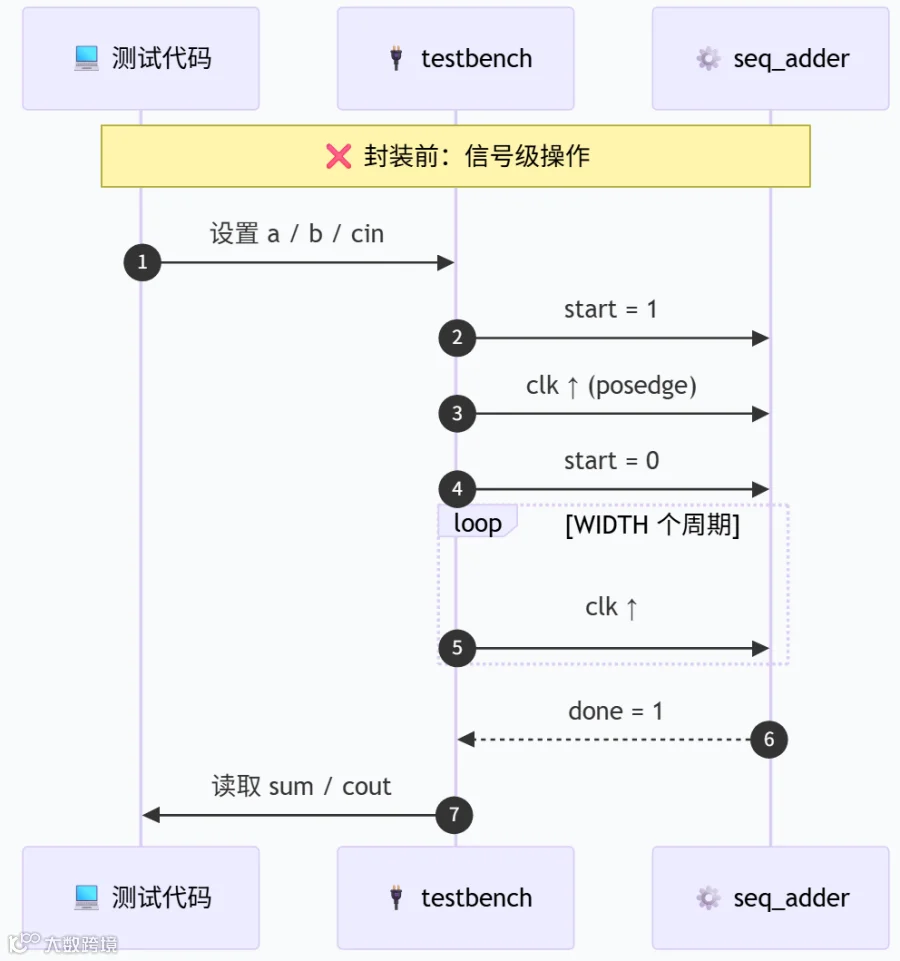
每一步都要小心翼翼,忘一个 tick() 结果就错了 😰
3.2 事务级的干净调用

软件工程师只看到一次函数调用 + 一个返回值 🎉
3.3 调用侧的对比
四、为谁而封:三类典型使用者 👥
4.1 使用者地图
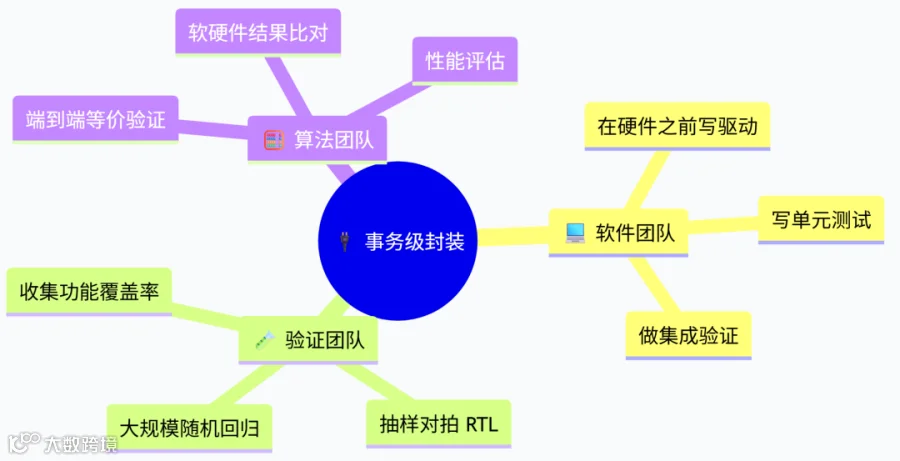
4.2 软件团队:在硬件之前开发驱动 💻
拿到的是一个 .h 文件和一个 .a 静态库:
   // seq_adder.h —— 软件团队看到的全部内容
class SeqAdder {
public:
    struct Result { uint32_t sum; uint32_t cout; };
    Result add(uint32_t a, uint32_t b, uint32_t cin = 0);
};
立刻就能写单元测试:
   TEST(AdderTest, BasicAdd) {
    SeqAdder adder;
    auto r = adder.add(100, 200);
    EXPECT_EQ(r.sum, 44);
    EXPECT_EQ(r.cout, 1);
}
不需要 Verilog、不需要波形、不需要学仿真器 🎓
4.3 验证团队:用参考模型做大规模回归 🧪
   template <typename Adder>
int run_regression(Adder& dut, int n, unsigned seed) {
    std::srand(seed);
    int errors = 0;
    for (int i = 0; i < n; ++i) {
        uint32_t a = rand() & 0xFF;
        uint32_t b = rand() & 0xFF;
        uint32_t c = rand() & 1;
        auto r = dut.add(a, b, c);
        // ... 比对逻辑 ...
    }
    return errors;
}

// 日常快速回归:C++ 参考模型(亿级规模)
run_regression(native_dut, 100000000, 42);

// 每日构建:Verilator 真值(百万级)
run_regression(seq_adder_dut, 1000000, 42);
同一份测试代码,换个对象就能切换实现 ✨
4.4 算法团队:端到端等价性验证 🧮
   // 软件参考流水线
std::vector<uint8_t> software_pipeline(const std::vector<uint8_t>& in);

// 硬件流水线(仿真驱动)
std::vector<uint8_t> hardware_pipeline(const std::vector<uint8_t>& in) {
    SeqAccelerator accel;
    std::vector<uint8_t> out;
    for (auto b : in) out.push_back(accel.process(b));
    return out;
}

TEST(PipelineTest, Equivalence) {
    auto in = generate_random_input(10000);
    EXPECT_EQ(software_pipeline(in), hardware_pipeline(in));
}
五、双跑对拍:既快又有保障 🔍
单纯用参考模型加速,会丢掉对 RTL 的实时校验。双跑对拍是一种折衷:
5.1 对拍流程
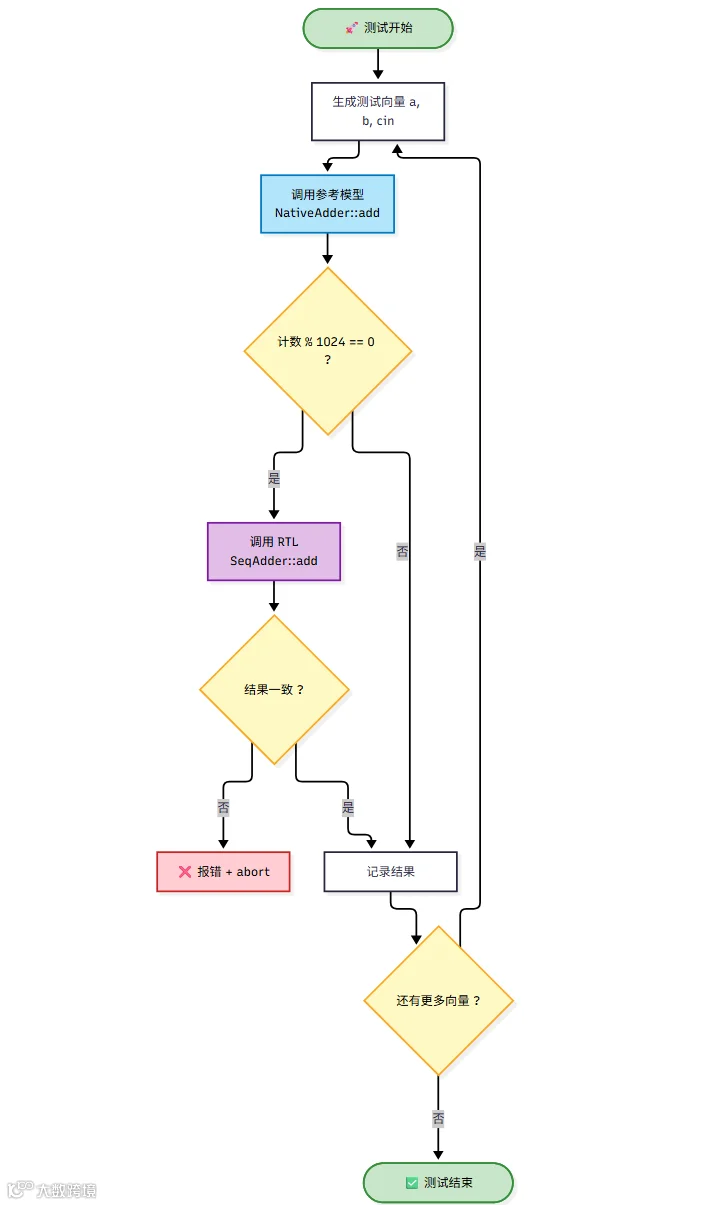
5.2 实现代码
   class CheckedAdder {
    SeqAdder    rtl_;
    NativeAdder ref_;
    size_t      count_       = 0;
    size_t      check_every_ = 1024;

public:
    AddResult add(uint32_t a, uint32_t b, uint32_t cin) {
        // 主路径:走参考模型
        AddResult r = ref_.add(a, b, cin);

        // 抽样校验:偶尔走 RTL
        if (++count_ % check_every_ == 0) {
            auto rtl_r = rtl_.add(a, b, cin);
            if (rtl_r.sum != r.sum || rtl_r.cout != r.cout) {
                fprintf(stderr,
                        "Mismatch @ %zu: a=%u b=%u cin=%u "
                        "ref=(%u,%u) rtl=(%u,%u)\n",
                        count_, a, b, cin,
                        r.sum, r.cout, rtl_r.sum, rtl_r.cout);
                abort();
            }
        }
        return r;
    }
};
5.3 抽样间隔的选择
六、工程细节:让封装真正可用 🔧
6.1 生命周期要明确
Verilator 的 DUT 需要显式清理,和软件工程师习惯的 RAII 不同,封装类要处理好:
   class SeqAdder {
public:
    SeqAdder()  { dut_ = new Vseq_adder; reset(); }
    ~SeqAdder() { dut_->final(); delete dut_; }

    // 🚫 禁止拷贝:DUT 有内部状态,不能随意复制
    SeqAdder(const SeqAdder&)            = delete;
    SeqAdder& operator=(const SeqAdder&) = delete;
};
这样软件工程师能自然地在栈上创建对象:
   {
    SeqAdder adder;              // 自动构造 + 复位
    auto r = adder.add(1, 2);
}                                // 自动析构 + 清理
6.2 接口设计原则清单 📋
-
• ✅ 用事务级概念( add、process_packet),而不是信号级概念(start、valid) -
• ✅ 用结构体返回值,而不是多个输出引用参数 -
• ✅ 用一致的错误处理方式(异常或错误码),不暴露 Verilator 细节 -
• ✅ 用稳定的类型( uint32_t、std::vector),而不是WIDTH相关的宏 -
• ✅ 保持接口版本化,与 RTL 端口解耦 -
• ❌ 不要暴露 clk、rst_n、eval() -
• ❌ 不要让调用者感知 busy/done握手 -
• ❌ 不要在接口里掺杂 Verilog 概念( $clog2、x传播)
6.3 交付形态清单 📦
给软件团队交付时,通常提供三种形态:
-
1. 头文件 + 静态库 📚 -
• seq_adder.h+libseq_adder.a -
• 简单直接, g++ main.cpp -lseq_adder -
2. CMake 集成 🏗️ -
• 提供 FindSeqAdder.cmake -
• 作为子模块 add_subdirectory引入 -
3. Docker 镜像 🐳 -
• 打包整个仿真环境 -
• 软件团队在任何机器上都能跑
七、边界:什么能用,什么不能 ⚠️
7.1 适用性决策树
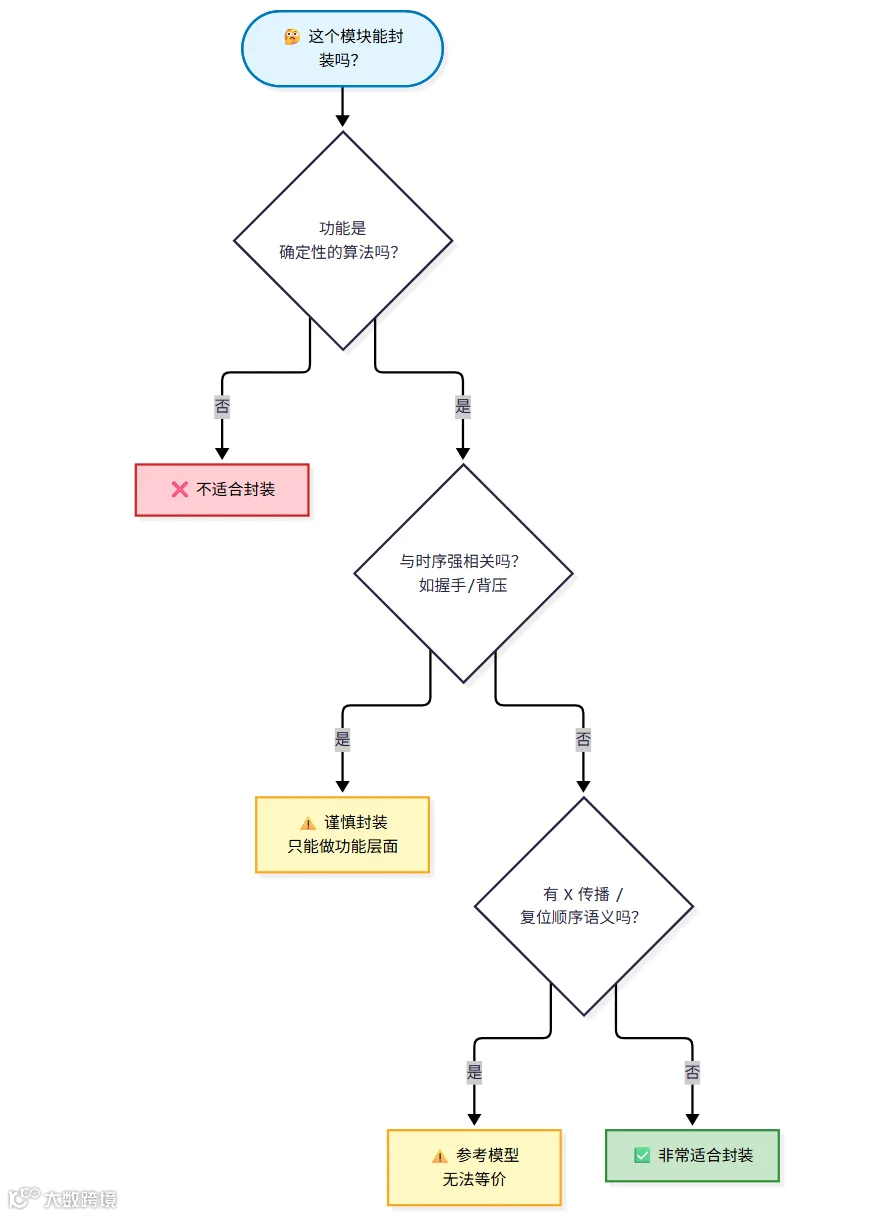
7.2 场景对照表
7.3 核心原则
封装是为了让软件团队能在"功能层面"使用 RTL,而不是替代 RTL 验证本身。 🎯
RTL 仿真仍然是签核(sign-off)的唯一真值;C++ 参考模型是"左移"到更早阶段、让更多人参与验证的工程手段。两者是互补关系,不是替代关系。
八、分层测试策略 🏔️
8.1 测试金字塔

8.2 各层对比
8.3 CI 配置示例
   # .gitlab-ci.yml
unit_test:                       # 🚀 L0:秒级反馈
  script:
    - make -C build native_test  # C++ 参考模型,上亿向量
  only: [merge_requests, main]

rtl_smoke:                       # ⚙️ L1:分钟级
  script:
    - make -C build rtl_smoke    # Verilator 冒烟
  only: [main]

nightly_regression:              # 🧪 L2:小时级
  script:
    - make -C build rtl_full
  rules:
    - if: $CI_PIPELINE_SOURCE == "schedule"
九、落地路线图 🗺️

9.1 每一步的关键动作
-
1. 选试点 🎯 -
• 选输入输出清晰、时序依赖弱的模块 -
• 推荐:CRC、定点运算、小滤波器 -
• 避免:SoC 总线、CPU 核 -
2. 写两份封装 📝 -
• 一份基于 Verilator(真实 RTL) -
• 一份纯 C++ 参考模型 -
• 接口保持一字不差 -
3. 穷举对拍 ✅ -
• 小位宽先穷举(8 位 = 65 万种组合) -
• 再上大规模随机 -
• 确保每一组结果都一致 -
4. 交付试用 📦 -
• 头文件 + 静态库 + CMake 集成 -
• 一份简短 README:怎么调用、返回什么 -
• 收集反馈,重点看接口是否好用 -
5. 推广 🌱 -
• 形成"软件可调用硬件库" -
• 每个模块都按统一模式封装 -
• 逐步覆盖核心数据通路
十、总结 🌟
10.1 核心思想
RTL 是硬件工程师的语言,函数是软件工程师的语言。
把 RTL 封装成函数,就是在这两种语言之间架一座桥。 🌉
10.2 三个关键步骤

10.3 三方收益
10.4 边界提醒 ⚠️
-
• ✅ 适合:确定性算法、数据通路、软件协同开发 -
• ❌ 不适合:时序、协议、结构、签核 -
• 🎯 定位:互补,不是替代
10.5 最后一句
仿真器的速度差异是事实,但本文真正想推荐的,不是"用 C++ 加速仿真",而是"把 RTL 变成软件工程师可以调用的函数"。
这座桥搭好了:
-
• 软件团队能在流片前跑通代码 🚀 -
• 验证团队能做更大规模的回归 🧪 -
• 硬件团队获得更完整的验证生态 🌐
这才是这套实践真正的价值所在。💎