

 caveman简介
AI/ML
Caveman 是一个用于降低 AI 编程助手 Token 消耗的工具集。它通过压缩 AI 的输出文本(Skill)和输入上下文(Proxy/Middleware),在不影响代码生成质量的前提下,显著减少按量计费场景下的 API 开销。
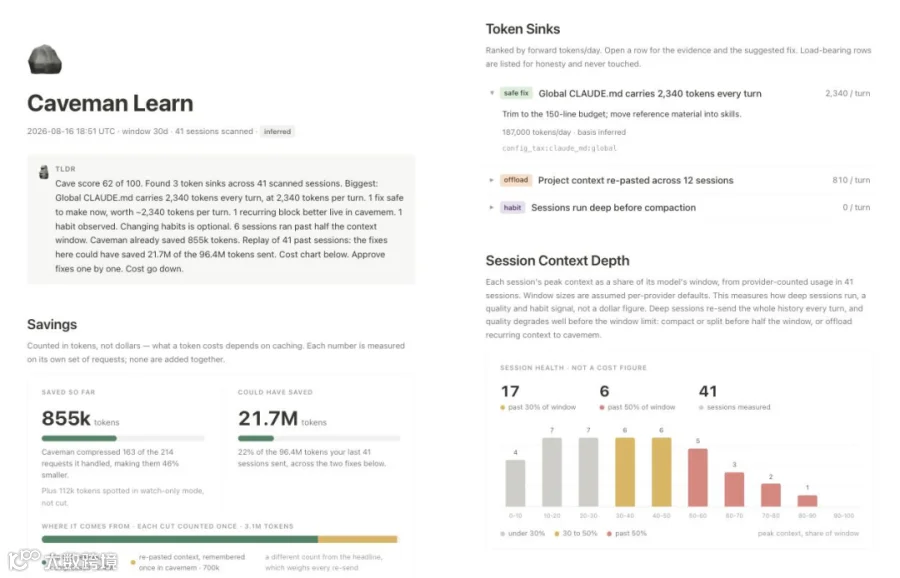
它解决了 AI 编程代理在长会话中因输出冗长废话、读取大量日志和测试报告而导致 Token 费用高昂的问题。它提供从单文件规则到本地代理再到 SDK 中间件的完整方案,支持 Claude Code、Codex、Cursor 等 30 多种主流 AI 编程工具。
 亮点特性
01三层架构设计
Skill 压缩输出文本,Proxy 压缩输入上下文,Middleware 供自建应用调用,可叠加使用
02智能无损压缩
代码、命令、文件路径和错误信息绝不被修改,安全警告会自动恢复为完整句子
03数据完全可控
本地运行,压缩前的原始数据保存在本地 SQLite 中,AI 随时可请求恢复原文
04自带诊断与 A/B 测试
caveman learn 可分析历史会话找出 Token 浪费点,caveman trial 可直接对比开启前后的真实消耗
05像素模式黑科技
可将 Skill 规则文件渲染为 PNG 图片让模型读取,进一步将规则本身的 Token 消耗降低 61%
 使用场景
场景 1日常使用 AI 编程助手时,消除冗长的解释性废话,直接获取核心修复建议,降低按量计费的 API 成本
场景 2在 CI/CD 或自动化脚本中运行 AI 代理处理大量测试日志和 diff 时,通过本地代理压缩上下文,避免超出模型上下文窗口限制
场景 3开发者构建自定义 AI Agent 应用时,通过中间件自动压缩工具调用的返回结果(如 JSON、网页内容),优化整体 Token 预算
 使用环境
 快速上手
1. 最简安装(Skill 模式:仅压缩 AI 输出)
无需账号和 API Key,一条命令全局安装,适用于 30+ 种 AI 代理:
|
安装后,向你的 AI 助手提问即可看到精简回复。可通过 /caveman lite、/caveman full、/caveman ultra 调整压缩强度,输入 stop caveman 恢复正常。
2. 进阶安装(Proxy 模式:同时压缩 AI 读取的上下文)
安装 CLI 并配置本地代理,拦截并压缩日志、JSON、diff 等输入数据:
|
3. 开发者集成(Middleware 模式:用于自建 Agent)
在 TypeScript (Vercel AI SDK) 中集成:
|
在 Python (LangChain) 中集成:
|
 替代方案
对比 1RTK
仅针对 Shell 命令输出进行压缩,且 JetBrains 测试显示其在低推理强度下反而增加了 7.6% 的成本;Caveman 覆盖面更广且经过严格基准测试验证有效
对比 2Headroom
同样通过本地代理压缩工具输出和日志,但在相同基准测试套件中,Caveman 节省了 33.2% 的输入 Token 且 18/18 回答正确,而 Headroom 仅节省 6.7% 且有 3 个回答错误
对比 3context-mode
在沙箱中运行工具并压缩输出,但不支持像 Caveman 那样字节级精确恢复原始数据
 相关资源
项目地址github.com/JuliusBrussee/caveman
文档docs.caveman.so