


题目:RAGEN-2: Reasoning Collapse in Agentic RL
论文地址:https://arxiv.org/abs/2604.06268
代码地址: https://ragen‑ai.github.io/RAGEN

创新点
•首次识别并定义智能体强化学习里模板崩塌(template collapse)这一隐蔽失效现象,模型在单条输入内生成内容熵值保持较高、表面文本多样,但跨不同输入时推理逻辑会固化成固定模板,不再跟随输入信息变化,该现象无法被熵这类传统指标检测。
•将推理质量拆解为输入内多样性(熵)与跨输入区分度(互信息 MI)两个维度,提出轻量的互信息代理指标用于训练过程在线诊断,验证互信息和任务最终性能的相关性远强于熵,弥补传统评估指标的缺陷。
方法
本文在多轮智能体强化学习框架下开展实验,先通过大量训练观测识别模板崩塌现象,将推理质量拆分为输入内多样性与跨输入区分度两个维度,提出互信息及其代理指标作为在线诊断工具,用来衡量模型推理是否能够随输入发生变化,同时从信噪比角度完成梯度层面的理论拆解,解释低奖励方差会弱化任务梯度、让正则项占据主导进而抹除输入间推理差异的内在机理,之后设计 SNR 感知过滤方法,在每一轮强化学习更新前计算样本对应的奖励方差,筛选高信噪比提示样本,仅使用筛选后的子集在 PPO、DAPO、GRPO 等多种强化学习算法上执行参数更新,整套方法无需额外模型,复用训练过程已有的奖励信息,最后在规划、数学推理、网页导航、代码执行多类任务,不同模型参数量以及多模态场景中开展对照实验与消融实验,验证指标有效性与缓解模板崩塌策略的提升效果。
基于熵 H 与互信息 MI 划分的推理四大象限
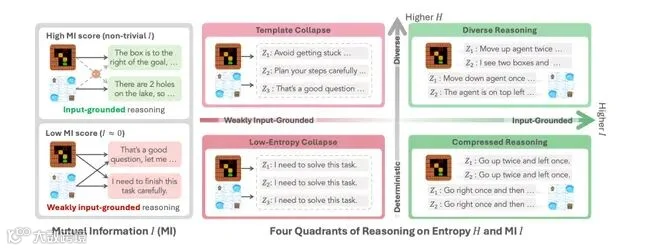
本图以二维坐标系展示模型推理的两种评价维度,纵轴代表熵 H,衡量单次输入内部生成内容的多样性,横轴代表互信息 MI,衡量推理内容与输入场景之间的绑定程度,整体划分出四类推理行为,左上为高互信息的输入关联推理,模型的思考内容会跟随不同输入场景而变化,左下是低互信息的弱输入绑定推理,模型输出空洞话术,推理和输入几乎无关,中间上方是模板崩塌,模型单次样本内文本熵较高、表面看起来内容多样,但推理逻辑脱离输入、使用固定套话,这是该论文重点发现的隐蔽失效模式,中间下方为低熵崩塌,模型对不同输入都输出完全一致的固定语句,右侧绿色区域代表理想情况,右上是多样推理,既有内部文本多样性又能贴合输入,右下为压缩推理,输出简洁确定的步骤且依然与输入场景匹配,借助马里奥类网格环境示例直观区分传统熵指标无法识别的模板崩塌问题,说明仅依靠熵不能判断推理是否真的依据输入做出变化,互信息才可以衡量推理是否锚定输入信息。
智能体强化学习中任务相关梯度与信噪比原理示意图
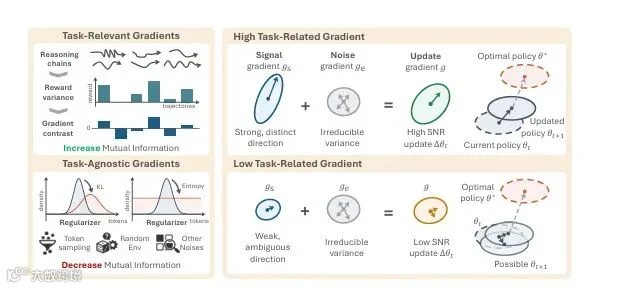
本图从梯度分解角度解释模板崩塌的内在成因,将训练梯度拆分为任务相关梯度与任务无关梯度两大类,上方任务相关梯度由推理轨迹产生,存在明显奖励方差与梯度差异,能够提升互信息,让模型学会依据不同输入给出差异化推理;下方任务无关梯度来自 KL 散度、熵等正则项以及采样、环境带来的各类噪声,这类梯度会降低互信息,促使模型走向模板崩塌,图的右侧进一步把总梯度拆解为信号梯度与噪声梯度,对比高信噪比和低信噪比两种场景,高信噪比时任务信号梯度强,更新方向清晰稳定,策略能够稳步向最优策略靠近,低信噪比场景下有效任务信号微弱,噪声占主导,梯度更新方向模糊不确定,策略难以收敛到最优,直观说明奖励方差不足造成低信噪比,是智能体强化学习发生模板崩塌的核心机理。
SNR 感知过滤(SNR-Aware Filtering)算法流程
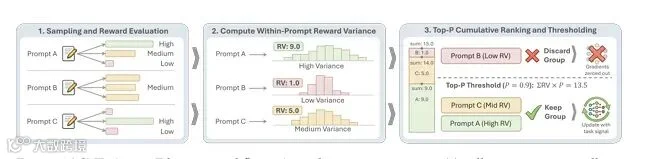
本图分三步完整展示 SNR 感知过滤的执行流程,第一步为采样与奖励评估,对不同提示词 Prompt A、B、C 各自采样多条推理轨迹,评估每条轨迹对应的奖励,得到高、中、低不同奖励结果;第二步计算单个提示词内部的奖励方差 RV,Prompt A 奖励方差高,Prompt B 奖励方差低,Prompt C 为中等奖励方差,奖励方差越高代表该样本信噪比越高,能提供更有效的任务梯度信号;第三步采用 Top-P 累积排序与阈值筛选,把全部提示词按奖励方差从高到低排序,累加方差值直到达到设定的 Top-P 阈值,保留达到阈值的高、中等方差提示词用于参数更新,直接丢弃低奖励方差的 Prompt B 并将其梯度置零,只使用筛选后的样本子集进行强化学习更新,以此剔除低信噪比样本带来的噪声梯度,减少模板崩塌问题,该流程可嵌入 PPO、DAPO、GRPO 等智能体强化学习训练循环中。
实验
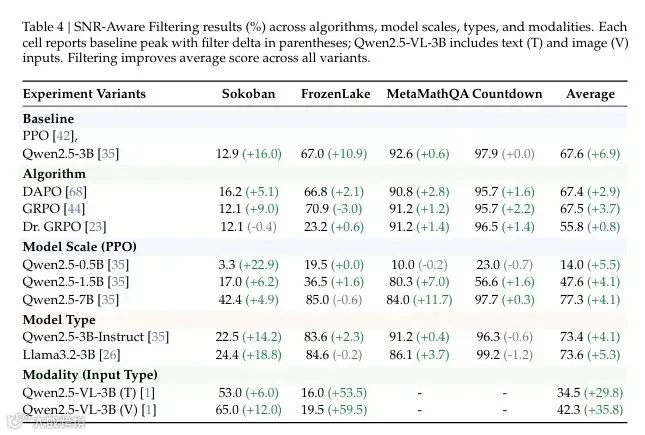
该表格对比普通基线强化学习与加入 SNR 感知过滤策略后的模型在推箱子 Sokoban、冰湖 FrozenLake、数学推理 MetaMath、倒计时 Countdown 四项任务上的成功率以及四项任务的平均分,实验采用统一的强化学习算法与模型基础配置,基线方案直接使用全部样本进行 PPO/GRPO 类智能体强化学习更新,SNR 感知过滤方案在每一轮更新前依据提示词内奖励方差筛选高信噪比样本,剔除低奖励方差的噪声样本,表格数据显示在全部四项任务上,SNR 感知过滤都带来任务指标提升,四项任务平均成功率明显高于原始基线,同时模型对应的互信息 MI 指标同步上涨,说明该过滤策略不仅提升任务最终性能,也增强推理内容与输入场景之间的绑定关系,有效缓解模板崩塌,证明该方法在规划类、数学类多种任务场景都具备通用性。