使用 Codex、Claude Code 描述需求,代码被逐步编写、一版一版改下去。这类东西的本质,是给编程做出了收敛的工程路径——IDE、上下文、工具链、版本。
而金融研究还没有等到专属的一个 Harness 产品。
而金融本身非常适合 AI:量化研究天然是数据、代码和检验组成的,看起来最该被改造。它缺的,是一条更专业的路径下迭代出的垂类产品。
而我们最近在公测的 EVO,就是冲着这个空缺来的。
为什么要做 Harness,而不是又一个 AI 助手
因为投研和交易的任务,有着更明确的专业知识范围,更高的准确性要求。
从一个想法出发——数据可不可信?指标之间是真相关吗?相关性能不能推出因果?最后能不能落地成可以交易的东西?——中间每一步都可能逻辑正确但仍旧不符合实际情况。
所以关键在于如何把这里的各种问题定义清楚,而 EVO 就是这么一套 harness,围绕提出的金融研究问题延伸推进,每一步都有明确而符合金融语境的思考并持续提出优化路径。
同时界面按 IDE 设计,以便于导入你自己的 Python、Markdown 和 CSV 进行后续迭代;数据每天更新,组件和工具内置。
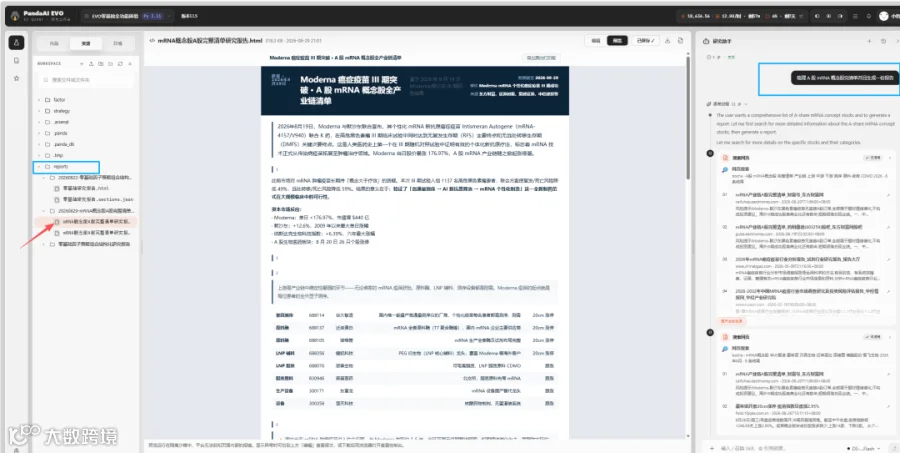
莫德纳 AI 加医药的新闻暴涨那天,盯着盘的人,第一反应是同一个问题:这事跟国内什么关系?跟我手上的品种什么关系?
EVO 则还会进一步推进:列出相关内容的具体源头,以便于深究真实性;把新闻的背景讲清楚;相关品种的布局与近期催化事件给出来,也包括数据的时效性、新闻到品种的传导链等等;这些具体的数据都是在金融研究中可能真实需要的,而通用 Harness 产品并不会考虑到的细节。
最我们已经把 PandaData 通过 MCP 连接器接进了 Workbubby 中。顺理成章的问题是:同一套数据能力,在通用工具里和在 EVO 里,用起来有什么差别?
这里发送同样的提示词:「帮我在沪深 300 上做一个策略」,配一张图。
通用 Harness 把这句话理解为「做沪深 300 指数」——并生成了对应的报告和回测,附带完整过程。但这里暴露的问题的是,沪深 300 指数本身需要拿 ETF 或者 300 里的个股做标的,这个知识细节在通用 Harness 是极容易被疏漏的,而这种静默的细节偏移,恰恰是最难发现且逻辑自洽的。
而同一句话,EVO 会正确的理解为:在沪深 300 这个池子里做策略。
这里就是金融领域的特殊性,细节的偏移会带来整体的失效,对于垂类 Harness 来说,在金融领域会有更加充分的考量。
做主观交易的人,大多看过形态。双底这种东西,让人看了就想买——但它历史上到底出现过多少次?成功率是多少?涨停跌停能不能买?
过去这些问题很难回答,只能自己一遍遍跑,拿时间换经验。
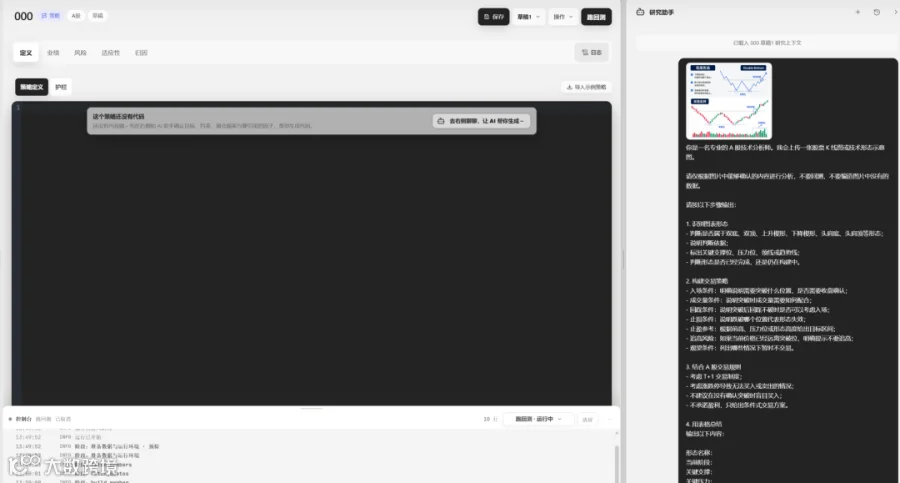
而现在把一张双底图发给 EVO:帮我在某个范围里做一个策略。
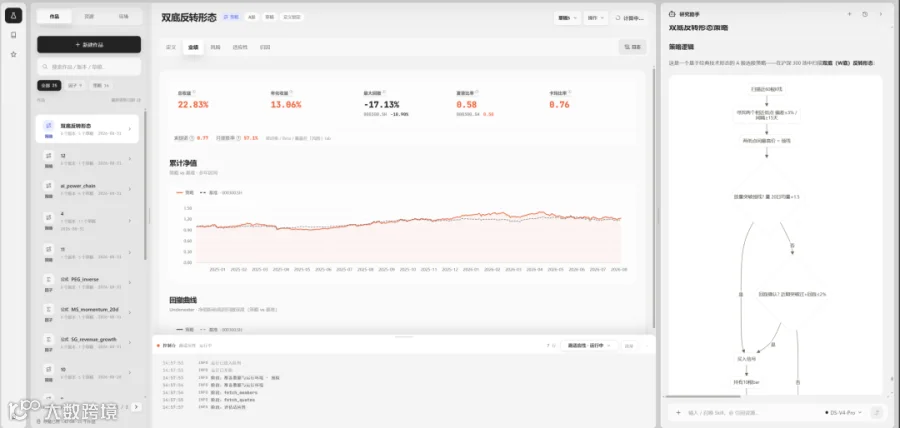
EVO 会先把回测结果跑出来,然后反过来询问:当前的问题是什么?接着跟你一起往下改。
垂类 Harness 会更了解金融研究的具体需求,会周全的考量并提高日常金融工作的效率。
金融研究是有这连续性的,且会不断积累更多的因子、策略等研究成果。
为此我们制作了成熟的版本体系。每一版都会进行云端保存便于随时回溯、相关的数据都可以直接对比;落实为正式版本后还会有清晰的因子与策略的引用关系,这样往下怎么走、哪一版做坏了,都有记录。
这样研究就可以稳定的积累下来,互相引用、持续迭代,因此我们会称 EVO 为个人量化工作台。
这个月我们公开了 VST 框架的相关论文,解决了让多个 AI 协作做研究的过程可追溯、可独立复核的问题,未来我们还会持续的进行研究,不断提高 AI 工具在金融领域的深度、广度,为大家提供更加坚实的金融 Infra。
再往后,可能是 AI 金融的 L3 阶段:一个能自我迭代的系统——你的每一次研究都会被积累下来,交易想法、策略、因子,一层一层往上长,越用越厚。它在我们的产品里叫「A2A 办公室」,还在持续的研发和测试中。
在 AI 编程工具出现之前,写代码也是一门靠经验拼凑的手艺。
把你的下一个研究问题,交给 EVO 走一遍
EVO 现已开放公测,欢迎亲自体验从想法、数据到可检验结果的完整路径。
了解 EVO →




 PandaAI个人量化超级助手