

中秋之际,CCTV-9 四集纪录片《超级工程—曙光8000》热播,引发行业对算力未来的深层思考。随着《向未来》收官,本文旨在解析这一国家级工程背后的技术逻辑与产业启示。
澎湃的算力将开启怎样的未来?在补齐四集内容后,我们试图回答这一核心命题。
01 十万卡的真正考题:系统级协同
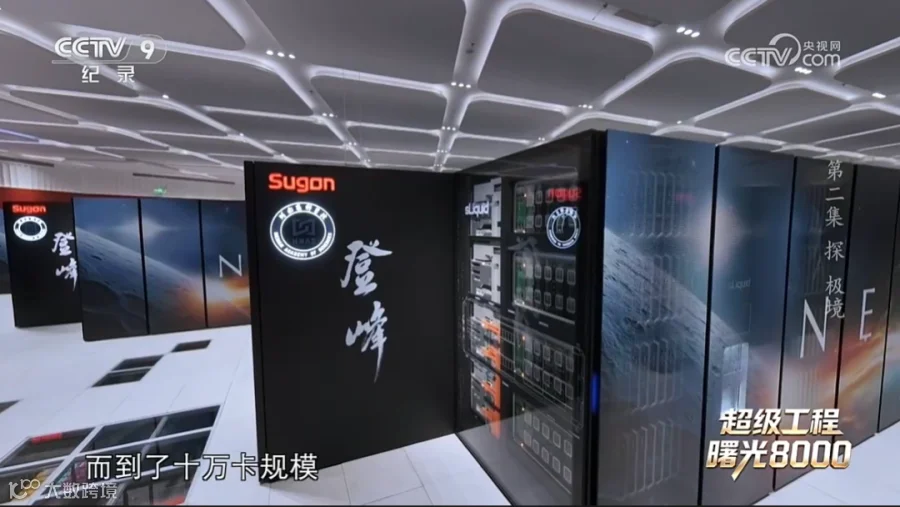
十万张芯片、八十多组机柜、十亿多个零部件——这些数字令人震撼,但仅是入场券。真正的挑战在于让十万张卡像一个整体那样高效运作。
单卡能力有限,大规模集群中,中间结果的交换至关重要。若存储供不上、网络抖动或调度混乱,账面算力再高也难以转化为实际效能。这并非简单的堆砌,而是如同让十万个单元同步完成一个动作,配合精度决定整体速度。
规模只是起点,将规模有效组织起来,才是核心技术壁垒。
02 从万卡到十万卡:竞争赛道切换
从万卡跨越至十万卡,不仅是数量增加,更是系统复杂度的指数级上升。通信链路增多使得信号出错概率被放大,成为系统日常必须处理的难题。
竞争重心已从单芯片的“单兵作战”转向计算、存储、网络和软件协同的“体系作战”。科研人员需要的不仅是更快的卡,更是能长期稳定交付结果的系统。
关键在于超节点技术。其核心逻辑是减少数据无效传输:通过 Scale-up 互连将一组计算单元紧密组织,使其像一台计算机般工作,再通过 Scale-out 网络向外扩展。
曙光8000 将这一方法应用至十万卡、超万个计算节点的规模,打破孤岛效应。作为国内首个全国产十万卡 AI 超集群及国家超算互联网核心节点,它实现了毫秒级连通全国三十多个节点。
03 规模化方法的标准机柜落地:scaleX40
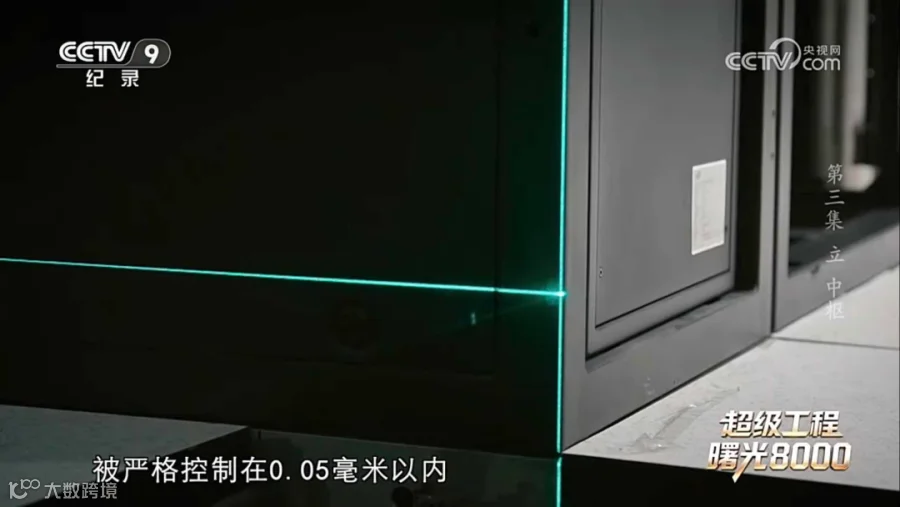
对于大多数企业而言,重建国家级集群不现实。面对大模型训推需求,scaleX40 提供了更具可行性的解决方案。这款标准 19 英寸箱式设备,在单一系统内集成 40 张 AI 加速卡并支持全互连,形态上与普通机柜无异。
其核心价值体现在解决三大痛点:
- 超过 5TB 总显存:解决大模型单卡无法加载的问题;
- 40 卡聚合带宽超 17TB/s:消除多卡通信中的等待延迟;
- 无线缆正交对接:降低复杂布线带来的故障率与维护成本。
scaleX40 并非曙光8000 的简单缩小版,而是同一套系统方法在不同规模上的落地平衡点,既满足大模型训练与高通量推理需求,又避免了大型集群的建设负担。
04 软硬一体:确保算力“送得到、跑得完”
硬件之外,数据供给、软件调度与运维恢复同样关键。若缺乏配套软件,高性能硬件可能沦为忙闲不均的资源。
曙光提供了一体化方案:ParaStor 确保数据及时抵达计算单元,SothisAI 覆盖训练、推理、调度与运维全流程,支持断点续训与故障恢复。
简言之,超节点聚合算力,存储保障数据供给,平台确保任务持续稳定运行。这不仅服务于大模型训练,更面向金融风控、科研教育等行业应用,核心目标是稳定交付结果。
05 通用算力底座:128核 CPU 的兼容价值
除 AI 超节点外,曙光新一代通用高性能计算平台以国产通用 CPU 为核心,面向气象、工业仿真等领域。其显著特征是单颗 128 核心,FP64 双精度峰值约 10T,并原生兼容 x86、支持 AVX-512。
“原生兼容 x86”意味着企业无需推倒重来,可平滑延续几十年积累的软件与工程经验。这种低迁移成本往往比单纯的峰值算力更具实用价值。
该平台同样强调系统协同:HPC-Kit 进行软件优化,ParaStor 与 scaleFabric 负责数据供给与高速互连,散热方案从风冷延伸至浸没式液冷。
无论是超节点还是高性能计算,其共同理念在于:不只提供芯片,而是组织算力。
06 结语:稀缺资源从芯片转向组织能力
曙光8000 展现了十万张芯片、一万多个节点的同频共振,但这并非终点,而是一种方法论的验证。
纪录片揭示的产业趋势表明:随着计算规模增长,真正稀缺的资源已从单颗芯片转向组织算力的能力。
未来,当这套系统方法进一步标准化并装入机柜,超节点技术将从纪录片走向更多企业的机房,成为可部署、易运维、能稳定交付结果的计算基础设施。