
自回归视频世界模型已经能让人「走进」一段视频里自由探索,但想从新视角看、想回头看刚才生成的内容、想把一个人的动作套到另一段视频上,往往要专门训模块或额外微调。西湖大学 AGI Lab 的 World in World 把这些控制能力收进一个推理时的接口,冻结的骨干一行权重都不改。
自回归视频世界模型支持交互式、长时序的探索,但灵活控制仍是难点:从新视角重看一段源视频,要求生成结果既和已录事件保持同步,又把观测内容放到目标视角、合理补全新暴露的区域,并在回看时恢复之前生成的外观。现有方法通常用任务专用模块或额外训练来应对这些要求。
“World in World” 技术让一个冻结的视频世界模型(LingBot-World 2.0,14B)能够“步入”普通视频之中:只需给定一条新的摄像机轨迹,它就能从新的视角重新拍摄同一场景——无需训练,无需微调,仅需单张 80GB 显存的 GPU 即可运行。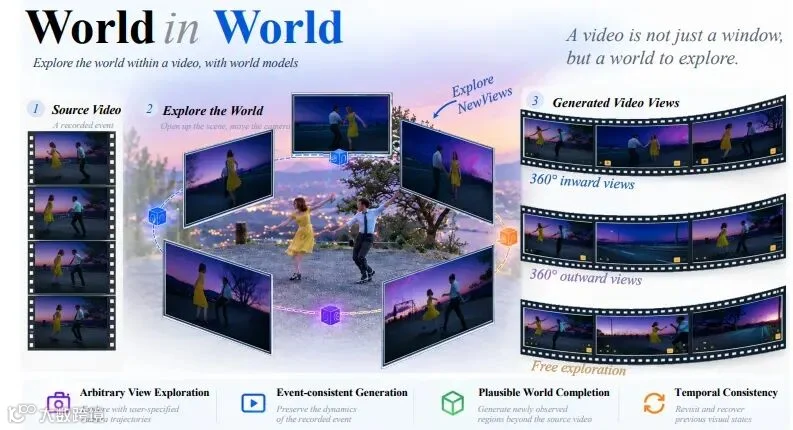
所有需要控制的要素(源视频、场景几何结构、摄像机)都被转化为视觉信息:系统提取源视频帧的深度信息,将其根据新摄像机视角进行扭曲变换,并作为额外的键(Key)和值(Value)输入到模型的注意力机制中;这样,模型既能“看到”新摄像机视角下应有的画面,又能自行补全其余部分。
相关链接
-
论文:https://arxiv.org/abs/2609.11548 -
代码:https://github.com/Westlake-AGI-Lab/WorldinWorld -
主页:https://chenxi-song.github.io/worldinworld -
模型:https://chenxi-song.github.io/worldinworld/#hero -
协议:CC-BY-NC-SA 4.0(非商用;据项目信息需 80GB A100,峰值 72GB,权重约 86GB)
内容介绍
World in World 的卖点不是更大的模型,而是「不改权重也能控」。它把探索视频世界时最常需要的几种操作——换相机角度、长时间回头看、把动作迁移到别人身上——统一成一个推理时接口,全部复用冻结骨干原生的注意力机制。这意味着你拿到一个预训练好的视频世界模型,不需要再为每种控制需求单独训一个模块。
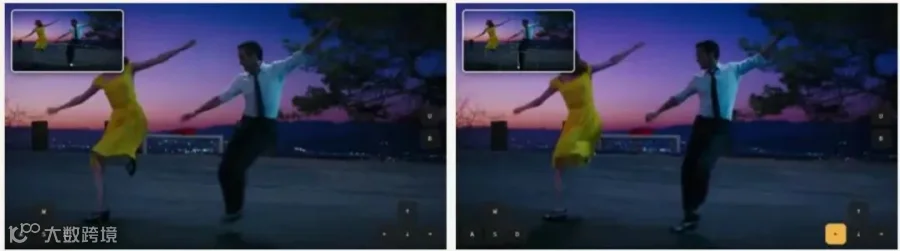
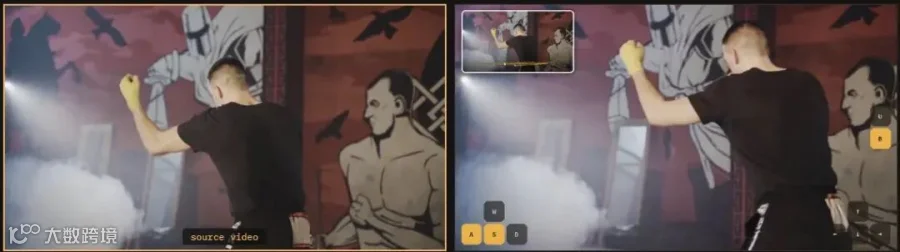
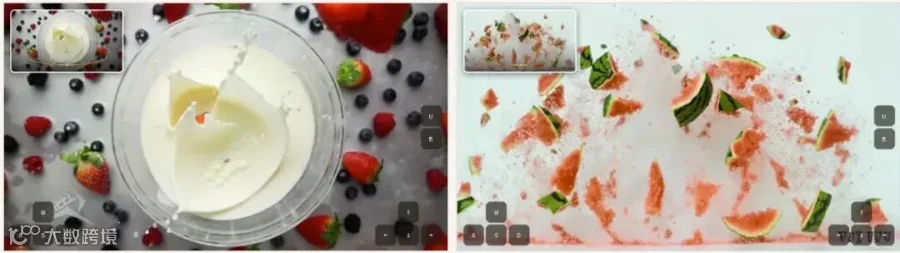
从展示的能力来说,它覆盖了 360° 重运镜(绕着场景转、从内部转身)、视角切换、长时序生成、视锥记忆(看向别处再回头时,带记忆的回看与无记忆的回看差异明显),以及动作迁移(源视频 + 驱动视频,把驱动视频的动作套上去),并由 3D 身体先验保证人体动作不断裂。
方法概述
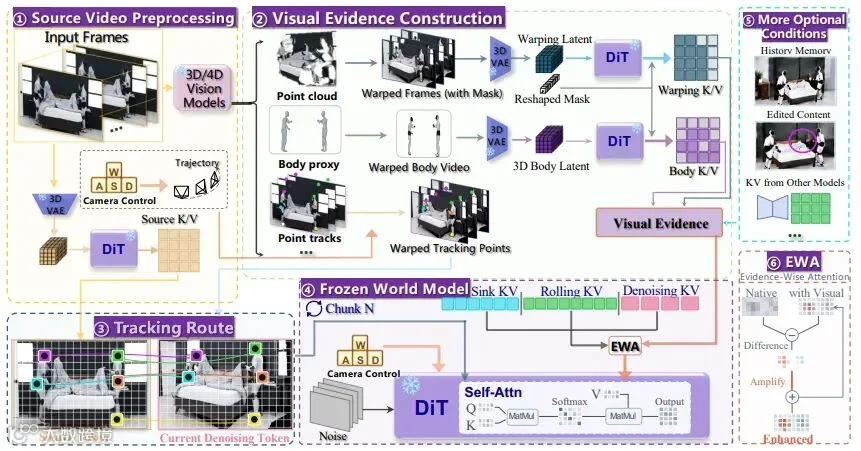
1. 把控制证据变成「干净视觉状态」
接口的核心是把不同来源的控制信号统一成带相机标签和时间标签的 clean visual state,再交回冻结的因果视频模型。证据有四类:源视频观测(保留已发生事件)、目标视角场景投影(指定想看的角度)、几何渲染(引导补全转视角后新暴露出来的主体区域)、以及从滚动缓存之外检索到的已生成状态(支撑长时序回看)。
2. 对应路由:用点身份 + 几何建立 token 对应
各类证据不会自动对齐。对应路由把「持久的点身份」与几何信息结合,建立 token 级别的对应关系,把带有支撑的查询导向与之匹配的源视频 token。这保证了重渲染时新视角下的内容能正确地「接回」原视频里对应的物体与位置。
3. 证据级注意力 CFG(EWA)
不同辅助通道(相机、几何、记忆)对生成的贡献不能一刀切。EWA 在同一个去噪前向过程里,用注意力响应独立调节每个辅助通道的额外贡献,从而在不破坏骨干原生生成质量的前提下,按证据强度精细控制各路引导。
实验结果
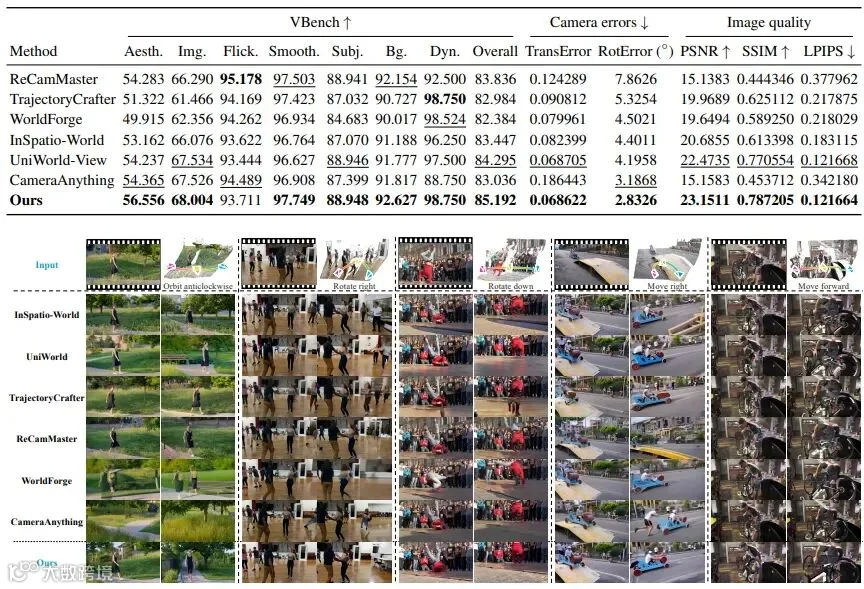
论文在「相机控制下的视频重渲染」上评测,覆盖多种视角变化,指标为感知质量(perceptual quality)、时序一致性(temporal consistency)与相机跟随准确度(camera-following accuracy)。
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|

局限与未来方向
-
非商用协议:CC-BY-NC-SA 4.0 限制商用,任何商业化使用前需确认许可边界。 -
算力门槛高:据项目信息需 80GB A100(峰值 72GB、权重约 86GB),个人开发者难以本地复现。 -
量化结论未随摘要公开:感知质量、时序一致性、相机跟随准确度的具体分值需回原论文,横向对比其他视频世界模型控制方法时应以原文数字为准。 -
骨干依赖外部:方法建立在「冻结因果视频模型」之上,其效果上限受骨干能力约束;论文未披露是否对多种骨干做过验证。 -
骨干型号需以官方为准:项目信息指向 LingBot-World 2.0 14B,但论文摘要未点名,引用时建议以官方披露核对。
结论
World in World 的价值在于把「控制」从训练里剥离出来,证明一个冻结的视频世界模型也能通过推理时接口获得相机运镜、长时记忆与动作迁移。对关注世界模型方向的读者,它是「世界模型如何变得可交互」的一个干净样本。
-
对研究员:training-free 的接口设计值得借鉴,尤其 EWA 与对应路由的组合,可迁移到其它自回归生成模型的控制问题。 -
对工程落地者:非商用 + 80GB 显存门槛意味着短期只能做研究与原型,量产前需解决协议与算力。 -
对内容创作者:把「走进视频、换个角度再看一遍」讲成「世界模型的可交互探索」,是视频生成选题里很抓人的角度。
风险提示:CC-BY-NC-SA 4.0 不可商用,高显存门槛限制本地复现;具体性能以官方论文数字为准。
世界模型真正的分水岭,也许不是「生成得多真」,而是「生成之后,你能不能像导演一样重新调度它」。
感谢你看到这里,添加小助手 AIGC_Tech 加入官方 AIGC读者交流群,下方扫码加入 AIGC Studio 星球,获取前沿AI应用、AIGC实践教程、大厂面试经验、AI学习路线以及IT类入门到精通学习资料等,欢迎一起交流学习💗~