

导读给任务多配几个 Agent,结果未必更好。Google 的受控实验显示,多智能体在不同任务上可能带来相反的收益;Anthropic 的电商系统则把大量能力放进一个 Agent 的工具和 Skills 中。本文按一个工程决策顺序展开:先建立单 Agent 基线,判断工作能否独立拆分、状态是否需要持续共享,再说明多个工作循环怎样被编排、交接和验收。实验中的数字是线索,最终选择仍要回到自己的任务上验证。
本文 2182 字,阅读约 5 分钟|先看结果 → 工作能拆,不代表会话适合拆 → 确实要拆,多 Agent 怎么跑起来 → 一个更稳妥的选型顺序
先看结果:同样增加 Agent,有的任务受益,有的退步
设计 Agent 系统时,最容易先画一张角色图:规划者、执行者、审查者各司其职。图画完了,问题才冒出来——原本一个 Agent 做的事,拆开以后究竟快了、准了,还是只增加了交接?
一项题为 Towards a Science of Scaling Agent Systems 的研究做了较系统的对照:在六个任务基准上测试 260 种配置,比较单 Agent 与独立并行、集中协调、分散协作、混合式四类多 Agent 结构。研究者尽量统一工具、提示和计算预算,用任务成功表现观察架构差异。
结果没有形成一个“多 Agent 更强”的统一答案。在论文的 Finance Agent 财务分析基准中,四类多 Agent 架构相对单 Agent 的平均成绩高出 57% 至 80.8%;在要求按顺序满足约束的 PlanCraft 规划基准中,四类架构的平均成绩反而低了 39% 至 70%。这是各自在同一基准内相对单 Agent 的变化,不能拿两个基准的百分数互相比高低,也不能直接预报实际业务的收益。
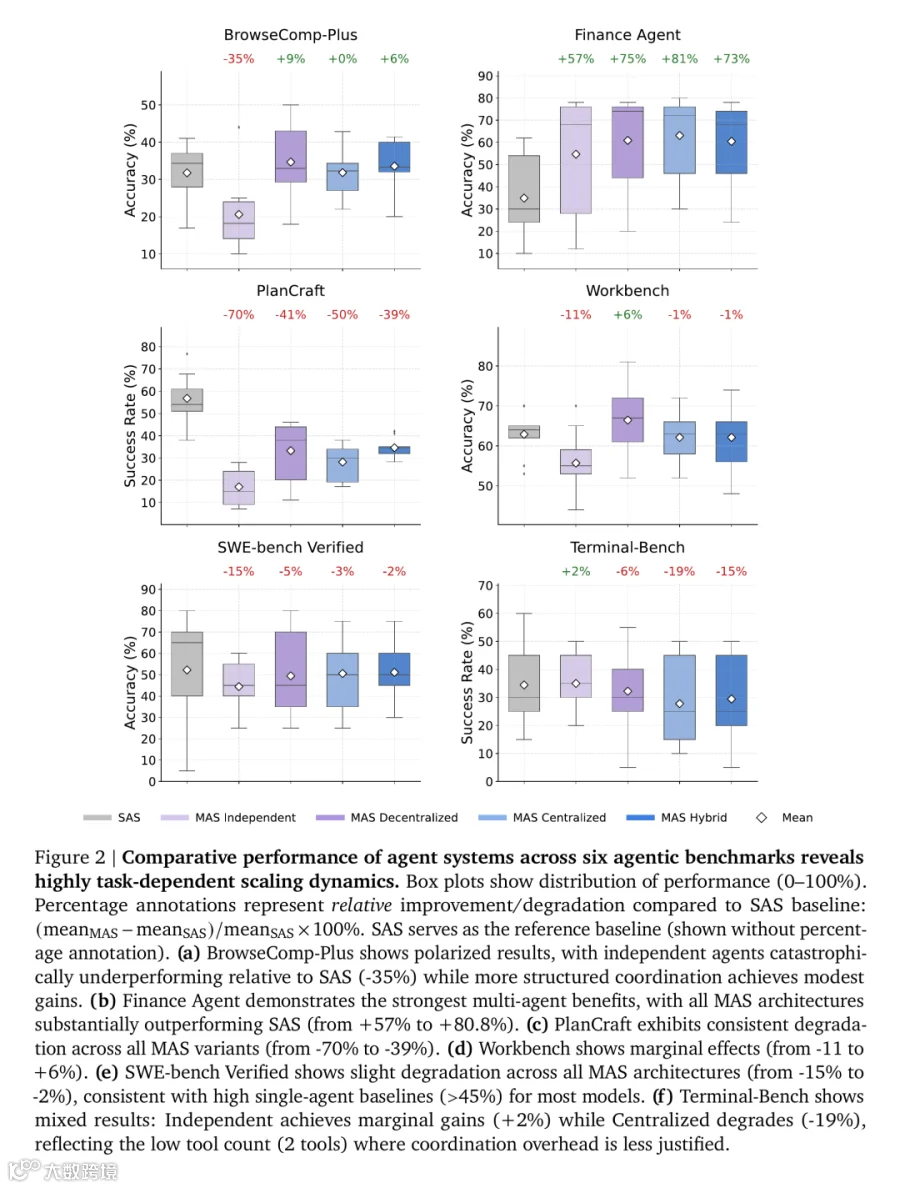 图片说明:论文 Figure 2 比较六个基准中的单 Agent 与四类多 Agent 架构;图中彩色百分数是相对该基准单 Agent 均值的变化,不是成功率的百分点差。 图片来源:Towards a Science of Scaling Agent Systems,arXiv v3
为什么方向会反过来?论文的执行轨迹给了一个具体解释。Finance Agent 的收入、成本、市场等信息流可以分别分析,再合成判断;PlanCraft 的步骤则带有较强的先后约束,后一步依赖前一步的状态。把后者硬拆成多个角色,消息传递和状态对齐可能吃掉分工收益。
第一步因此是测自己的单 Agent 基线。在固定的任务集、工具和预算下,记录它完成了多少任务、耗时多少、主要错在哪里。论文给出过约 45% 的单 Agent 基线分界现象,但那是由所测任务和模型拟合出来的数值;自己的系统不能把“超过 45% 就不加 Agent”当作现成规则。
工具数量同样不是开关:论文中工具密集的任务更容易受到协调开销拖累,但个别架构仍取得小幅收益。最终要比较的,是新增信息或纠错价值能否覆盖消息传递、状态同步和重复工作的成本。
工作能拆,不代表会话适合拆
判断是否分工,还要看子任务交出的是什么。如果每块工作有相对独立的输入、产物和检查标准,并行可能有用;如果每一步都要共享正在变化的状态,交接本身就成了工作。
Anthropic 在电商 Agent 的工程说明中给了后者一个实例。用户的一段购物或售后会话,可能同时涉及当前购物车、订单历史、偏好、商品目录。它采用一个模型持续运行的 Agent 循环:模型按需要调用工具、读取 Skills 中的操作方法,获取反馈后继续处理同一会话。Skills 是供这个 Agent 使用的能力说明,并不是一组接力回答的子 Agent。
 图片说明:同一个模型循环调用商品搜索、购物车等工具,按需使用 Skills 和记忆;底部的 harness 负责运行循环及执行审批。 图片来源:Anthropic,《A guide to the anatomy of effective commerce agents》
Anthropic 的理由很实际:若按业务域各建一个子 Agent,退货流程可能刚读完订单又要查询购物车和商品目录;每次交接都要传递用户意图和当前状态,漏掉其中一部分就可能答偏。该团队报告,这类交接还会增加 token 和时延。这是其电商场景中的工程经验,不能外推为“所有多 Agent 都不适合生产”。
两份材料共同提示一个判断变量:任务的耦合方式。财务信息流可以相对独立地收集、核对,再合并;一段连续购物会话更需要让同一执行者持有不断更新的状态。即使都叫“复杂任务”,复杂的来源也不同。
确实要拆,多 Agent 怎么跑起来
通过前两步,才轮到协作架构。单 Agent 常用的 ReAct(Reasoning + Acting,交替推理与行动)可以看作一个内循环:模型根据当前目标和工具返回的结果选择下一步,调用工具,把新观察写回上下文,直到完成或触及停止条件。
一种最小实现,是在多个这样的工作循环外面加一层编排。外层程序为每个工作者创建独立上下文,调用模型与可用工具,并负责并发调度、超时和结果回收。总任务可以由主 Agent 拆分,也可以按预设规则拆分;每份子任务都要写明问题、可用的输入与工具、预期交付物和停止条件。工作者在各自的上下文里运行工具循环,可以调用同一个底层模型。能独立产出结果的子任务可以并行,有前后依赖的子任务仍须按顺序交接。
交回来的也不该只是一句“完成了”。以资料研究为例,工作者应返回结论、依据和未解决的问题;做代码任务则交回修改、测试结果与已知失败。编排者检查重复或冲突,交给测试工具或独立审查环节验证;不合格就退回修订,合格后才合成总结果。需要共享的状态要明确通过任务输入或持久化产物传递,不能假定一个工作者自动知道另一个工作者的上下文。这套编排、交接和验收,就是单 Agent 循环之外新增的工程工作。
Google 在 Teamwork 的官方说明中把这件事做成可按任务选择的协作模式。以分布式编码为例,编排者先拆解目标,多个工作者分别尝试实现,批评者检查方案,验证者运行构建和测试;未通过时,结果返回继续修改。开放式数学问题则换一种组织法:并行提出候选路线,同时安排专门寻找反例的角色,失败路线连同反对意见留下,供下一轮使用。
这里值得借鉴的不是预设几个 Agent,而是让每一次交接都有可检查的产物。Google 展示的是它公开的产品机制与案例,不能据此认定这套模式对任意业务都优于单 Agent。
一个更稳妥的选型顺序
如果手上有一个准备扩成多 Agent 的任务,我会按四步做小规模对照。
下面这张图先标出三个判断关口:基线提供比较对象,任务耦合决定是否适合拆分,同任务复测检验新增协作是否值得保留。它是本文的工程归纳,不代表某一篇论文给出的固定流程。
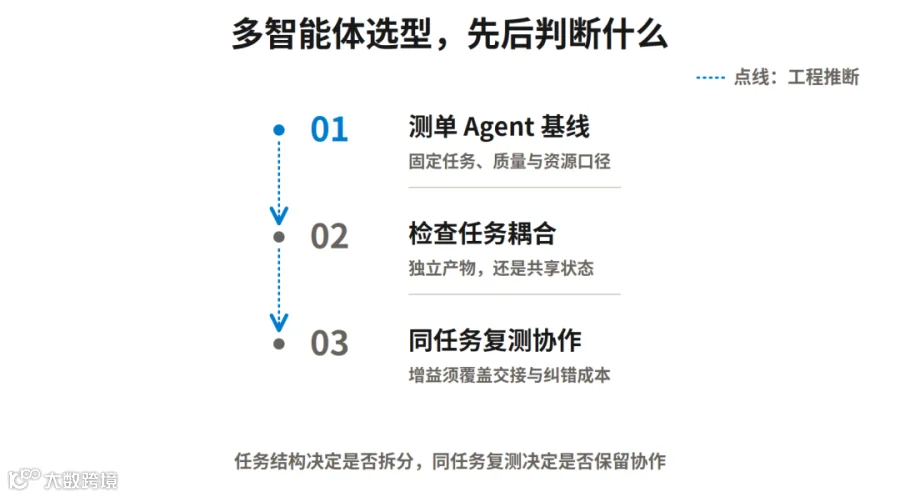
1. 固定任务与口径:留下一组有代表性的输入、预期产物和判定方法,让单 Agent 先跑。记录成功率或完成质量,同时记录耗时、调用量和典型错误。
2. 找天然的分界:标出能独立产生结果的部分,以及必须共享实时状态的部分。前者才是并行候选;后者先考虑在一个 Agent 循环内用工具和 Skills 处理。
3. 只增加必要角色:先试最小的分工,把输入、输出、共享状态和退出条件写清。若缺的是纠错,就增加真正能指出证据或测试失败的审查环节,而不是只多生成一份相似答案。
4. 在相同任务上复测:比较最终质量、完成时间、资源消耗与新出现的交接错误。收益不稳定时,回查任务拆法和验收机制,再决定是否扩展。
这四步是根据研究和官方案例整理的工程判断顺序,不是论文保证有效的统一配方。它也把问题从“应该组建多少个 Agent”,推进到更可检验的一句:多一次协作,究竟换回了什么可验证的收益?
参考资料
论文《Towards a Science of Scaling Agent Systems》,arXiv v3: https://arxiv.org/html/2512.08296v3
Google Antigravity,Teamwork: When AI Becomes a Research Partner: https://www.antigravity.google/blog/teamwork-when-ai-becomes-a-research-partner
Anthropic,A guide to the anatomy of effective commerce agents: https://claude.com/blog/the-anatomy-of-effective-commerce-agents
论文《ReAct: Synergizing Reasoning and Acting in Language Models》,arXiv v3: https://arxiv.org/html/2210.03629v3
Anthropic,How we built our multi-agent research system: https://www.anthropic.com/engineering/multi-agent-research-system
— THE END —
文章仅做学术分享,如有侵权请联系删除,非常感谢!