


Lazada 作为服务六国的电商平台,如何让各国数据打通利用、互利互惠,是电商系统面临的特点和难点。生成式推荐(Generative Recommendation, GR) 作为近年来工业界研究热点,在多国场景下具备天然的优势,但也存在着结构性矛盾:A国的商品永远不会出现在B国用户的行为上下文里。这导致知识只通过模型参数流动,数据层面完全隔离,大市场里丰富的行为信号从未真正“喂到”小市场。
大模型里的研究指出,模型的跨语言能力来自code-switching的语料。受此启发,我们尝试在多国场景下,构造GR里合法的code-switching语料,从数据层面实现各国市场的显示交互。具体来说,我们首先构造了各国统一的语义码本,之后利用码本对各国数据进行token级别的合法替换,最后再将各国数据和构造的混合数据联合训练,实现各国之间知识的共享。
实验表明,在公开数据集和阿里工业级数据集上全面超越现有方法,大国和小国均有涨幅,且小国涨幅更大;线上A/B实验带来整体广告收入+1.77%、成交单数+2.64%的提升。
论文:《Cross-Country Code-Mixing for Generative Recommendation》
作者:Yuan Gao*, Hao Deng*, Haibo Xing, Yi Xu, Lingyu Mu, Jinxin Hu, Yu Zhang, Xiaoyi Zeng
会议:CIKM 2026(Rome, Italy)
1. 背景:参数共享了,数据还是各过各的
Lazada 作为服务多个国家的电商平台,以往各国独立部署、独立记账,用户交互只在本国发生,用户 ID 与商品 ID 完全分治。这不同于经典的跨域推荐(Cross-Domain Recommendation, CDR),往往存在着共享用户、共享商品,或人工锚定的实体,把协同信号从一侧带到另一侧。因此,如何将各国数据如何打通、互惠互利,成为跨国电商系统的一个巨大挑战。
近期大火的生成式推荐(GR)提供了一个看似自然的解法:模型先把每个商品编码成离散语义token (SID),再根据用户历史,自回归地生成目标商品的 SID。如此可以使得各国商品编码到统一空间,并通过模型的学习,使用模型参数实现各国知识的隐式共享(如 GenCDR、GMC)。然而,现在的做法缺少数据层面的显示交互,在跨国条件下,各国的交互序列都是在本国内发生的,用户不会先在泰国点一双鞋、再在越南买一件同款,这导致了国家间知识传递的困难。
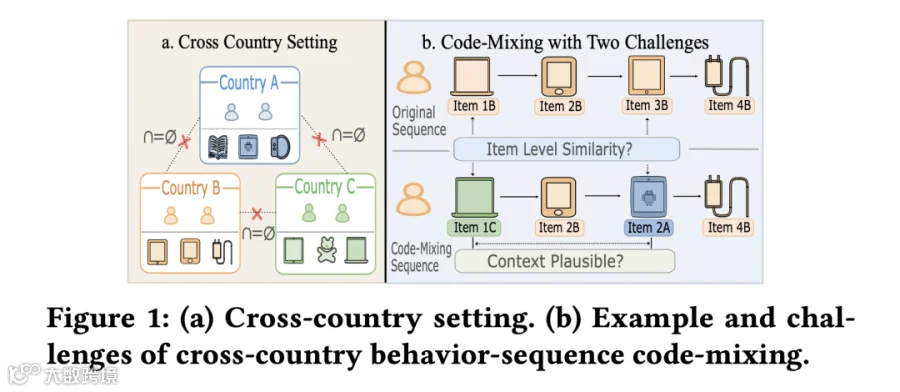
大模型里的研究指出,模型的跨语言能力来自code-switching的语料。code-switching是一种语言学现象,指一句话中出现多种语言的混合(比如中英夹杂),这类语料对模型的小语种能力有很大帮助。受此启发,我们希望构造跨国场景下的混合交互数据,使得大国市场的知识通过数据混合的方式帮助小国市场。然而,在电商场景下构造跨国混合语料并不简单,存在如下挑战:物品级相似不明确。 长得像,不等于在市场上能互换。内容相似会漏掉两类同样关键的信号:行为(共点、共购)和市场动态(价格带、受众、热度)。两国「看起来一样」的商品,完全可能一个是高端爆款、一个是滞销尾货。只看内容,等于往训练里灌噪声;上下文粒度太粗。 即便一对商品单独看合理,也可能和当前用户意图冲突。一条序列如果明显是苹果生态,把下一件换成内容相近的安卓平板,句法上说得通,语境上是错的。任何离线的「商品对过滤器」都看不见这一点。
基于此,我们提出CMRec的方法:
结果表明,CMRec在公开和工业数据集上均取得最优效果,在线AB广告收入 +1.77%,成交单数 +2.64%。
2. CMRec:带双约束与上下文感知的跨国 Code-Mixing

整体流程包括如下步骤:
2.1 行为 + 内容共享码本
首先,使用多模态大模型(Qwen2.5-VL)把标题、图像编成内容向量,并使用双塔 i2i 模型注入行为信息得到的物品向量。之后,使用RQ-VAE等tokenzier把向量编码成 token 序列。这套码本一身二职:给 GR 当 tokenizer,也给后面的替换当「公共语义坐标」。
2.2 双约束下的 token 级混合
我们希望各国数据做合法混合,为此提出了一套跨国混合数据的方法。具体来说,按比例把各国序列中的历史商品、以及目标商品,替换成其他国家的近邻,合成一条“混国序列”。每次替换,不同国家的商品需要满足下列约束:
- 语义内容约束
token 序列的 Hamming 距离不超过阈值,保证语义编码足够近; - 动态行为约束
对价格、受众、热度等 side-info 先按国做分位数分桶,再算余弦相似度,保证市场角色也接近。
只有满足上述条件,才会把商品替换成其他国家的相似商品,以此构成近邻集合N(𝑖):
2.3 上下文自适应GR训练
上述方法能保证替换商品在内容、行为上是相似的。然而,对一条由 (x, y) 生成的混合样本 (x′, y′),我们希望其在训练时是上下文合法的。具体来说,我们定义了权重用于刻画当前替换的上下文合法性:
最终训练损失为:
3. 实验结果

-
在公开数据集和阿里工业数据集上,均取得最优效果,并且小国收益更大; -
在线AB:广告收入 +1.77%,成交单数 +2.64%。
4.参考文献
[1] Recommender Systems with Generative Retrieval
[2] Actions Speak Louder than Words: Trillion-Parameter Sequential Transducers for Generative Recommendations
[3] Reg4Rec: Reasoning-Enhanced Generative Model for Large-Scale Recommendation Systems
[4] Sparse Meets Dense: Unified Generative Recommendations with Cascaded Sparse-Dense Representations
[5] Generative Recommendation Models: Progress and Directions
5. 关于我们
我们是阿里国际-智能技术-Lazada推荐广告算法团队,我们致力于融合前沿深度学习、生成式推荐、用户超长序列建模、多场景建模、大模型算法等技术构建工业级推荐大模型,通过更深刻地洞察用户个性化偏好与决策逻辑持续助力商家投放效益与平台收益的快速增长。近年来,我们在前沿算法领域持续深耕,已经在WWW、SIGIR、CIKM、WSDM等顶级学术会议发表了多篇高质量论文。也欢迎感兴趣的同学加入我们,共同开创AI推荐的新篇章。

点击上方名片,关注我们吧~