


题目:TiDAR: Think in Diffusion, Talk in Autoregression
论文地址:https://arxiv.org/pdf/2511.08923
创新点
•提出 TiDAR 序列级混合架构,扩散并行做草稿思考,自回归完成最终对话输出,在单个模型单次前向传播内融合两种生成范式,不需要独立的草稿子模型,把扩散的高吞吐并行优势和自回归文本的流畅高质量结合在一起。
•设计结构化因果 - 双向混合注意力掩码,同一套模型可以同时学习自回归目标与扩散目标,在同一条样本上同时计算两类损失,训练简单、数据效率高,保证训练和推理一致性。
方法
本文提出 TiDAR 一体化混合架构,在同一个模型内部融合扩散并行生成与自回归生成两种范式,采用专门设计的结构化因果 - 双向混合注意力掩码,使模型能够在同一条样本上同时学习自回归目标与扩散目标并联合计算损失,训练阶段使用统一模型同时完成双向扩散草稿预测和因果自回归文本学习,推理时借助 GPU 中空闲 token 槽位并行生成草稿内容作为中间思考,再由自回归模块输出最终流畅文本,整个过程不需要额外独立草稿模型,并且原生兼容 KV 缓存,通过在不同参数规模模型上开展多组生成评测与消融实验,同时结合扩散语言模型与推测解码的理论视角,验证该架构在提升吞吐的同时维持文本生成质量。
TiDAR 的v token 槽位推理延迟分析
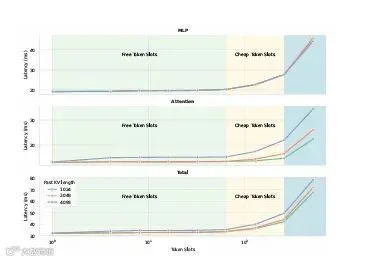 本图分为 MLP、注意力模块与整体总延迟三张子图,横轴代表 token 槽位数量,纵轴为推理延迟,不同颜色曲线代表不同 KV 缓存长度,图中将区域划分为免费 token 槽位、低成本 token 槽位与高开销区域,展示随着 token 槽位增加,推理延迟的变化趋势,在免费与低成本区间内增加 token 槽位带来的延迟增长很小,只有进入高开销区域后延迟才会快速上升,以此说明 TiDAR 可以利用空闲 token 槽位并行生成扩散草稿,几乎不带来额外推理成本,验证该架构能够借助硬件空闲资源实现并行思考。
TiDAR 推理过程示意图
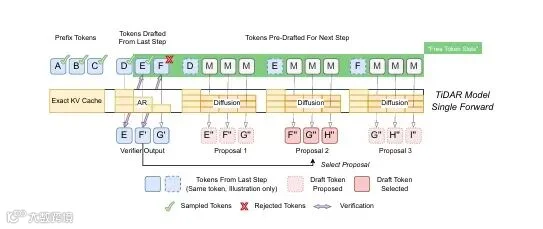
展示 TiDAR 单步前向的完整推理流程,左侧前缀 token 作为上下文,上一轮生成的 token 进入模型,在免费 token 槽位区域利用扩散模块并行预生成多组草稿候选序列,自回归模块负责校验已生成 token 并产出验证输出,整套过程复用精确 KV 缓存,在单次前向传播里同时执行自回归校验与扩散草稿提案,模型会从扩散生成的多份提案中挑选合适的序列进入下一步迭代,图中标识了采样通过的 token 与被拒绝的 token,直观体现 TiDAR 借助扩散在空闲 token 槽位并行草拟候选内容,再依靠自回归做校验筛选的混合生成机制。
TiDAR 训练与解码阶段的混合注意力掩码

分为左右两个子图,左侧是训练阶段掩码,右侧是解码阶段掩码,图例区分因果注意力与双向注意力,空白位置代表被屏蔽不可见的 token,训练掩码在干净前缀部分使用标准因果掩码保障自回归学习,在附加的空白 M token 区域启用双向注意力用于扩散草稿的并行预测,让模型在同一次前向传播中同时学习自回归与扩散两类目标;右侧解码掩码用于推理过程,同样组合因果和双向注意力,在已确定的真实 token 上维持因果自回归约束,在 M 空白 token 槽位使用双向注意力并行生成多组扩散草稿提案,整套掩码设计统一了训练与推理的注意力规则,使 TiDAR 单个模型能够无缝切换或同时执行自回归校验和扩散并行草稿生成。
实验

该表格对比不同模型架构与参数量在代码、数学两类基准任务上的性能,代码任务包含 HumanEval、HumanEval+、MBPP、MBPP+,数学任务包含 GSM8k 与 Minerva Math,最后给出各项指标平均分,参与对比的模型包含 Llama3.2、SmolLM2、Qwen 系列、Block Diff、LLaDA、Dream 以及不同版本的 TiDAR,分别测试 1.5B 与 8B 参数规模,TiDAR 分为 Trust AR 和 Trust Diff 两个变体,括号内为额外评估指标,实验结果表明同等参数量下 TiDAR 相比 Block Diff 等扩散语言模型基线有明显提升,性能接近同规模自回归大模型,验证该混合架构可以在保留高吞吐优势的同时维持代码与数学推理能力。