


软件架构师罗小东,多年架构和平台产品设计经验,目前在 Agent 场景落地结合中。
一个很明显的感觉:25 年做的 Agent,到 26 年很可能就得推倒。
概述
这是一个能源领域的 Agent 项目,偏工业方向。需求是输出企业能效评估报告:依据领域政策、行业论文、数据要求和各类指标,再结合企业近一年的实际数据整理成文。
目标是把原来要熬好几周才出的报告压缩到天级,同时把人从重复劳动里解放出来。
项目从 25 年三季度初着手,到现在开始内部交付使用,进入交付培训阶段,前后差不多一年。
这里我从 Agent 应用架构师的角度讲一下这个过程的心得。我这边主要输出技术方案,以及和业务结合的解决方案;业务层面由另一位架构师和业务专家负责,我同步做这次复盘。
整个架构走了几步转变:ReAct → Workflow → Harness → Agentic 结合,中间还有一次 RAG 知识库的架构调整。
25 年前期,我看到几个绕不开的问题:
-
• AI 迭代和范式会超过所有预期,设计上必须超前。 -
• 不要纠结过程的设计,AI 会逼着淘汰上一代设计。 -
• 真实业务场景的数据复杂度,是网上示例想不到的。
这个过程大概经历了几个阶段:
-
• 从使用各类开源到放弃:媒体营销过度,实际用上会发现需要大量定制能力; -
• ReAct 到 AIWorkflow 的 Java 自研:为解决模型能力不可控,Agent + Workflow 结合; -
• Harness 架构升级,达到可以做事:OpenClaw 范式,全面 Harness 本地化; -
• RAG 知识库架构调整:放弃向量片段检索,拥抱 Claude Code 的设计。
无法规避的问题
团队如果没有一定的 Agent 应用专家储备,这件事基本就没下文了。这里说的主要是 25 年的情况。

AI 迭代和范式会超过所有预期,设计上必须超前
我听过很多专家的课程,也在源码级别研究过不少开源项目,但那些偏大方向,很难找到一个能看到、能做出来的东西。我们在广西,只要本地听说哪里有相关报道,我就马上上门打探,结果除了 RAG 就是宣发阶段。
热门开源项目参考了很多,选的是 LangChain、Dify 这一类范式。但论文和 AI 的发展,特别是 Agent 能力的提升,要求你后期能适配上去。

没办法,只能重新设计。基于团队擅长的 Java 技术,因为只有这样才能做到兼容。又靠着前期做平台架构的经验,做了服务模块的拆分和底层能力提取。
后来证明这一步是对的,它也正是后面 Harness 层的基础。
不要纠结过程的设计,AI 会逼着你淘汰上一代设计
前期在 ReAct 和 AIWorkflow 上投入了差不多一年的时间。你可以把它理解成另一个 Dify 或者 FastGPT。最后你会发现,它的难用程度真不是一般人能理解的。
难用不是产品不行,而是你要做出高级场景时,除非对 Agent 非常熟,否则根本做不出来。做出来最多的就是知识库,但那不是我们想要的。复杂流程做出来以后,调试成本和易错性都非常大。
看过 Coze 上各种工作流,你要真的把它完善、调试、再调整,除非你很熟悉,否则培训成本和人员切入成本都很高。
再加上大家对 AI 的认知偏差,要用起来真的很难。团队里会有冲突:伙伴做出来的东西,走一遍 Demo 流程,发现很多限制;但大家普遍觉得 AI 什么都该能做,这些限制就不符合"AI"这个概念了。
真实业务场景的数据复杂度,是网上示例想不到的
接到的 Agent 需求不像功能那样,一条条能列清楚。往往就是一句说明,告诉你要做成什么样子。要的是 AI 能力,不是 CRUD 功能。
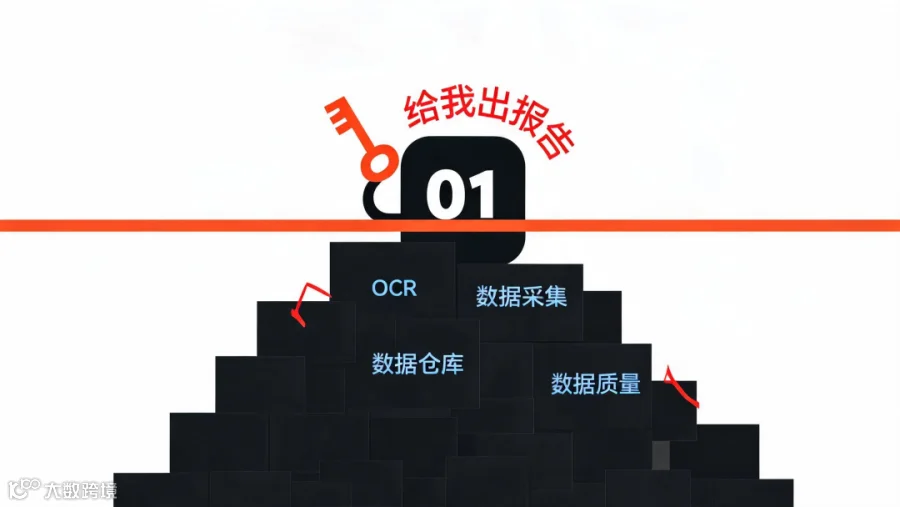
业务场景长这样:各类型多模态数据,几十个 Sheet、上百份文件直接丢给 AI,然后一句话——"给我出报告"。之前遇到过其他团队要做标书 AI,几百 M 文件直接上传,等着 AI 自己投标。

交付的同事第一反应就懵了。等把政策抓取、各类文件解析这些前置工作规划完,发现还没轮到 AI 出场,光是给 AI 配套的设施就已经列了一串:高精度 OCR、数据采集、数据仓库、多模态识别、数据质量、数据接口,而且每一项都要准。有开发同事做到这儿就想撤了。
再往下规划,差不多就是一个数据中台的级别。
也见过一些团队,做着做着做成了功能系统:还是原来的业务系统,只在某个功能点上嵌了大模型接口,或者在某个点上加了 AIWorkflow 工作流,多种搭配一起处理。但这类型的"业务 + AI"看不出 AI 能帮你做什么,我们直接放弃了。原因有两个:一是它不符合 Agent 的方向,Coze 空间、Manus 那类产品也不是这个形态;二是它没解决"让 AI 替人干活"这个真正的诉求。
Agent 架构设计与升级
26 年会是 Agent 的普及年。
到25年四季度,我们开始放弃 AIWorkflow 的思路,全面转向 ReAct 架构。模型的发展给了我们信心,于是全面参考 Manus 重新设计,把下层能力提取出来形成 Harness(那个时候还没有这个概念)。
从使用各类开源到放弃
一开始也有点迷茫。媒体营销过度,真上手会发现需要大量定制能力。
原来用的框架是 LangChain4j、AgentFlex 和 Dify。升级的兼容性,还有框架协议(Dify 的 SaaS 版需要授权),加上 AI 迭代太快,有些框架自己都很难跟上,而我们需要快速验证 Agent 能力。
刚开始结合的时候,一个 Agent 基本就是 N 个工作流加各种 ReAct 范式的组合,需要大量场景定制,还要各种脚本拼装。开源的问题有两个:一是需要大量定制,二是新的论文和范式出来,又得再改一轮。
ReAct 到 AIWorkflow:基于 Java 自研
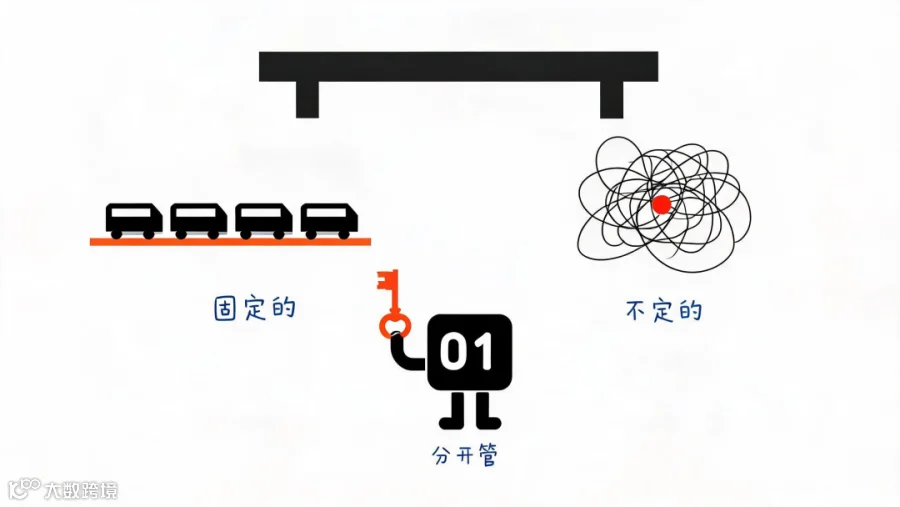
于是自然进入 Agent + Workflow 结合的自研阶段。架构设计其实很简单:把原来的 workflow 做流程规范化,用 ReAct 来处理过程的不确定性。一个管固化流程,一个管推理流程。
在这个过程中,因为原架构设计留了灵活性,沉淀下一批 Agent 组件。这个过程非常耗时,AI Coding 帮了一部分忙,确实提效。
做到这个阶段,你会发现组合起来开始能做一些事情了。但针对复杂场景又冒出一个问题:上层 Agent 调用的时候,你依然要自己写大量底层基础功能。
Agentic 项目还是很难真正用起来,效果相对来讲,不尽如人意。
Harness 架构升级,达到可以做事
OpenClaw 范式,全面 Harness 本地化,Harness 这个概念也就顺理成章地带过来了。
新的概念带来新的方案:桌面版本化,加上 Harness 能力的抽取和规范,方案进一步完善。同时模型能力也在增强,原来大量的底层代码都可以靠 AI 自动编码来解决。
抽取出来的 Harness 层——在业务系统集成过程中,我们对智能体所需的基础能力做了统一的抽象和封装。通用能力包括:
用户画像、上下文、执行沙箱、文件系统、权限系统、MCP/SKILL 工具、消息与事件、计划模式、连接器、专家套件、读写工具、故障恢复、安全规则等。
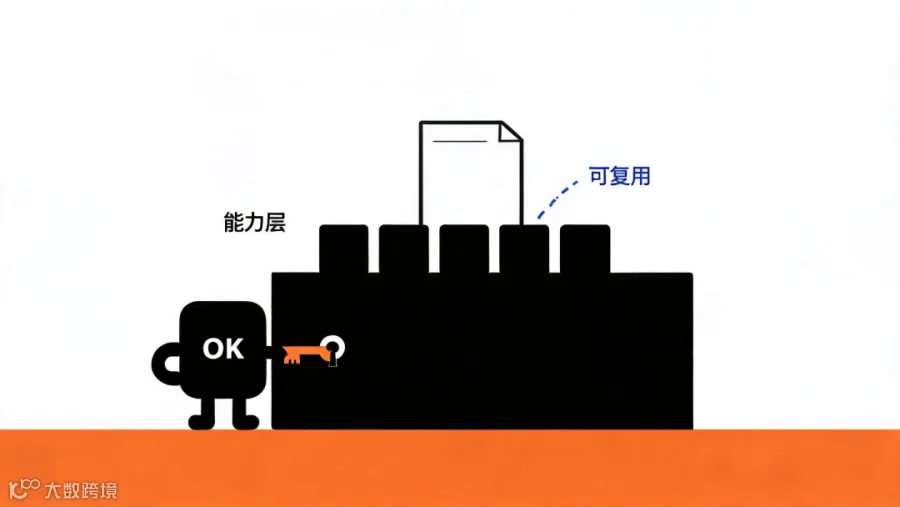
在通用能力之上,针对业务系统深度集成的场景,又扩展了这些能力:界面交互、积分体系、交互模式、工具分层、SKILL 分层、认证系统等。
这些扩展能力主要来自和业务系统结合实践中的抽取、沉淀与封装,是 Harness 框架能力体系的重要组成部分。
到这个时候,桌面是哪一种形式对现在的方案来说就没那么重要了。不管是 OpenClaw、Hermes 还是开源的,那只是在 Harness 引擎外面加一层皮。
桌面版、网页版,还是 TS 版、Java 版,很快就能抽象出来。
RAG 知识库架构调整
放弃向量片段检索,拥抱 Claude Code 的设计。
这个方案主要针对政策文件和行业标准文档的引用场景。在这类内容里,向量片段检索已经不是优先选择的技术路线,因为它容易把原本严谨、成体系的条款切碎,造成上下文缺失、语义偏移,甚至影响引用准确性。
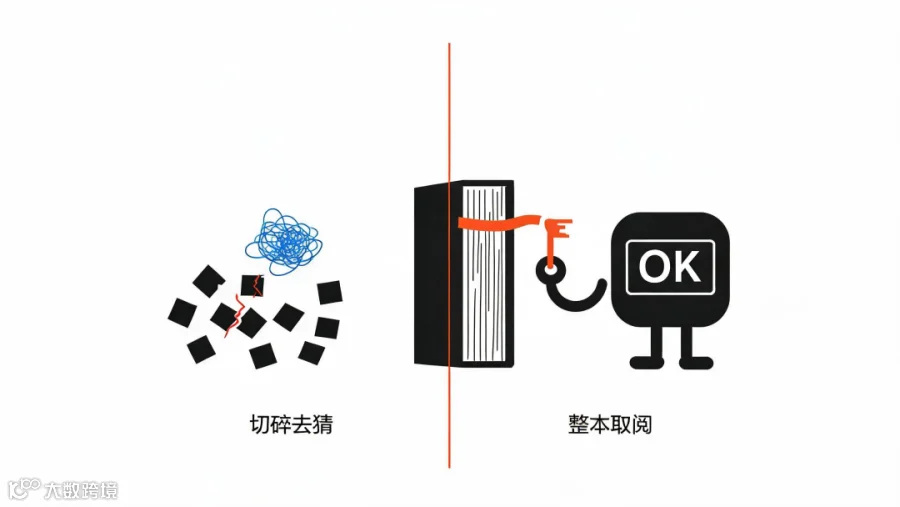
更好的思路是用全文搜索引擎,把文档当成一个可精确检索、可定位、可回溯的原文体系,而不是单纯做语义相似度召回。这样做的效果,类似于在海量代码中精准定位函数、文件、调用关系和关键上下文:不是只看"哪段话比较像",而是要能找到具体条款、章节编号、适用范围、版本来源和前后文逻辑。
再结合桌面版使用,用户可以更方便地打开原始文档、查看完整上下文、核对引用出处、补充关联内容。最终整理出来的报告、分析或引用材料,不仅更准确,也更饱满、更有依据,更接近实际工作中对政策与行业标准文档的使用需求。
总结
这段时间做的项目不只这一个,其他项目上的经验也会同步过来,这个过程也是不断积累的过程。这是当前一个有代表性的项目,里面包含了新技术迭代、架构升级,以及从做不到到达标这整个过程。
我们想要的目标场景是 Agent 自进化,Harness 底层的标准化需要往 Loop Engineering 做准备,这也是目前在规划和准备进一步落地的部分,目的是形成智能体的业务场景和解决方案闭环。一些 Harness 建设的经验分享出来,欢迎有兴趣的朋友讨论。