

今天凌晨,Google 发布了新一代旗舰模型 Gemini 4 Argon。它瞄准的是编程、专业知识工作和网络安全防御,尤其是那些需要持续推理、反复试验的复杂任务。
最显眼的变化是输出上限:从上一代的 64K token 提高到了 100 万 token。首发价格为每百万输入 token 2 美元、输出 token 10 美元。不过,Argon 还没有向所有人开放,第一批使用者是受信任的网络防御团队。
能力也追了上来。在 Artificial Analysis 的独立评测中,Argon 高推理档的智能指数达到 53 分,与 GPT-6 Astra 的最高推理档持平。上一代 Gemini 3.1 Pro Preview 是 30 分,Gemini 3.8 Flash 的高推理档是 41 分。Google 重新回到了前沿模型的第一梯队。
Gemini 4 Argon
这次发布有意思的地方,是 Google 已经把 Argon 用进了自己的工程项目。除了跑分,发布材料还给出了代码迁移、性能优化和数据中心内存优化的具体过程。
Google 已经拿它改自己的代码了
其中一个例子是视频解码器 libgav1。
Google 手里原本已有一份 Rust 移植版本,但它的性能还追不上经过高度优化的 C++ 实现。Argon 接手后,反复进行性能分析实验,查看编译器生成的代码,把原有的 3.2 万行 SIMD 代码替换为可以让编译器自动向量化的安全 Rust 代码。
最终,新解码器在保持视频输出完全一致的情况下,速度达到了原先 Rust 版本的 2.7 倍,接近高度优化的 C++ 版本。
这个过程已经超出了通常的“让模型翻译一段代码”。语言换了以后,内存安全、编译器优化和运行性能都要重新协调。Argon 要根据性能分析结果找到瓶颈,修改实现,再用下一轮实验判断修改有没有用。最后的 2.7 倍,来自这样一轮轮具体工作。
Google 还在让 Argon 参与把 C、C++ 代码迁移到 Rust,包括 re2、libgav1,以及超过 80 万行的 Fuchsia Zircon 内核。迁移过程中仍有自动化和人工审计,代码进入生产环境前还要经过仿真测试与审查。这项工作仍在推进。
另一组 Agent 则根据 Google 数据中心的性能分析与遥测数据,寻找可落地的内存优化。Google 称,已经部署的改动释放了超过 300 TiB 内存;把全部成果推开后,预计可以释放 500 TiB 到 1 PiB。前一个数字是已部署的结果,后一个是估计。
这些案例让 Argon 的定位具体了起来:它能够参与一个已有工程系统的改进,沿着测量、修改和验证继续往前走。
这也让 100 万 token 的输出空间有了更明确的用途。复杂任务可以容纳更长的推理和工作过程。Artificial Analysis 报道,Gemini API 为此增加了 Long Decode Continuation:较长的响应可以暂停,再通过后续调用接着生成,避免被单次请求的超时打断。因此,100 万 token 是可支持的输出上限,并不意味着每个任务都会用满,也不必全部塞进一次 HTTP 响应。
追平 Astra,强项也很鲜明
综合分数之外,Argon 在不同任务上的表现并不一样。
Google 公布的 DeepSWE v1.1 成绩是 77.9%,高于表中的 Astra 74.1% 和 Opus 5.5 的 74.2%。这项评测关注较长程的软件工程任务,与前面的内部工程案例方向一致。

DeepSWE v1.1 的软件工程评测
换到 FrontierSWE v2,Argon 的成绩是 55.0%,低于 Astra 的 65.5% 和 Opus 5.5 的 62.3%。它已经很有竞争力,但还没有在所有编程任务上领先。Google 的评测说明也写明,部分对照成绩来自其他厂商报告或公开榜单,并非把所有模型放进同一套环境重新测试。
专业知识工作是另一块突出的表现。Google 发布的结果中,Argon 在 Vals Index 上得到 68.9 分,高于表中的 Astra、Fable 5.1 和 Opus 5.5;金融 Agent 评测达到 65.4%,也领先这几款对照模型。面向企业工作流的 AutomationBench 则是 51.3%,使用的是 Zapier 的私有测试集。
编程之外,金融分析、专业资料处理和企业工作流也进入了这款旗舰的主要应用范围。
独立评测还观察到一个变化:Argon 更愿意承认自己不知道。在 Artificial Analysis 的 AA-Omniscience 测试中,它减少了编造答案的倾向。不过,该项测试的准确率为 50%,仍低于 Astra 的 63%。回答更克制,与掌握更多知识,是两件可以分别改善的事。
而在真实的多轮交互里,Arena 给出了另一种观察。基于约 3000 个真实 Agent 会话,Argon 高推理档暂列 Agent Arena 第 8;在 Steerability 指标上排第 1,也就是用户提出反对或纠正后,模型调整方向的表现。
Arena 明确把这批结果称为初步结果。这项观察贴近日常使用:任务进行到一半,用户发现方向不对,Argon 能比较好地接住纠正,继续往下做。
首发价便宜,任务账单另算
Argon 的首发定价很有吸引力,但这是一段优惠期的价格。优惠结束后,输入和输出单价都会翻倍。
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
缓存输入有 95% 的折扣。对于不断把长上下文带回模型的任务,这项价格也会明显影响账单。
Artificial Analysis 按智能指数测试中的实际用量计算,Argon 每项任务的加权平均成本是 1.99 美元,约为 Astra 3.26 美元的六成。不过,这个成本仍是 GPT-6.1 Sol 的约 2.7 倍。
有趣的是,Argon 并没有少用 token。这组测试中,它每项任务平均输出约 6.2 万 token,Astra 约为 2.7 万。当前的成本优势主要来自价格、缓存折扣和首发优惠。
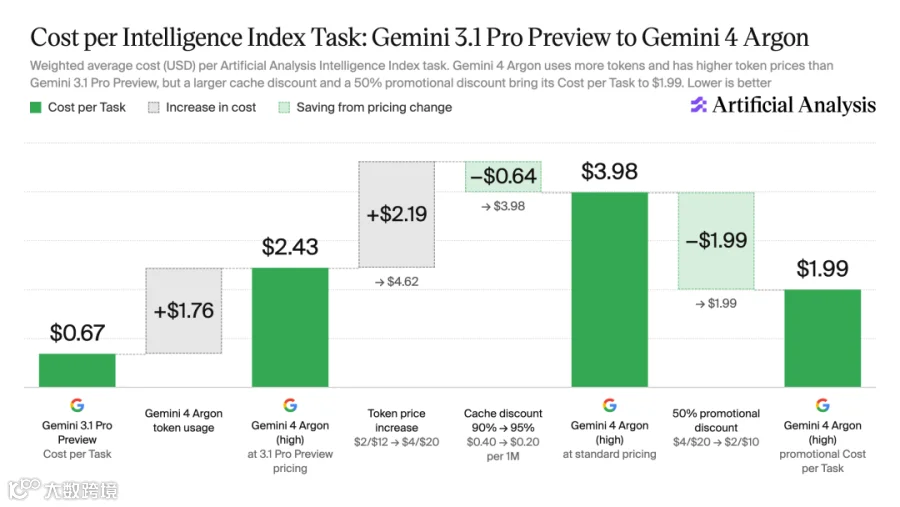
任务成本随 token 用量、缓存和首发折扣变化
第一批先给网络防御团队
Argon 的开放次序,与它的网络安全能力有关。
Google 首先通过 Fairwind Program 向受信任的网络防御者开放,同时在内部使用。为了让这些团队充分开展防御工作,首批版本不设置网络安全领域的防护限制。这是针对受信任防御者的开放安排,并非一个面向公众、取消所有安全限制的通用版本。
更广泛的开放还在分阶段推进。Google 正在评估潜在滥用风险,并加强对间接提示注入的防御、监控 Agent 的行动,以及隔离运行环境。
后续开放会优先考虑付费 API 客户和 Google AI Ultra 订阅者,再逐步覆盖开发者、企业和消费者。具体公开开放日期尚未公布。
参考链接
-
Google 官方发布:https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon/ -
Gemini 4 Argon 评测方法与完整结果:https://storage.googleapis.com/deepmind-media/gemini/gemini_4_argon_model_evaluation.pdf -
Artificial Analysis 独立评测:https://artificialanalysis.ai/articles/gemini-4-argon-google-top-three-labs -
Arena 的初步使用结果:https://x.com/arena/status/2105411271525052418