


本书核心观点:企业正在从单纯管理数据,转向管理知识,大模型加速了这场变革。AI 不只是需要干净的数据,更需要上下文、统一术语、可信的信息关联,还要能处理企业里大量文档、纪要这类非结构化隐性知识。只有建好知识底座,才能大规模落地靠谱可信的企业 AI。
过去搭建本体(企业概念语义模型),靠专家手工梳理,周期长、成本高,很难持续更新。本体流水线就是一套工程化流程,把本体建模变成可循环的标准化工作:先明确 AI 需要回答哪些业务问题,再定义概念、术语与业务关系,接着从各类文档抽取知识,搭建知识图谱,然后检验模型能不能回答预设业务问题,持续迭代优化。
它不是一次性项目,而是长期运营的知识资产。大模型可以辅助建模,但无法替代人做业务共识。企业建设这套体系,本质不只是技术改造,更是统一内部语言,打通各部门认知,让 AI 真正读懂企业业务。
从 "数据管理" 到 "知识管理":本体流水线如何成为可信 AI 的地基
——《Ontology Pipeline》读书笔记
一、为什么现在要读这篇文章
这本书出现的时间点很微妙。过去二十年,企业的信息化重心始终是 "数据管理":把数据采进来、存起来、洗干净、打通,然后通过报表和 BI 让业务 "看见" 发生了什么。这个阶段的假设是 —— 只要数据准确、及时、可查,决策就有了依据。
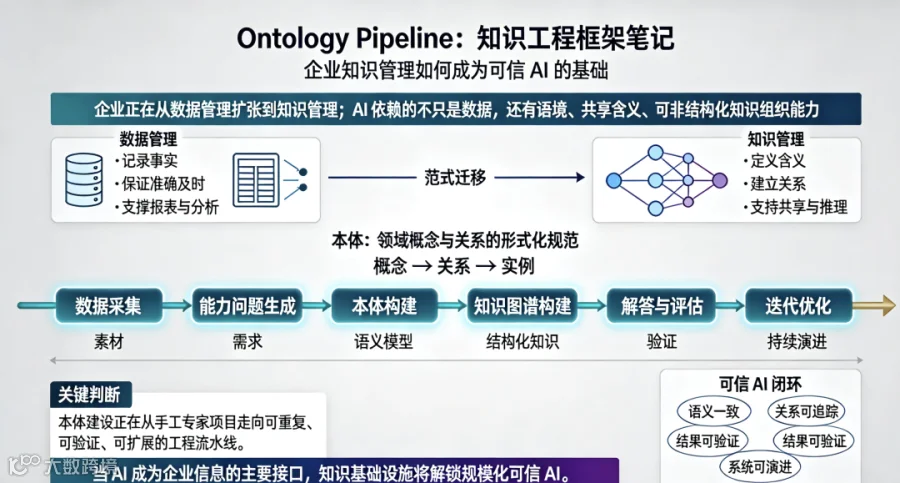
但这本书提出的判断是:数据管理正在扩张为知识管理,而这恰恰是 AI 加速推动的。当 AI 从工具变成企业信息的主要入口时,企业要喂给它的,不再是一张张表,而是一种能够被理解、被信任、被推理的 "知识"。这个转变,正是整篇本书的立论基础,也是所有后续技术讨论的前提。
二、论点的拆解:AI 为什么 "不够" 了
本书简介用一句话点破了要害:AI 依赖的不只是 "管理良好的数据",还有四样更软、更难的东西 ——
语境(context)、共享含义(shared meaning)、可信关系(trusted relationships)、组织非结构化知识的能力。
这四点值得逐一咀嚼。
语境。同一句话,在不同部门、不同时点、不同业务场景下含义完全不同。"这个月业绩不错" 在销售眼里和财务眼里是两回事。如果 AI 只拿到孤立的数字,它根本不知道这句话站在哪个坐标系里,就谈不上给出靠谱的判断。数据管理管的是 "值",知识管理管的是 "值在什么情境下成立"。
共享含义。数据可以规范(例如统一字段),但 "含义" 却天然是分裂的。销售说的 "客户" 和法务说的 "客户",是不是一回事?财务的 "成本" 和生产的 "成本" 口径是否一致?企业越大,这种 "一词多义" 就越严重。AI 如果不能理解这些词背后的统一语义,它给出的回答就只是 "形似",而不是 "意合"。
可信关系。AI 的可信度不在于它能检索到多少信息,而在于它能否正确理解信息之间的关系 —— 因果、从属、上下游、约束。一个能回答 "供应商 A 涨价会影响哪些产品线" 的 AI,和一个只会报出 A 价格的 AI,价值天差地别。关系,才是知识的骨架。
组织非结构化知识。这是最难啃的一块。每个大型企业都散落着海量的非结构化知识 —— 文档、邮件、包括电话视频会议记录及会议纪要、专家头脑里的经验。数据管理几乎不碰这些东西,而恰恰是这些,构成了企业真正的 "隐性智慧"。本书指出,AI 时代的挑战之一,就是把这片混沌整理成可检索、可推理、可传承的知识。
把这四点合在一起,本书的结论就呼之欲出:当 AI 成为企业信息的首要入口时,知识管理将成为解锁规模化可信 AI 的基础设施。
三、本体:让机器 "懂" 企业的语义
那么,怎么把 "含义" 和 "关系" 交给机器?本书给出的答案,是 "本体"(Ontology)。
本体是知识工程里一个古老的概念 —— 一种对领域内概念及其关系的显式、形式化规范。说人话就是:给企业的概念世界画一张权威地图。谁是主体、谁是谁的上位概念、谁和谁有什么样的关系、有什么约束 —— 全部用机器能解析的格式明确定义下来。
本体的价值在于 "消除歧义"。当 AI 去读一份文档时,有了本体,它就知道 "客户" 到底指什么、它跟 "合同" 是什么关系、它有哪些属性。本体相当于给 AI 装上了一个 "共享语义层",让它不再靠猜,而是靠规则去理解。这正是前面 "共享含义" 和 "可信关系" 的技术落点。
四、本体流水线:从 "手工画图" 到 "工程化生产"
本书的标题点出了方法论层面的核心创新 ——Pipeline(流水线)。
传统上,本体建设是专家手工劳动:领域专家和知识工程师开会、访谈、建模、评审,慢且贵,一个像样的企业本体动辄耗费数年。而 "本体流水线" 要做的,是把这件事变成一条可重复、可验证、可扩展的工程化流程:
- 数据采集
从企业内部各类数据源收集原始素材; - 能力问题生成(Competency Questions)
先问 "这个系统必须能回答哪些问题",用问题来反向约束本体的设计 —— 这是知识工程里非常实用的一套方法,问题即需求; - 本体构建
基于能力问题,定义类、属性、关系和约束; - 知识图谱构建
用本体作为模式(schema)去从非结构化数据里抽取三元组,把文档变成图; - 能力问题解答与评估
回到最初的问题,检验本体和知识图谱是否真的答得上、答得对; - 迭代优化
根据评估结果持续修正。
这条流水线最重要的意义,是它把 "建立企业知识基础设施" 从一次性的项目,变成了可持续运营的资产。知识不是建完就结束的静态产物,而是一个随业务演进不断生长的活系统。
五、AI 与知识管理的双向奔赴
文章最值得玩味的,是它揭示的一种双向关系 —— 不只是 AI 需要知识管理,知识管理也正在被 AI 重塑。
一方面,AI 的高效与规模化,让过去昂贵的手工本体建模变得可行:LLM 可以辅助生成能力问题、辅助抽取概念与关系、辅助验证本体的一致性。本体的建设门槛,正在被 AI 显著拉低。
另一方面,正因为有了本体和知识图谱这类 "结构化知识层",AI 的能力才被真正锚定在可靠的地基上。没有语义层的 AI,是华而不实的 "生成器";有了语义层的 AI,才是 "可被企业信任的推理引擎"。
这层双向关系,正是文章标题里 "知识基础设施" 一词的分量所在 —— 它不只是工具,而是企业进入 AI 时代必须提前铺设的底座。
六、批判性思考与启示
读完文章,我有三点延伸思考。
其一,这场转变的本质是 "范式迁移",不是 "技术升级"。数据管理追求的是 "正确",知识管理追求的是 "共识"。这要求企业不仅换工具,更要换组织方式 —— 谁来定义语义、如何跨部门对齐、知识资产归谁所有,都是治理问题而非技术问题。
其二,本体的 "共享" 是一个社会过程,不是建模过程。一个再漂亮的本体,如果各部门不认可、不采用,就是纸上的地图。所以知识基础设施的建设,很大程度上是一场关于 "让所有人用同一套语言说话" 的组织变革。
其三,警惕 "AI 替你做知识管理" 的幻觉。文章肯定了 AI 的辅助作用,但也隐含一个警告:LLM 可以加速抽取和建模,却无法替代人对 "什么是有意义的" 的判断。本体的质量最终取决于人类的洞察、取舍和共识,AI 只是把这条流水线跑得更快而已。
结语
这本书让我强烈感受到,企业智能化的下一站,比拼的不再是谁的数据多、谁的算力强,而是谁先把散落的知识凝练成可共享、可推理、可传承的语义资产。当 AI 成为企业信息的入口,知识管理就不再是数据部门的附属职能,而是整个组织可信智能的基石。这既是一次技术升级,更是一场关于 "企业如何认识自己" 的深刻变革。