


10 个关键问题Q&A
发布时间:2026 年 9 月 10 日 作者:周忠义(研究科学家)、杜若飞(谷歌 XR 交互感知与图形学负责人)
ToolGrad 是一套数据集生成框架,颠覆了传统范式:先产出工具调用的答案,再生成用户提问。研究表明,该设计能够让大语言模型获得更强的工具调用能力。
AI 智能体在现实任务自动化方面展现出巨大潜力,例如执行谷歌搜索、读取本地电脑文件、运行编写的 Python 脚本。想要实现这类智能体工作流,大语言模型必须学会正确、高效地调用工具。要训练大模型掌握工具使用能力,就需要工具调用链路数据集以及对应的用户查询。在我们之前的研究(InstructPipe:基于人工指令与大模型生成可视化流水线模块)中,评估数据依靠人工标注,但如果要支撑大模型微调工作,人工标注很难规模化落地。
为简化数据生产流程,已有研究(arXiv:2307.16789、arXiv:2409.00920)尝试用智能体反复试错,自动寻找工具调用路径。这类主流标注方法分为两步:(1)从 API 池中采样,生成假设性用户指令;(2)使用深度优先搜索(DFS)智能体寻找对应的工具调用解法。该方法本质上效率低下:它的核心思路是从智能体复杂探索轨迹里提炼有效样本,用于训练大模型。
在论文《ToolGrad》(发表于 ACL 2026 Findings,论文链接:https://aclanthology.org/2026.findings-acl.950/,开源代码:https://github.com/zhongyi-zhou/toolgrad)中,我们提出了一套全新方案:先构建真实可信的工具调用链路,再标注对应的用户提示词。直观来看,明确的工具调用解法比用户提问包含更清晰无歧义的信息,因此从工具使用链路反向生成用户查询,只需要单次大模型推理,标注难度大幅降低。
实验结果证明:这种先答案、后提问的方案,能够以更低成本生成更复杂的长时序工具调用数据。使用该数据集训练后的大模型,性能优于基线方法训练的模型;在分布外(OOD)测试集(包含模型从未见过的工具)上,性能甚至可以比肩顶尖闭源大模型。
传统方法是先写用户查询,再搜索对应的解决方案,数据生成通过率很低;而 ToolGrad 先产出可行的工具调用链路,再生成提示词,因此拥有很高的样本通过率。
基于文本 “梯度” 迭代生成工具调用链路
标准机器学习系统会计算小批量训练样本上的数值损失梯度,再通过优化算法更新模型权重。近期一项研究(arXiv:2406.07496)把这套思路迁移到提示工程:使用大模型评审器给出自然语言形式的详细反馈,这类反馈被称为文本梯度(textual gradients)。文本梯度会指导原始提示词迭代优化,生成新版本,更好完成目标任务。
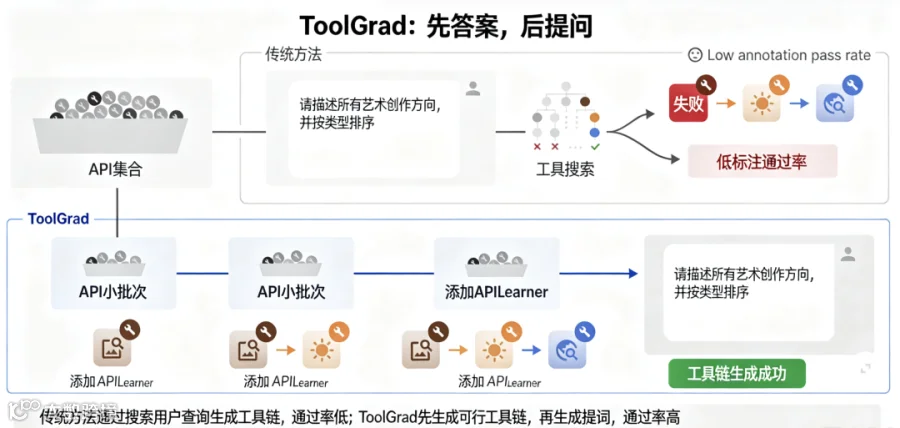
ToolGrad 将文本梯度的概念,从提示词优化拓展到合成数据集生成。它不再优化静态文本提示词,而是借助文本梯度,从庞大工具库中迭代构建复杂且合法的 API 工作流。
ToolGrad 的优化组件对比传统机器学习、TextGrad
ToolGrad 框架

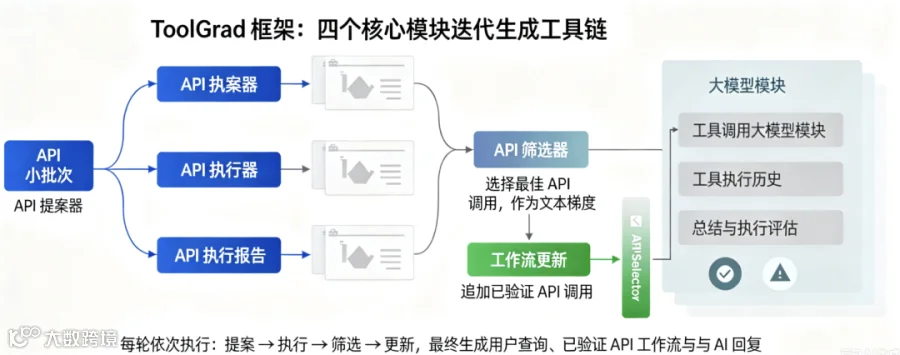
ToolGrad 包含四个核心模块,按顺序完成提案、执行、筛选、更新:
- API 提案器(API Proposer)
每一轮迭代中,从采样得到的 API 集合筛选少量有潜力的候选接口,用来扩展当前工作流。 - API 执行器(API Executors)
并行测试选中的 API,生成详细执行报告。 - API 筛选器(API Selector)
审阅执行报告,挑选效果最优的一次 API 调用;这一步相当于文本梯度,提供改进方向,将选中调用追加到工作流中。 - 大模型更新器(LLM Updater)
修改合成用户提问与 AI 回复,使之匹配新增的 API 调用。
重复上述迭代流程,最终得到一条完整样本:用户查询、经过验证的 API 调用工作流、AI 最终回复。
ToolGrad 先产出可行的工具调用链路,再生成提示词,样本通过率很高。
实验
数据生成效率评估
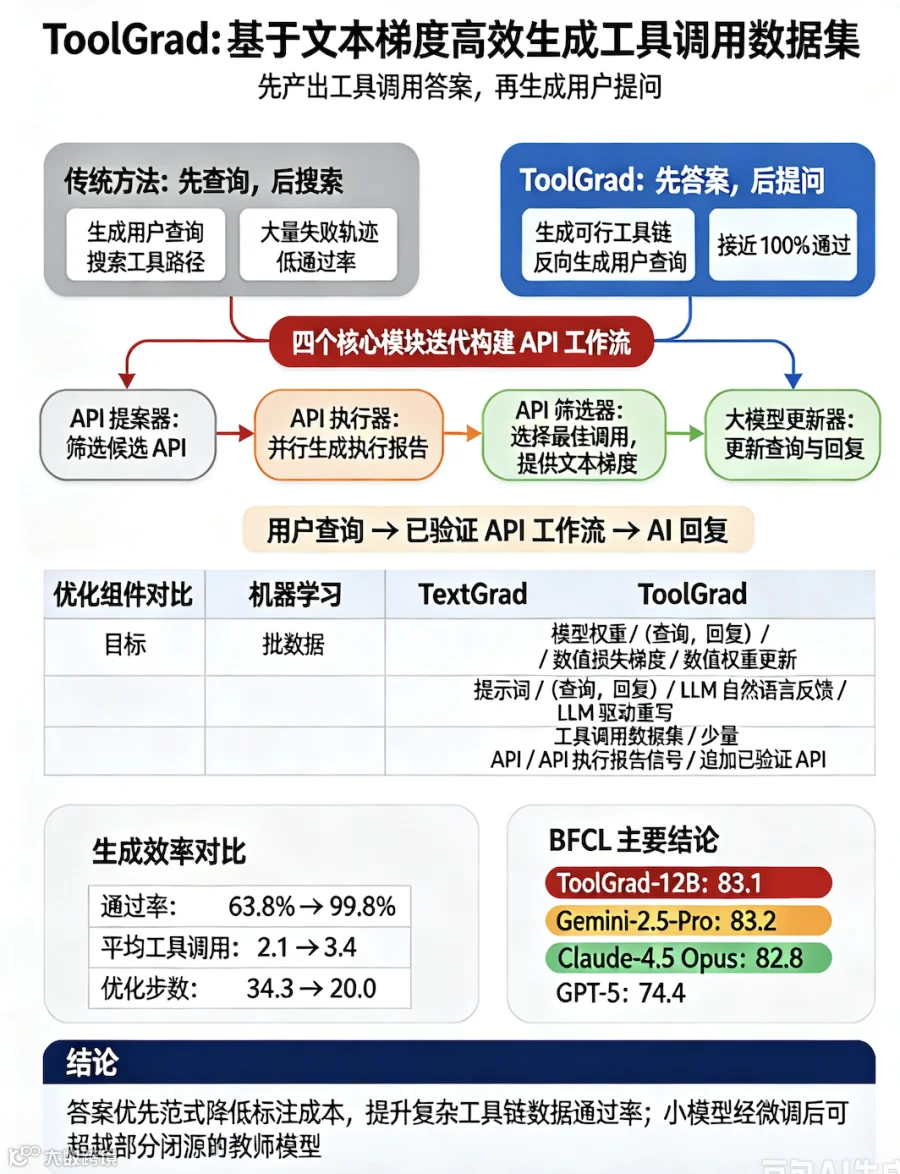
我们首先评估数据生成的成本与质量。实验采用 arXiv:2307.16789 中的 API 库,包含 16000 + 真实世界 API,用来构建工具调用数据集。我们对比 ToolBench 上传统先查询方案(深度优先搜索 DFS)与本文先答案方案 ToolGrad。实验结果表明:ToolGrad 可以用更低生成成本,产出更复杂的工具调用数据,并且样本通过率更高。
基线(先查询)方案与本文(先答案)方案的数据生成效率对比
伯克利函数调用排行榜
我们基于 ToolBench API 库,构建小规模数据集 ToolGrad-500。使用该数据集对 Gemma-3 系列模型(1B、4B、12B)做微调,得到 ToolGrad-1B、ToolGrad-4B、ToolGrad-12B。我们在伯克利函数调用排行榜(gorilla.cs.berkeley.edu)上评估模型工具调用能力,该评测集所用工具集与 ToolBench 完全不同。

对比对象包含:
-
未微调的原始基座模型; -
顶尖闭源大模型(Gemini、GPT、Claude); -
前沿工具调用专用开源模型(arXiv:2409.00920、arXiv:2410.04587v2)。
核心结论:
- 相比基线持续提升
在 ToolGrad-500 数据集上做后训练,Gemma-3 在全部参数量规格下,工具调用能力都获得显著提升。 - 性能超越部分闭源模型
ToolGrad-12B 取得 83.1 分,性能极具竞争力,接近同期业界顶尖闭源模型:Gemini-2.5-Pro(83.2)、Claude-4.5 Opus(82.8),并且优于 GPT-5(74.4)。 - 自进化特性
ToolGrad-500 数据集由 Gemini-2.5-Flash-Lite 生成。有意思的是,用该数据集微调后的 Gemma-3-12B,性能超过了生成数据集的 “教师模型”。 - 领先其他开源模型
ToolGrad-12B 显著优于其他开源工具调用专用模型,包括在更完善 API 库上微调的 ToolACE。 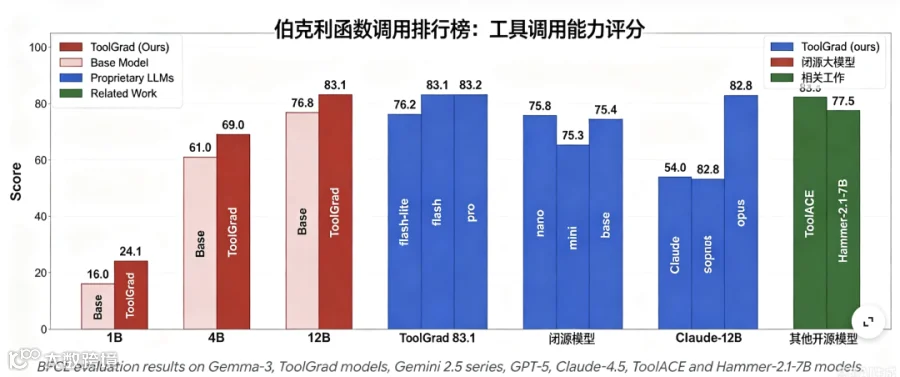
BFCL 评测结果:Gemma-3、ToolGrad 系列、Gemini 2.5、GPT-5、Claude-4.5、ToolACE、Hammer-2.1-7B
结论与未来方向
ToolGrad 证明:借助先答案范式,可以更高效、可靠地构建高质量工具调用数据集。这套智能体框架利用文本梯度迭代串联 API 调用,解决了真实标注数据生产中长期存在的成本与规模化瓶颈。该方案实现接近 100% 的数据生成通过率;体量相对较小的模型也能取得出色效果;并且验证了学生大模型可以超越生成训练数据的教师模型。
未来研究方向:扩展框架,适配规模更大、动态变化更强的 API 生态,落地更多真实场景;进一步研究自进化能力,实现持续在线学习,逐步完成模型个性化。随着智能体工作流越来越多地嵌入企业与日常任务,ToolGrad 这类框架为训练高性能、可低成本规模化部署的数字智能体打下重要基础。
致谢
本研究主要由周忠义在谷歌担任访问研究员期间完成。感谢核心贡献者 Kohei Uehara、张浩宇、周静涛、顾琳、徐征、原田达也的支持;感谢 Adarsh Kowdle、Shahram Izadi 提供战略指导与宝贵评审意见。