

⭐ 设为星标 · 第一时间收到推送
一条客服消息,没必要全交给大模型
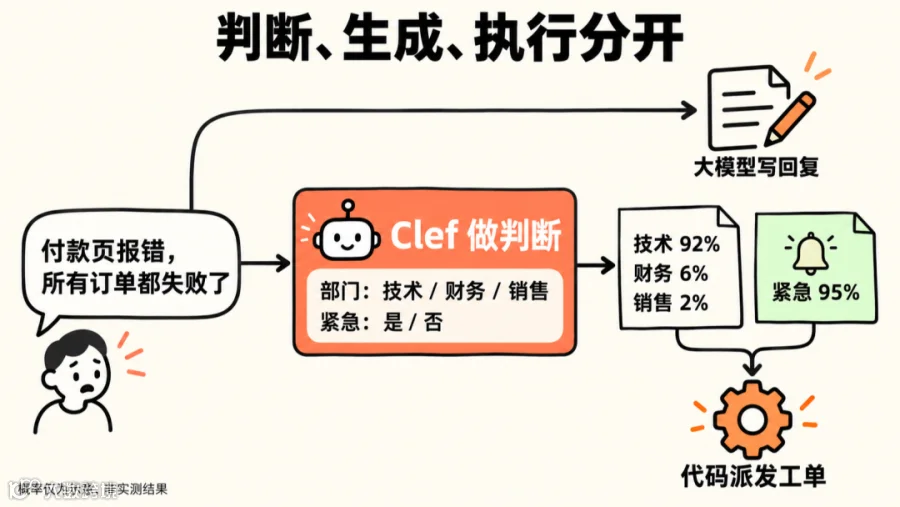
“付款页报错,所有订单都失败了。”
这条消息送进客服系统,至少有两件事要做:判断该找哪个部门、是否需要加急;再给客户写一段回复。
写回复需要组织语言。分派工单却只需要一个确定的结果:技术、财务、销售,选哪个?用通用大模型处理,它会生成文本或 JSON,再由代码读取结果。
Clef 接走的是其中的选择题。 你把消息、问题和候选答案一起给它,它返回每个选项的概率。代码可以据此派发工单,回复仍由大模型来写。
下面用同一条消息演示这个分工。概率数字是示意,不是 Clef 的实测结果。
10 月 1 日发布的 Clef 基于 Qwen3.8-27B,Clef-flash 基于 Qwen3.5-9B。两者都是从大模型改出来的决策模型,权重以 Apache 2.0 开放,也能通过 Cloudflare 的 Workers AI 调用。
它们仍要读懂语言、图片和上下文。问题与选项随请求提供,不必每多一个部门,就重训一个固定分类器。这张“答题纸”在接口里叫 schema,规定题目、类型和合法选项。
工单分流、内容分类、从候选工具里挑一个,都是可以先试的任务。选择用哪个模型、判断检索结果是否相关,也符合这个思路。共同点是答案范围清楚,而且每天反复问很多次。金额是否超过阈值这种明确规则,代码直接判断就好。
它快在哪里:读完输入,就给选项打分
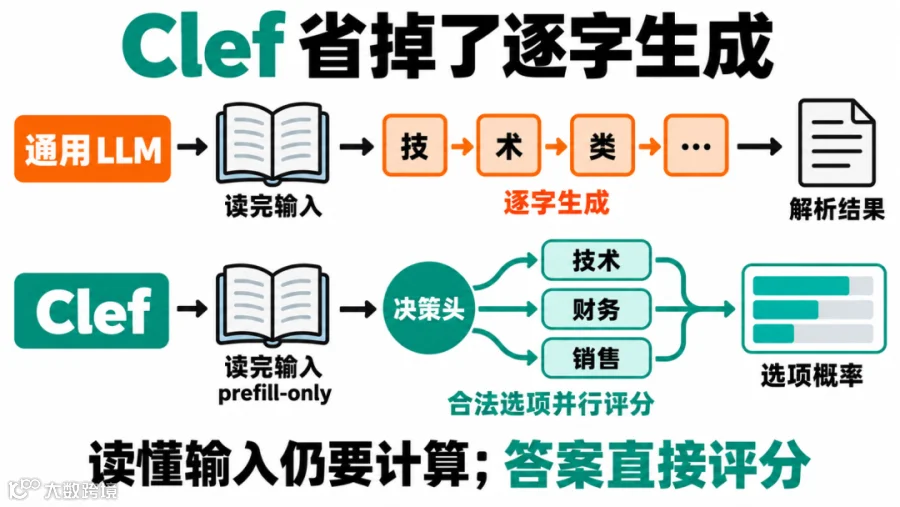
通用大模型通常有两个阶段:先读输入,再把答案一个 token 接一个 token 地生成出来。token 是模型处理文字的基本单位。哪怕最终只输出一个选项或一小段 JSON,也要走生成这一步。
Clef 的底座只完成读取输入的阶段,也就是 prefill-only。随后,专门的“决策头”从底座的内部表示里提取证据,给所有合法选项并行打分。
下图把两条路线拆开:Clef 仍然需要计算来理解输入,省下的是逐字输出的过程。
多道题可以共享证据。决策头先找出各选项需要的信息,让不同字段交换信息,再回看原始输入。比如“所有订单失败”这句话,同时影响部门归属和紧急程度。
程序拿到的是类型明确的答案与概率,不用从一段自由文本里提取结论。输出被限制在候选部门内。但答案格式可控,不等于答案一定正确:如果候选列表漏了真正该选的部门,模型没法替你修好业务设计。
概率还多了一道考验。模型说“90% 把握”,是否真的可信?要看大量相似判断中,它是否大约九成正确。若实际只对一半,就算格式再整齐,系统也不能照着这个数字自动放行。

Cloudflare 在训练里加入 Brier loss,惩罚预测概率与实际结果的偏差;还用 RLCD 优化整条记录的判断,并给接近正确答案的等级选项部分奖励。训练在尽量让模型少“自信地答错”,换到你的业务,概率还要重新检验。
工单系统因此可以设一条升级规则:经过验证、把握较高的自动分流,拿不准的交给更强模型或人工。阈值该设多少,取决于漏掉紧急工单的代价,不能从榜单里抄一个通用数字。
便宜和快,都要连着正确率看
截至 10 月 2 日,官方文档与模型卡给出的信息是:
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
按实际计费输入每轮 1000 token 推算,flash 调用十万轮,模型费用约 9 美元。这没包含抓网页、存储、训练等服务,问题和选项描述也会占输入。若经常判断错、重试或转交大模型,总账单还要往上加。
省掉逐字生成能缩短推理过程,网络距离和服务端配置也会影响实际延迟。38.8 毫秒是这次内部评测的请求中位数,不能当成所有地区、所有输入的速度承诺。
官方质量与延迟图把 Clef 数据标成了 self-reported,意思就是厂商自报。图中向上表示质量更高,向右表示更慢;它适合帮助选测试对象,还不能替你做业务验收。
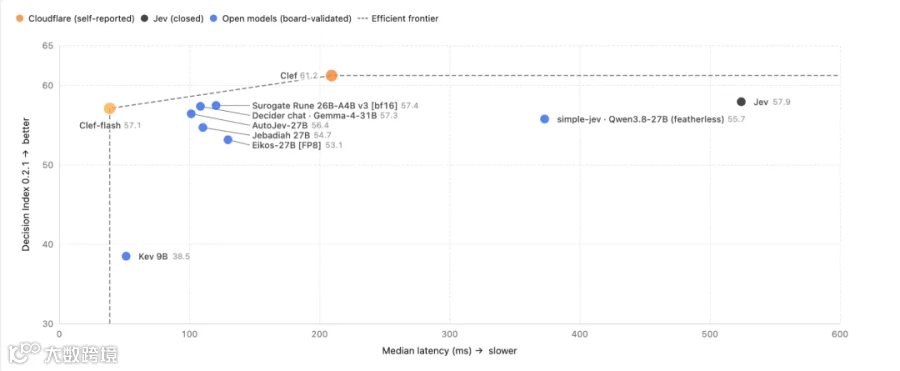
这轮成绩使用 Jev 相关的 Decision Index,以及 Typesafe 的业务工作流评测集,由 Cloudflare 跑出。使用另一家公司的题库,不等于另一家公司或独立机构认证了结果。
flash 也不是 Clef 的等价高速版。模型卡里,CLINC150+OOS 意图分类评分(macro-F1,越高越好),Clef 是 97.4%,flash 是 66.8%;Jev 在 When2Call 等任务上仍然领先。选择模型要看自己的任务,不能只比参数和速度。
安全分类同样如此。Cloudflare 的内部域名案例包含抓取、渲染与分类,Clef 走完整条流程花了 2.2 秒,gpt-oss-120b 花了 4.7 秒。它说明这个流程可能提速,没有证明识别恶意网站的能力翻倍。
HN 用户 agrippanux 则报告,聊天审核里 Clef 比 Jev 慢 2—3 倍,也漏掉了更多仇恨内容。他没有公布完整配置和数据,结果还不能复核。所以换模型前,我更关心它在自己那批工单上表现如何。
模型开源,生意在托管和训练
权重开放,用户可以自部署、修改模型;想省去维护推理服务的工作,也可以付费调用托管 API。这两件事并不冲突。
Cloudflare 又往后接了一步:让客户用自己的业务数据微调 Clef,再把模型放回线上。比如公司每天都在人工纠正工单去向,这些正确判断就可能成为训练材料。
它提出的流程是:AI Gateway 收集请求与响应,整理任务和奖励;Workers AI 让模型试做;Containers 的 RL sandbox 执行、回放并评分;Trainer 更新权重,再通过 Workers AI 与 BYO Model 重新部署。
这里的 sandbox 是隔离的试验环境。模型做对还是做错,需要你的评分规则来判断,不能只看它给自己多高的置信度。

日志不等于正确标签。 旧系统派错了一张工单,如果没有纠正就送去训练,新模型可能继续学这个错误。数据整理和奖励设计,是闭环里最不能省的部分。
目前 Cloudflare 先由工程师团队(FDE)协助客户微调,自助平台还在建设。这张流程图是它提出的方案,不代表现在已有一个按钮能把全部步骤跑完。
按这套产品布局,Cloudflare 可以通过托管推理、训练和部署赚钱。开发者仍能下载 Apache 2.0 权重自己跑。这是对它商业路径的推断,相关服务还没有列出完整价目表。
Cloudflare 承诺,托管 Clef 默认不读取、存储或用请求响应训练;微调和数据采集需要客户主动开启。输入范围也要区分:开源模型支持图片和视频,当前托管 API 文档列出的是图片。
想试用,两个托管模型 ID 是 @cf/cloudflare/clef 和 @cf/cloudflare/clef-flash,兼容 Jev / System One API。
我会先挑一个高频分流点,用历史工单与原流程对照。既看正确率和漏判率,也看 p95 延迟(95% 请求能在多久内完成)与总费用。选择题做得足够稳,再让代码自动执行;写回复、规划任务、处理例外,继续留给通用大模型。