


作者 |Tofu
来源 | 至顶AI实验室
M5 Ultra是苹果不久前推出的芯片,对于这款芯片,苹果的官网给出一个相当醒目的数字:本地AI性能最高提升4.3倍。
这个数字到底能在真实使用里兑现多少?最近,Alex Ziskind把M5 Ultra和M3 Ultra两台Mac Studio直接摆到了一张桌子上。
同样版本的llama.cpp,同样的MLX,同样的模型文件。从编译代码、SSD读写,到DeepSeek V4 Flash、GPT-OSS 120B、Qwen 3.8 27B,他把两代Ultra芯片从常规开发一路测到了本地大模型。尤其是在长上下文测试里,两台机器逐渐拉开了一个相当夸张的差距。
先别急着跑大模型,硬盘已经快得有点离谱
测试先从开发场景开始。M5 Ultra拥有36核CPU,其中包括24个性能核心和12个Super Core。为了把这些核心全部压起来,他跑了一次包含10万个命名空间和类的大型.NET编译。
M3 Ultra需要71.7秒,M5 Ultra缩短到52.4秒。接着换成Python执行Mandelbrot算法。M3 Ultra跑了10.25秒,M5 Ultra只用了5.8秒,接近两倍的差距。更夸张的是SSD。M3 Ultra顺序读取大约6.5GB/s,写入约2.7GB/s;M5 Ultra读取直接跑到接近14.9GB/s,写入接近20GB/s。
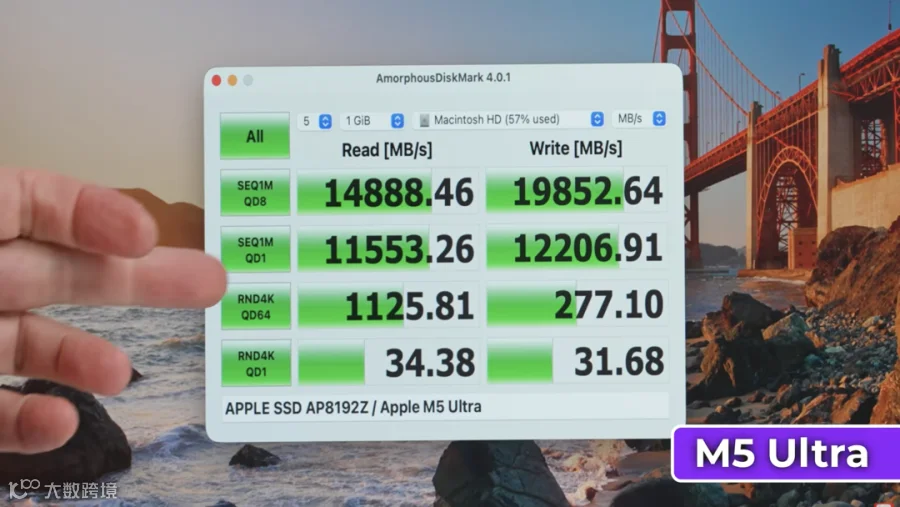
这个数字对于日常办公可能有些性能过剩,一旦进入本地AI场景,意义马上就不一样了。一个100GB甚至140GB的大模型启动时,需要先从SSD读取大量权重。硬盘越快,模型进入内存的等待时间越短。对于经常切换模型、同时运行多个Agent的用户,这部分时间会不断累积。真正的重头戏随后才开始。
1.2TB/s带宽,最终变成了多少Token?
测试本地大模型时,他重点盯住两个数字。一个是Prompt Processing,也就是模型读取和处理输入内容的速度;另一个是Token Generation,也就是模型生成答案的速度。前者更依赖GPU计算能力,后者则高度依赖内存带宽。
M5 Ultra这一代的变化恰好同时落在这两处。它的GPU核心中加入了Neural Accelerator,专门承担矩阵计算。更关键的是,llama.cpp已经能够识别这些硬件。
同一版本的llama.cpp运行在M3 Ultra上时,显示has tensor = false;到了M5 Ultra上,则变成了has tensor = true。这意味着软件已经能够调用针对M5系列设计的AI计算路径。
然后他开始测苹果宣传得很猛的1.2TB/s内存带宽。CPU侧的STREAM测试参考意义有限,于是他又专门跑了GPU内存带宽测试。
结果,M3 Ultra测到724GB/s,M5 Ultra达到1039GB/s。也就是说,苹果标称1.2TB/s的M5 Ultra,实际GPU侧可以跑到1TB/s以上,相比M3 Ultra提升大约1.4倍。
接下来,大模型上场。284B参数的DeepSeek V4 Flash,在M3 Ultra上生成速度约37 token/s,到了M5 Ultra上升到53 token/s,基本正好对应1.4倍左右的内存带宽提升。
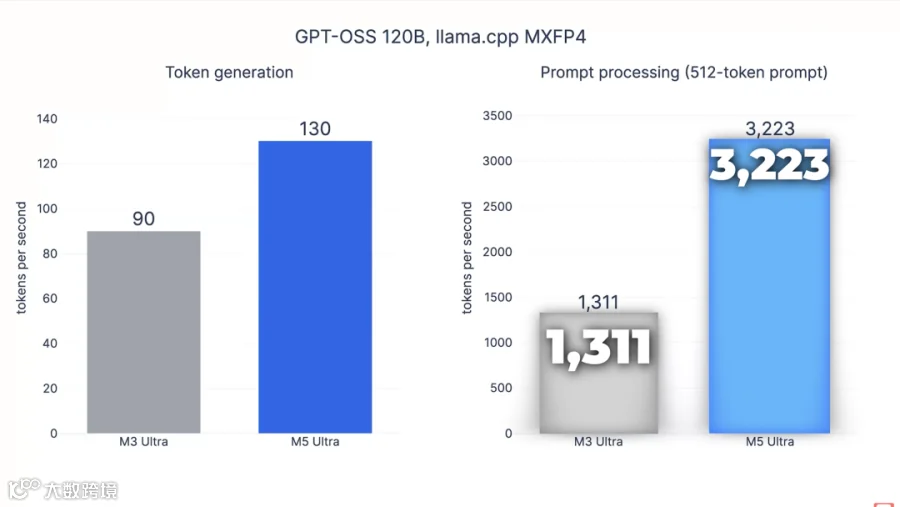
GPT-OSS 120B也呈现了类似趋势。M3 Ultra大约90 token/s,M5 Ultra达到130 token/s。换成Dense架构的Qwen 3.8 27B,结果仍然高度一致:37 token/s对54 token/s,提升约1.47倍。三种结构和规模不同的模型,最终都指向同一个数字:M5 Ultra在Token生成上的提升,大致就是1.5倍。
真正拉开差距的测试,还在后面。
14K代码塞进去,33秒变8秒
DeepSeek V4 Flash的Prompt Processing,在M3 Ultra上是483 token/s。到了M5 Ultra,直接冲到了1485 token/s。接近3倍。GPT-OSS 120B同样明显,从约1300 token/s提高到3200 token/s。
为了看看这种提升到底是不是跑分特例,他又换成了Dense模型Qwen 3.8 27B。
这一次差距更大。M3 Ultra大约430 token/s,M5 Ultra达到1800 token/s,超过4倍。随后他准备了一个大约14000 Token的Prompt,可以理解成一次性给AI塞进去数个源代码文件。M3 Ultra处理这些内容需要33秒。
M5 Ultra只用了8秒,实测提升4.2倍。不过,“4倍”这个数字也有明显的使用条件。Prompt越短,差距越小。大约350 Token的短Prompt,M5 Ultra只有约1.6倍提升;到了1700 Token左右,差距扩大到3.4倍;大约4500 Token以后,才逐渐进入4倍这个区间。
如果只是打开本地模型聊几句话,这台机器很难持续跑出宣传数字对应的体验。但如果使用Coding Agent,让AI一次读取几十个文件、几万Token代码,再持续调用工具、修改项目,Prompt Processing就会反复发生。8秒和33秒的差距,也会一次次被放大。而且并发还有进一步提升。视频最后,他简单预览了8路请求同时运行的表现:M3 Ultra总吞吐约75 token/s,M5 Ultra达到134 token/s。
至于代价,模型生成阶段,M5 Ultra芯片功耗约45W,M3 Ultra约36W,单位功耗下的Token提升只有约12%。到了GPU重载状态,M3 Ultra接近200W,M5 Ultra则超过400W,风扇开始明显加速,温度也明显更高。这轮测试最后留下了一个很有意思的变化。
过去Mac Studio跑本地大模型时,最显眼的优势一直是统一内存容量和超高内存带宽,它能把很多消费级显卡装不下的大模型直接塞进内存里。M5 Ultra继续把这部分能力往上推,又通过Neural Accelerator明显加快了长Prompt和代码上下文处理。
于是,一个新的使用场景开始变得更具体:256GB甚至未来512GB统一内存里,可以放下超大模型、代码、文档和长上下文,再让多个Agent一起工作。这时候,衡量一台本地AI机器的体验,一秒能吐出多少Token,已经只是其中一个数字。

