

https://xiaoyuzhoufm.com/podcast/689c6fb36f495c4caccf91d1
今年 7 月,一份 120 万行的数学证明同时通过了两个互相独立的验证程序——而它是假的。Lean 的创造者 Leonardo de Moura 说,这不是要停止用 AI,而是要重新想清楚:在一份没人读得完的证明面前,你到底在信任什么。
嘉宾是谁
Leonardo de Moura 是 Lean 的创造者、SMT 求解器 Z3 的共同创造者。Z3 是微软研究院 2006 年起开发的自动推理引擎,Dafny、F*、Verus 这些工业验证工具都跑在它上面,2015 年获 ACM SIGPLAN 编程语言软件奖,他本人因此拿到 2019 年 Herbrand 奖和 2021 年 CAV 奖。Lean 是他 2013 年在微软研究院推出的证明助手兼函数式编程语言,2025 年同样拿下 SIGPLAN 软件奖,获奖理由写明它对数学、硬件与软件验证以及 AI 的影响。
他在微软研究院 RiSE 组待了 17 年,2023 年加入 AWS 自动推理组任高级首席应用科学家,同时是非营利组织 Lean FRO 的首席架构师和联合创始人——Lean 目前由这个约 20 人的组织开发。他自述不是编程语言研究者,而是做自动推理与形式化验证的人,Lean 基本上是他实现的第一门编程语言。
本期对谈由 Machine Learning Street Talk 的主持人 Tim Scarfe 完成。他做过微软 Principal Engineer 和 bp 首席数据科学家,长期自己剪辑节目,习惯从软件工程实践者的角度追问。
一、一份假证明,同时骗过了两个独立的检查器
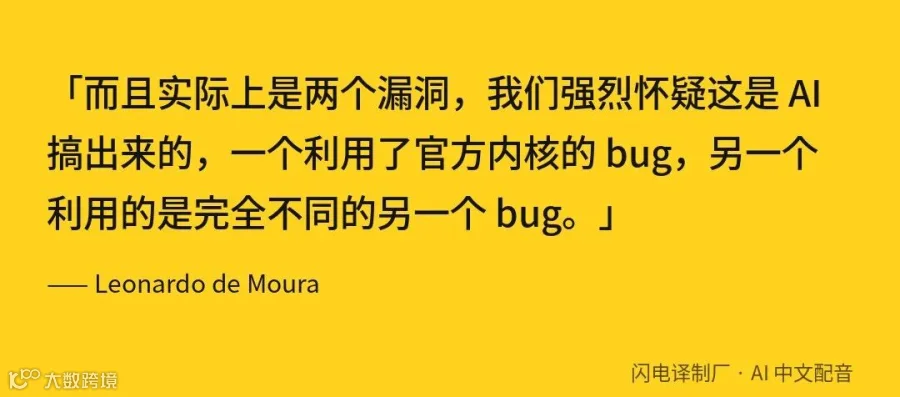
de Moura 在节目里复盘考拉兹假证明如何同时击中两个内核。
先讲清楚 Lean 是什么。它是一款「证明助手」:数学家把定理和证明写成机器能读的代码,Lean 逐行判卷。它也是一门编程语言,但主要用途是给数学和软件当裁判。
裁判的关键在于它有多小。Lean 的整个系统有几百万行代码,但真正需要信任的只有一个「内核」——一段只做类型检查的小程序。它不负责找证明,只负责判断一份证明合不合法。用 de Moura 的比喻,内核就像自动阅卷机:学生怎么解题都行,只看答案能不能通过检查。这条准则的意思是:只要证明工具最终产出的是一份小内核能读的证明项,那么搜索证明的过程里有多少 bug 都可以不管。
内核有多小?社区里另有人用 Rust 从零写了第三个检查器,叫 Nanoda,全部验证逻辑不到 5000 行。作为对比,浏览器是几千万行。正因为这么小,它才可能被人真的读懂。
于是有了 Lean 的经典安全策略:不同的人、用不同的语言,各自实现一个内核,互相交叉验证。2022 年官方内核出过一个算术 bug,就是被 Nanoda 抓到的——一个社区独立写的第三方检查器,替官方守住了防线。
这次出事的是考拉兹猜想。规则简单得能讲给小学生:任取一个正整数,偶数除以 2,奇数乘 3 加 1,反复做下去,是不是最后都会落到 1?1937 年提出,至今没人能证明。它已经被逐一验算到大约 2.36×10²¹ 仍然成立,但逐一验算不是证明。二十世纪最著名的数学家之一 Paul Erdős 说过「数学还没准备好应对这样的问题」,写过考拉兹问题权威综述的数学家 Jeffrey Lagarias 说它「完全超出当今数学的范围」。2019 年,菲尔兹奖得主陶哲轩证明了「几乎所有」初值都会降到接近 1,这已是几十年里最大的进展。2021 年还有机构为它悬赏 1.2 亿日元。题面简单到能讲给小学生,却难倒了近九十年,数学家甚至会互相告诫新人别碰这个「危险问题」——正因如此,它成了检验自动推理能力的标志性靶子,证明它、或者假装证明它,收益都极大。
今年 7 月 25 日,Ramana Kumar 发布了一个仓库,声称在不留任何「待补证明」的前提下推翻了考拉兹猜想,并且同时被 Lean 官方内核和一个一周前版本的 Nanoda 接受。7 月 28 日,Kiran Gopinathan 把它化简成「False 的证明」并报了 issue,官方在一小时内提交了修复补丁。
de Moura 的说法是:「而且实际上是两个漏洞,我们强烈怀疑这是 AI 搞出来的,一个利用了官方内核的 bug,另一个利用的是完全不同的另一个 bug。」
两个 bug 互不相关。说白一点:内核在检查一类嵌套定义的类型时,漏看了一个本该被检查的参数,于是它把一个不合法的「定义」当成了合法的;另一个检查器补上了这一处,却在别的地方没核对一个类型名字。这只是程序写漏了一行检查,不是 Lean 那套数学规则本身错了——数学规则仍然成立,出问题的是实现规则的那段代码。
而且严格说,不是两个检查器同时失守。Nanoda 那个 bug 早在事发前一周就被报告并修好了,被击中的是一周前的旧版本。de Moura 因此在事后推动一件事:Comparator(用来把证明导出、放进沙箱里检查的工具)永远自动下载最新版的 Nanoda,不再靠人工升级。如果当时已经这么做,这份证明早就被拒了。
出路不是再加一个检查器,而是让检查器本身被证明是对的。Lean 社区里 Mario Carneiro 正在做一个叫 lean4lean 的项目(de Moura 在节目里称之为 Lean for Lean),用更基础的方式证明内核正确。de Moura 说:「它证明了很多部分,但恰恰没证明到会被利用的那部分,要是他证完了,这个 bug 在被利用之前就会被发现。」
再往上还有一层:内核是用编译器编出来的,编译器也可能有 bug,那就要证明编译器;硬件也可能有 bug,那就要 CPU 厂商给出形式化规格。「这个方向说到底,就是不断减少你不得不信任的东西。」
对读者意味着什么?「多个独立系统互相校验就安全了」是软件行业和普通人都会自然相信的直觉,这次这条直觉被击穿了:当攻击者有足够的耐心同时去找多个系统各自不同的缺口时,冗余本身不再是护城河。风险形态也变了——不是系统坏了,而是系统给你一个看起来完全正确的绿色对勾。但要划清边界,de Moura 强调的是内核本可以被证明正确,而不是说 Lean 不可信;问题恰恰是被这套「小内核+独立复检」的设计暴露出来的,而且从发布到有人把它化简成 False 只隔了三天。这不是信任崩塌,是信任链需要往前推一格。
二、藏一手更安全?他明确拒绝了这个提议
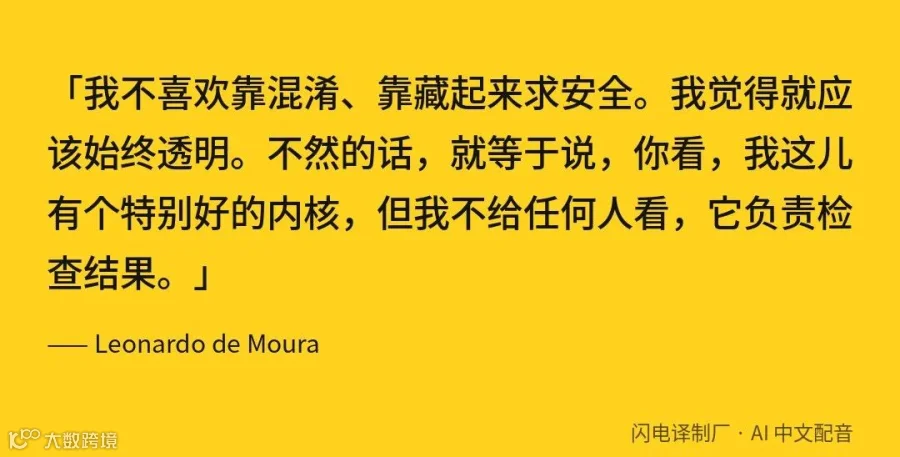
主持人提出留一个私有内核当底牌,de Moura 当场拒绝了。
主持人在节目里提了一个很自然的建议。他先举了个例子:他提到一个叫 ARC-AGI-3 的 AI 基准测试,把考题分成半公开和私有两份,只让模型在考试那一刻看到私有那份,这样就能确认模型不是背过答案。
(这里补一句背景:把题目分为公开集、半私有评估集和私有评估集这套防泄漏设计,源头是 François Chollet 在 2019 年提出的 ARC-AGI 基准——题目是给几组输入输出网格、让人猜出规则,用来测「流体智能」。ARC 的官方测试政策写明,要评估系统是不是真的在学习,评估数据集就必须保持私有。主持人提到的 ARC-AGI-3 是这条线上的最新一代。)
然后他问出真正的问题:那我们能不能也藏一个内核,不让任何人看到?模型没法提前找它的漏洞,手里就始终留着一张底牌。
de Moura 的回答没有任何犹豫:「我不喜欢靠混淆、靠藏起来求安全。我觉得就应该始终透明。不然的话,就等于说,你看,我这儿有个特别好的内核,但我不给任何人看,它负责检查结果。」
这是整期节目里两人明确分歧的地方,也是普通读者最容易站错队的地方——直觉上,藏一手显然更安全。
但安全工程领域有一条更老的原则,叫柯克霍夫原则(Kerckhoffs's principle),1883 年由荷兰密码学家 Auguste Kerckhoffs 提出:一个密码系统的安全不应该依赖于它本身保密,即使落入敌手也不应有害。1949 年 Claude Shannon 把它凝练成一句话——「敌人了解系统」。
道理不难理解:秘密一旦泄露就彻底失效,而且你换不掉它。相比之下,公开的算法被全世界反复攻击仍然没被攻破,那才是可信的。MITRE 把「依赖隐晦式安全」列为 CWE-656 号弱点,NIST 明确建议系统安全不应依赖于实现或其组件的保密。全球通用的 AES 加密标准就是正面例子:公开征集、公开分析、公开攻击了二十多年,至今没被攻破。
数学界在这件事上更早。证明被判定为正确,靠的从来不是作者的宣告,而是同行能独立重做检验。四色定理就是最好的例子:1976 年 Appel 和 Haken 用计算机检查上千种地图构形,可约性部分用不同程序独立复核;即便如此,1981 年还是有人在硕士论文核对中查出了一处实质性错误,直到 1989 年的专著才修正。2005 年,Gonthier 用 Coq 证明助手完整形式化了它——从此人们不再需要信任那几百个用来验算的程序,只需信任 Coq 的内核。费马大定理也一样:1993 年 Wiles 宣布证明后,审稿人的追问逼出了一个漏洞,他和学生又修补了近一年,1995 年才以两篇共 129 页的论文发表。
de Moura 的立场还有一层技术理由。他明确反对「删掉元编程来防攻击」这类堵漏思路,因为攻击者可以直接改写编译产物文件或内存,内核必须在自己进程里独立拒绝非法声明。也就是说,堵住入口不等于安全,只有让检查器本身经得起公开检验才算。
这意味着什么?这个问题被从「怎么防住这一次」拉到了「凭什么让人相信你」。在一个所有人都在争论 AI 是否可信的年代,这条标准其实很有传导性:不透明的正确性无法被验证,也就等于不存在。你可以不同意这个结论的代价——公开内核确实给了攻击者一份地图——但你得承认它换来的东西:任何人都有资格自己检查一遍。
三、人类没耐心啃的底层苦工,AI 有耐心
de Moura 谈 AI 写汇编并同时给出性质证明的可能。
zlib 是 1995 年 5 月 1 日由 Jean-Loup Gailly 和 Mark Adler 首次发布的免费无损压缩库,最初为 PNG 图像库服务,实现的是 DEFLATE 算法。今天的 Linux 内核、Git、PostgreSQL、OpenSSH、HTTP 压缩都在用它,是事实标准级别的基础设施。
压缩库最基本的正确性契约叫「先压后解能还原」。听起来平淡,但它必须对所有数据都成立——测试只能覆盖有限样本,一旦不成立,存储和传输里的数据就会静默损坏。
Lean FRO 的 Kim Morrison 做了一个项目叫 lean-zip:让 Claude 把 zlib 的 C 实现翻译成 Lean。de Moura 起初的判断是「哇,这没戏,不可能」,他说那是今年年初的事。
结果这个 agent 把 C 代码译成 Lean,不停修实现,直到通过 C 版本自带的测试套件,然后证明了:对任意压缩级别、任意数据,压缩再解压都能拿回原始数据。不是抽样测试,是对所有输入成立的定理。
而且它没停在这儿。de Moura 说 Lean 一直是为操作树结构的程序优化的——因为内部处理的是项、是语法树——处理数组并不擅长,所以他心里认定这个库不可能有竞争力。Kim 让 AI 继续优化代码,条件是性质必须继续证明、不能破坏;最后性能做到足以和 Rust 这种擅长数组的语言竞争,之后还做了模糊测试。(原话在这一点上说得比较跳脱,大意是 AI 一遍遍改,改到既有竞争力、证明又没被破坏。)
de Moura 由此往下推了一步:「这种底层的实现,我们自己没那个耐心去做,但 AI 有耐心。」他预判很快就能让 AI 去写 x86 汇编,把各种防御指令全用上,同时给出性质证明。
为什么这件事分量重?看看以前这类工作贵到什么程度。一个约一万行的操作系统内核,要配上约二十万行机器可检查的证明,人力以十人年计;据业内常见口径,证明的工作量是代码的几十倍。所以形式化验证长期只在密码学、飞机航电这类规格极清楚的地方做——不是技术不行,是性价比不划算。
de Moura 说得很坦白:以前「大家会说,天哪,我花了这么长时间证明实现是对的,现在这帮人又要加这个花哨的优化,那我得把一大堆证明重做一遍」,而在 AI 之前「这真是件天大的事」。
他也提醒了一个附带效应:规约一改,之前生成的代码和证明全部作废。未来可能出现的情况是,大家会说「我这是在更新规约啊,结果要烧掉海量的 token 去更新所有东西」。
另一个必须说的边界。节目里提到,后来有人用 Claude 驱动模糊测试工具对 lean-zip 跑了约一亿次测试,发现被验证的应用代码里没有内存漏洞,却在 Lean 运行时里发现了一个堆缓冲区溢出,还发现未被验证的归档解析器存在拒绝服务问题。也就是说,证明只覆盖你写下规格的那部分,规格之外一片黑暗。
这跟「奖励黑客」是同一枚硬币的两面。奖励黑客指 AI 努力达成目标的字面写法、却没达成你真正想要的结果。也正因为如此,前沿实验室评估代码时不只看孤立的最终代码:通过测试的作弊解和真解在产物层面无法区分,得让另一个模型去读完整的推理过程,才能判断它是怎么来的。
反过来,这也是 de Moura 对 Lean 最有信心的原因:这类任务上有个很强的信号告诉 AI 你走对了——「你必须把定理证出来,你没法作弊」。
那人还剩什么?de Moura 的答案很具体:规约永远是人的责任。他还给了一个很好用的思路——用 Lean 这类高级语言写的最直白、毫无优化的版本,本身就是一份规约,「它做的正是我想要的,接下来的优化就是 AI 的事了」。至于恐惧,他说得很轻松:写软件这件事要是真不用自己动手了,「对我来说就是任务完成了」。他更在意的是,绝大多数开发者脑子里都有一堆想法,最后只做了其中一小部分,而有了 AI,能试的想法就多了。
写在最后
三件事其实是一件事。AI 有无限的耐心,可以去同时寻找多个系统各自不同的破绽;而人类没有耐心,既读不完 120 万行的证明,也啃不动几十人年的底层验证苦工。同一个特性,一边制造了新风险,一边打开了新局面。
de Moura 给出的应对方式,说到底是把信任收缩到尽可能小、并且尽可能公开的一块地方:内核要小到能读懂,要被不同的人用不同的语言重写,最终还要被证明正确;而内核之外的几百万行,无论多聪明,都不必被信任。这套思路来自数学几百年的老规矩——证明的价值不在于是谁说的,而在于别人能不能自己重做一遍。
留一个值得想的问题:如果将来那些最重要的数学定理和软件性质,都是由没人能通读的机器证明支撑的,你愿意把信任交给一个看得见的小程序,还是交给一个你只能相信它不出错的系统?
收听本期:小宇宙搜索「闪电译制厂」,收听《EP17|谁来检查一份没人读得完的证明?——对话 Lean 创造者 Leonardo de Moura》。 https://www.xiaoyuzhoufm.com/episode/6abde919e742e36efcbd6557
原节目:Machine Learning Street Talk (MLST)《》 https://podcasters.spotify.com/pod/show/machinelearningstreettalk/episodes/Who-Checks-a-Proof-No-Human-Can-Read---Leo-de-Moura-e3pjhg5