

https://xiaoyuzhoufm.com/podcast/689c6fb36f495c4caccf91d1
过去一年,OpenAI 和 Anthropic 先后公开内部数据,说 AI 正在加速 AI 研究本身,有的研究员每月花在 AI 编程工具上的钱翻着倍涨。听起来,那个「机器自己造机器」的临界点已经不远了。但 Epoch AI 的研究员 JS Denain 把公开材料逐条读完,结论是:被自动化的只是写代码和排障这类活儿,真正决定研究方向的那一层几乎没提速。
嘉宾是谁
JS Denain(Jean-Stanislas Denain)是 Epoch AI 的高级研究员,带一个叫 Insights 的团队,常驻加州。Epoch AI 是一家非营利的 AI 趋势研究机构,最出名的工作是把几十个 AI 测试成绩缝成一条「通用能力」曲线(叫 Epoch Capabilities Index,简称 ECI),让模型在单个测试考满分之后还能继续比较。他还参与维护数据中心、芯片持有量这些公开数据库。
他今年 6 月和同事 Joe Kwon、Anson Ho 一起写了《Toward an O*NET for AI R&D》:借美国劳工部那套职业任务数据库的思路,把前沿实验室的研发工作拆成六大类、六十多项任务,逐项打分,估计 AI 现在能替人做到什么程度。因为他常年跟数字打交道,他在节目里被问得最多的就是「给个具体数字」。
主持人 Nathan Lambert 是机器学习研究者、技术通讯 Interconnects 的主笔,曾在 Ai2(艾伦人工智能研究所)带开放模型 Olmo 的后训练工作,博士方向是机器人和机器学习的交叉。这是他判断机器人时间线时偏保守的原因,他自己也说得很直白:「机器人会更像自动驾驶,而不是大语言模型。」两人在这期节目里是来回辩论的关系,Nathan 负责扮演怀疑派。
一、那张「每月翻倍」的图,可能只是把用量换了个入口
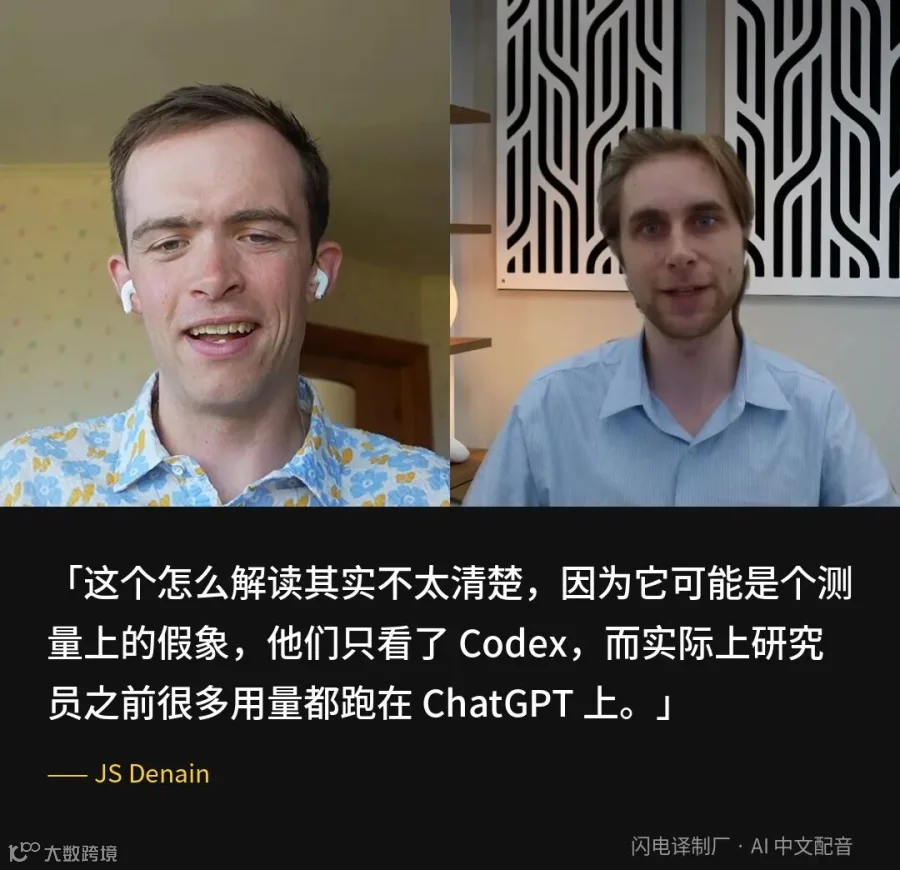
Denain 在节目开头拆解那张被广泛引用的 Codex 支出曲线
先说说这场争论到底在争什么。AI 圈里有个词叫 RSI,全称是「递归自我改进」(recursive self-improvement):想象一个 AI 能改写自己的代码、设计自己的下一个版本,而更强的版本又能设计出更强的版本,一圈套一圈。它被当成临界点,是因为一旦这个回路转起来,能力增长就不再由人类投多少钱、派多少人决定,而由 AI 自己决定,时间尺度可能从年压缩到月。所以真正要紧的问题不是「今天的模型多强」,而是「这个回路到底启动没有」。
在这个背景下,过去一年两家头部公司开始往外放内部数据。OpenAI 发了一篇讲「研究加速」的博客,说研究员在 AI 编程工具上的用量涨得很快,其中一张图被到处引用:研究员的 Codex 支出大概每个月翻一倍。Codex 是 OpenAI 的 AI 编程助手,和 ChatGPT 是同一个账号下的两个入口——它可以读代码仓库、改代码、跑测试、提合并请求,任务自己在云端沙箱里跑上一二十分钟。官方帮助中心写得很清楚:Codex 的额度和 ChatGPT 的聊天、图片、语音是分开计量的。
Anthropic 那边也放了两篇:一篇《When AI builds itself》,说到 2026 年 5 月,公司大于 80% 合入代码库的代码由 Claude 写;另一篇用 Epoch AI 那套任务分类做成「研发自动化指数」,这套量表把自动化程度从 0 分(AI 完全没用)到 5 分(完全自主)分档,26% 的研发工作落在第 4 档「AI 主导」,而截至 2026 年 8 月,没有任何一类工作达到第 5 档。这些材料里也引用了 Denain 自己的研究——所以这不是隔空喊话,是同一个圈子里的公开对话。
Denain 的读法是:这些数字确实说明研究者从工具里拿到了价值,但证明不了「半年内出现软件智能爆炸,或者 AI 研究员被完全自动化」。他特别指出那张最扎眼的图可能是测量假象:「它可能是个测量上的假象,他们只看了 Codex,而实际上研究员之前很多用量都跑在 ChatGPT 上。」换句话说,一个人原来在 ChatGPT 里写代码、查报错,现在换成在 Codex 里干同样的事,Codex 的曲线会陡涨,但 AI 帮他干的活总量不一定变多。这就是口径切换造成的增长假象。
那为什么大家还是觉得实验室内部看到了什么?有观众问,公司里的人是不是掌握了外界看不见的指标。Denain 举了个例子:能力外界看得见,但内部团队有自己的 KPI,比如预训练团队的「算力乘数」——大致是说,某项改进相当于额外多出几倍的算力。这类指标如果真在狂飙,会是回路启动的早期预警。但他也说得很清楚:他并不认为 OpenAI 或 Anthropic 的人此刻看到了什么让外界「该比现在恐慌得多」的东西。
这意味着什么?对普通读者来说,最实际的用处是学会区分两类新闻:一类说「工具被用得更狠了」,一类说「能力长出来了」,它们经常被混成同一句话。用量涨得快,可能只是大家把手上的活儿搬进了新工具;而能力有没有长出来,要看那些原本做不了的判断,现在能不能做。
二、快的是干活,慢的是决定干什么
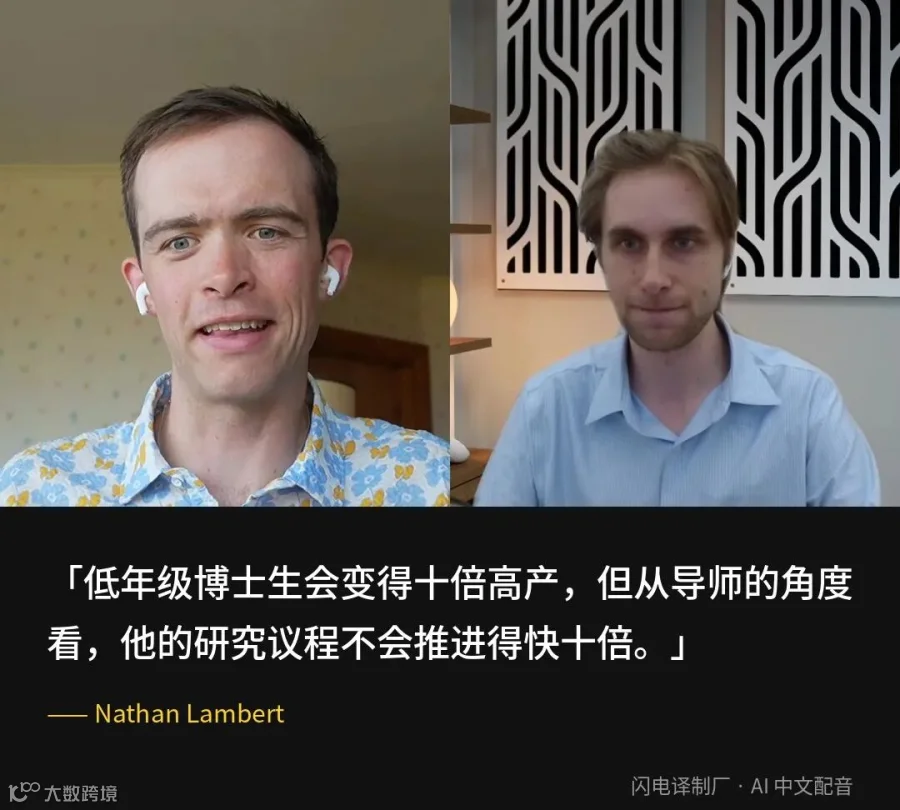
Nathan 在节目里用博士生和导师的类比说明个人提速与机构提速的差别
Denain 的核心论证可以压缩成一句话:AI 加速了下层的执行,没怎么加速上层的判断。往下拆,是两层意思。
第一层,被提速的是工程和排障。他翻 OpenAI 那篇博客时注意到一个细节:公司其他部门的 Codex 支出春天暴涨、夏天就基本走平了,只有研究员、数据团队和工程师这条线一直在涨。而按任务分类看,涨得最多的是写工程代码、排查故障这类活儿。原文自己也写了:高层规划(high-level planning)在 AI 输出的 token 里仍然只占极小比例,而且「整体研究进展未必跟得上这些具体指标」。Anthropic 那篇同样承认,在「选择目标、行使判断」上还有很大差距。
第二层,个人快不等于公司快,因为算力这类瓶颈会兜住上限。Denain 把问题拆得很干净:你最终在意的其实是「Anthropic 这家公司整体产出快了多少」,而不是「某个研究员快了多少」。他的原话是:「研究员全都快十倍,但因为算力或者别的东西,公司整体未必跑得更快。」Nathan 接着给了那个很好记的类比:低年级博士生会变得十倍高产,但从导师的角度看,他的研究议程不会推进得快十倍。
这个瓶颈最麻烦的地方在于,你根本分不清提速是 AI 变强带来的,还是算力变多带来的。Nathan 说他听完 Noam Brown 那期播客后一直在想这件事。Noam Brown 是 OpenAI 里做推理模型的骨干,他在节目里讲多智能体:用一万个智能体、1300 亿 token、跑了 88 小时,解出一道千禧年难题;但被问到这功劳怎么分时,他自己说连 10% 都不会归给多智能体,因为「核心原因是 OpenAI 训出了一个非常强的通用模型」。Nathan 的总结是:现在上线的推理算力太多了,他很难把「AI 研究提速」和「我们算力多了这么多、还能更有效地花在相关问题上」这两件事分开,而它们会同时到来。顺带说一句,Nathan 还把「强化学习环境」看成另一处上限——一个环境大致等于一道可执行的任务、一个自动打分器和一台跑它的沙箱,他怀疑业界没有好办法批量造出「难一个数量级」的环境;Denain 则补了一句乐观的:很多看起来无法验证的任务,其实只是一个更长的、本身可验证的任务的子集。
这里就牵出一个普通读者最该知道的背景:ECI 是什么,为什么连做它的人都担心它被玩坏。ECI 是 Epoch AI 做的能力指数,把 50 多个测试的成绩用教育测量学的方法缝成一条单一曲线,刻度是人为锚定的,绝对分数没有意义,只能横向比。它解决的是「单个测试几个月就被考满分、看不到长期趋势」的问题。但 Epoch 自己的常见问题页写得明明白白:厂商可以针对具体测试刷分,导致高估真实能力。Denain 在节目里甚至主动问 Nathan:如果未来一年 ECI 的斜率翻了五倍,你会觉得是真加速,还是因为这个指标被 Goodhart 化了(意思是:一个指标一旦变成目标,就不再是好指标)?
Nathan 的回答也很诚实:所有能被测量的东西,都会因为可测量而被很快拉起来,然后斜率又会掉下去。他说如果哪天实验室出来讲「用 Claude 我们的 AI 架构发生了非常大的变化」,那才会让他大幅改判——今天几乎所有大模型都建立在同一种叫 Transformer 的架构上,换架构相当于换掉整条技术路线,那属于「做不出来的判断」,而不是「做得更快的执行」。相比之下,数学上的进展他只意外、不震惊,因为数学题可证伪,恰恰是 AI 最擅长爬的那类坡。
这段对不在 AI 圈的人也有用。任何知识型工作都可以问同一个问题:被工具吃掉的是执行动作,还是决定做什么的判断?前者替换得快,后者替换得慢,而薪水通常付给后者。至于创业和投资,「AI 让公司快十倍」这种叙事在算力、代码审查、环境生产这些环节受限时,是跑不起来的——这些地方才是值得盯的瓶颈。
三、只差 6 个月,可算力差好几年,这笔账怎么算

Denain 在节目里给出蒸馏被阻断后中美差距的估计
第三个问题更容易引起争论:中国头部实验室到底落后多少?Denain 给出的数字是「大概六到八个月」,口径是发布日对发布日。如果按模型训练完成的时间算,差距还要大一点,因为他判断 OpenAI 和 Anthropic 从训完到发布拖得更久。作为对照,Epoch AI 今年 1 月的公开数据是:自 2023 年以来中国模型平均落后美国前沿 7 个月,最小 4 个月、最大 14 个月。
主持人当场提了反例:Kimi K3(月之暗面 2026 年 7 月发布)和 GLM 5.2(智谱 2026 年 6 月发布)按发布日算只落后两三个月,在 Artificial Analysis 这个第三方评测榜上,Kimi 当时甚至可能不到两个月。Denain 的回应是:ECI 里确实有大约 4 个月的案例,所以「4 到 8 个月」比较合理;但两个月「有点过拟合的味道」。他说 Epoch 内部专门检验过:如果用私有测试题、或者用模型发布之后才公开的测试题来重算滞后,污染和过拟合的效应基本不显著;可如果只看模型卡上厂商自报的分数,那就会有问题。
真正让他改变判断的是另一件事。Nathan 问:如果蒸馏被彻底卡死,六到十二个月后这个数字会是多少?蒸馏在这里指的是用更强模型的输出(包括推理过程)当训练数据——今天很多模型都这么训,只是拿别家 API 的产物去训竞品会违反服务条款。Denain 的答案是「八到九个月」。为什么上调?他说有两个原因:一是说蒸馏是主因的人变多了,二更关键——「我重新看了关于差距的其他解释,发现它们没有我最初想的那么有说服力」。他还提到「Claude routers」给了贴近真实使用场景的 prompt 分布,这个他一开始没想到;不过 Nathan 反问「你们本来就有基准分布,直接照着重造样本就行了」之后,Denain 也承认,如果只是解释 ECI 上的滞后,这个理由算不上多好的解释。
他也承认,这些替代解释加起来可能已经够用。所谓「其他解释」,是他在节目里列的一长串:中国实验室在算力和资本上落后得多,但在人力和数据上落后少得多,人多、数据近,这本身就是优势;他们的发布速度更快,中间版本放得更勤;他们更在意榜单成绩,其中有财务动机——智谱已经在港交所上市,分数贴近前沿对资本市场有用;还有「四分钟一英里效应」,有人先证明某条路能走通,后来者就不用浪费资源去试错一堆方向。还有一条 Nathan 说自己也从中国那边听说过的传闻:美国这边有数据供应商配合前沿实验室,花大量研发算力筛出哪些强化学习环境真正有效,经验学到手之后再照着做一批类似的环境转卖出去——Denain 把它叫「隐性研发算力被花掉、又被省下来」,但说影响多大不确定。
这段里还夹着两个技术背景,值得单独说清楚。第一个是训练流程:模型大致分三段——预训练(海量文本上学语言和常识)、mid-training(中期训练,用筛选过的高质量数据和合成推理数据继续训练,把数学、代码、工具使用这些能力塑形)、以及后训练(从 SFT 监督微调开始,再做强化学习)。Beren Millidge 在另一档播客里说,mid-training 常常把模型带到最终强化学习版本的「将近 80%」,Denain 拿这句话来论证:把强模型的输出当数据喂进中段训练,确实很有效。Nathan 则坚持强化学习才是能力来源,并指出在前沿实验室里,中段训练和 SFT 其实常被当成同一个阶段。
第二个是榜单为什么会失真。Artificial Analysis 和 ECI 一样是把多个测试合成一条曲线,区别是它由一家商业公司维护、更新更频繁,也是媒体引用最多的那个榜,做法是把大约 10 个测试按权重合成一个总分。但它同时带来三重问题:测试题或答案如果进了训练数据就是污染;榜单一旦被当成绩效指标就会被针对性地优化;而已经上市的中国实验室又天然有动力展示自己贴近前沿。所以分数差距只是一个可以被优化的代理变量,不等于能力差距。Denain 的保留也在这里:他反过来认为 ECI 这类指数可能低估差距,因为 OpenAI 和 Anthropic 有些能力根本不会体现在测试上。
对普通读者,这事的价值在于把一个情绪化的问题拆成了归因题。差距只有几个月,而算力差好几年,中间那段差额由什么填补——是蒸馏、是人力、是发布节奏,还是纯粹因为跟上别人比开创方向容易——直接决定了未来两三年该怎么看出口管制、开源生态和这些公司的估值。Denain 自己给出的答案里,没有一个因素是决定性的,这也提醒我们:把这段差距归给单一原因的人,多半比你更确定。
写在最后
把三段拼起来看,Denain 其实在做同一件事:把宏大叙事拆成可以逐个检查的部件。谈 RSI,他不看宣言,去看支出曲线有没有换过口径;谈生产力,他不看某个人的提速,去看公司的整体产出受什么限制;谈中美差距,他不接受「偷」或「追上了」这两种说法,而是把差额摊到算力、人力、数据、发布节奏上一项项算。
他也留了明确的自我怀疑。他自称世界观是「能力至上论的大统一」,认为人们最大的分歧在于能力会长到多大、多快;他接受「十年尺度上至少 10% 的存在风险」这个说法,说自己极其不确定、但确实非常担心。机器人不是他的专长,他直说「我们不声称自己有机器人方面的专业能力」。
所以真正值得盯的,可能不是某张励志的增长曲线,而是那个还没人知道答案的问题:如果 AI 真的开始加速 AI 研究,它应该先在哪儿露头?Denain 的答案很朴素——先出现在实验室内部那些没人发的效率指标上,而不是出现在一条被广泛转发的推文里。
收听本期:小宇宙搜索「闪电译制厂」,收听《EP10|与 Epoch AI 的 JS Denain 辩论:递归自我改进、中美差距与锯齿式能力》。 https://www.xiaoyuzhoufm.com/episode/6abd9763195d838e2aec34a5
原节目:Interconnects《Debating RSI, the US-China Gap, and Jaggedness with JS Denain of Epoch AI》 https://www.interconnects.ai/p/debating-rsi-the-us-china-gap-and