

https://xiaoyuzhoufm.com/podcast/689c6fb36f495c4caccf91d1

Runway 是一家做 AI 视频的公司,最早出名是因为电影人拿它做特效。它的联合创始人 Anastasis Germanidis 在 Latent Space 播客里说了一句很大的话:把「预测下一帧画面」这件事做到极致,就等于造出了一个能模拟物理世界的模拟器——而这件事会同时改掉电影、手机界面和机器人。世界模型的意思是:模型对环境建立一个内部表示,然后预测它在你做出某个动作之后会变成什么样——给模型一段画面,让它接着往下画,还要画得能随你的操作而变。
嘉宾是谁
Anastasis Germanidis 是 Runway 的联合创始人。他个人官网自述的职位是 co-founder 兼联席 CEO,专注视频生成模型(Gen-1 到 Gen-4)以及通用世界模型方向的研究;维基百科等资料仍把他写成 CTO,那是没更新的旧头衔。他是希腊人,2018 年和 Cristóbal Valenzuela、Alejandro Matamala 在纽约大学 Tisch 艺术学院的 ITP(一个做交互艺术的跨学科项目)认识后,三人在纽约创办了 Runway,总部在曼哈顿。
Runway 2023 年 12 月那篇《Introducing General World Models》的署名作者就是他——「把视频预测做成世界模型」这条路线最早的公开宣言出自他手。此后他又写了《Towards Universal Simulation》(2024)和《Real-World Superintelligence》(2026)。报道称 Runway 在 2026 年 2 月融资 3.15 亿美元,估值约 53 亿美元。
这一期的主持人是 swyx(本名 Shawn Wang,Latent Space 播客与 Newsletter 的主理人,AI Engineer 大会的联合组织者)和 Vibhu Sapra(Latent Space 的联合主持人、Paper Club 的组织者之一,做过文本摘要产品 Byrd.ai)。两人负责追问技术细节,Germanidis 本期作为 Runway 联合创始人接受他们的访谈。
一、把视频预测做好,就等于理解了世界怎么运转
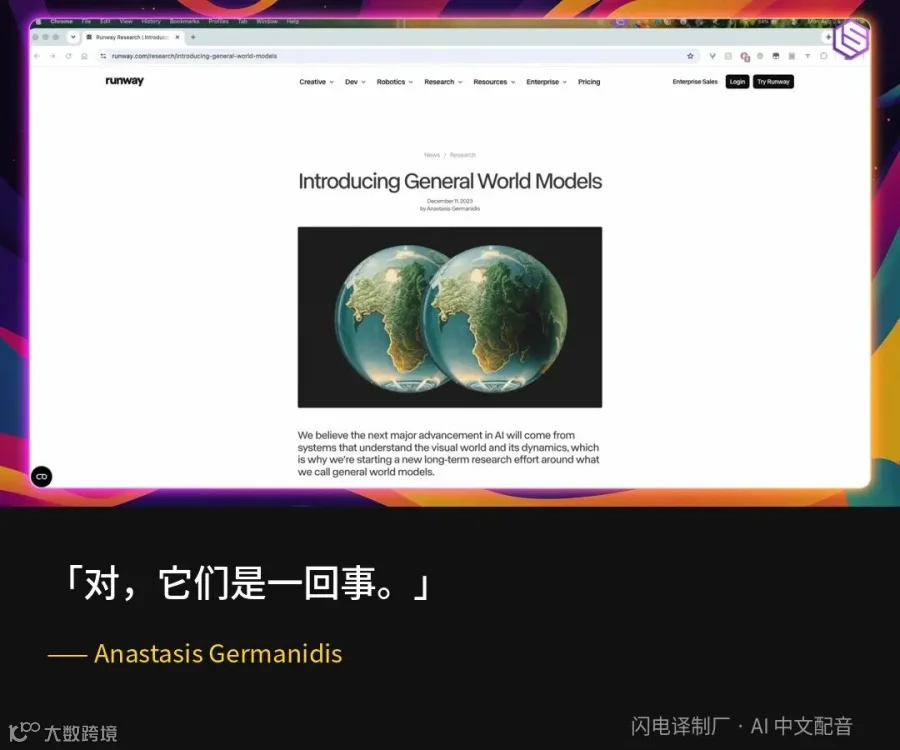
Germanidis 在节目里被主持人追问「所以你的回答是它们是一回事」,他答得没有半点犹豫。
先说结论:Germanidis 认为,你不需要为「理解世界」另换一套架构。把视频预测做下去、把模型和数据继续做大,模型对物理、对人和物体的运动的理解就会可预测地变好。
要理解这句话的分量,得先知道它在反驳谁。Yann LeCun(杨立昆)是卷积网络的奠基者之一,2018 年和 Hinton、Bengio 一起拿了图灵奖,2013 到 2025 年任 Meta 首席 AI 科学家。2022 年 6 月他发了一份立场论文《A Path Towards Autonomous Machine Intelligence》,提出 JEPA(联合嵌入预测架构):不要预测像素,而在抽象的表征空间里预测——好比你不必画出被遮住的那半张脸,只要知道那是张脸就够了。他的理由很直白:世界本身是不可预测的,逼模型逐像素还原,会把容量浪费在无关细节上,反而学不到高层语义。Meta 官方介绍 I-JEPA 时就是这么写的,还说生成式模型常在人手上出错。
这段话针对的正是视频生成。双方争的不是技术细节,是路线:一边说「先把画面画对,物理自然就懂了」,另一边说「画面对不等于懂物理」。
Germanidis 的论证有两块。一块是趋势外推:他把今天的视频模型比作 GPT-2 那个阶段——GPT-2 连连贯的句子都写得勉强,Gen-2 连连贯的视频都做得勉强,但「只要把规模做上去就行」。他还翻出更早的历史:2014、2015 年只能生成 32×32 的人脸,到 2018 年已经能生成 1K 分辨率的街景。顺带说清楚他反复提的莫拉维克悖论:人类觉得难的事(下棋、算数)机器容易学会,人类下意识就会的事反而极难,比如系鞋带——你让我用语言描述怎么系鞋带,很难;演示一下,一目了然。
另一块是基准分数。他点名了 Physics-IQ:研究人员先实拍一批能代表不同物理现象的视频,取第一帧喂给图生视频模型,让它生成后续,看接下来「应该」发生什么——天花板上吊着的球该怎样落到地上。他说,在不同的模型规模和算力规模上都测过,物理直觉的分数是可预测地提升的。
这里得补一句:Physics-IQ 是 Google DeepMind 和索菲亚大学团队在 2025 年 1 月发布的基准,用 396 段实拍 4K 视频、66 个物理场景,覆盖固体力学、流体、光学、热力学、磁学。它最初的结论其实对 Germanidis 不利:最好的模型(VideoPoet)只拿到 29.5%,Runway Gen 3 只有 22.8%,Sora 只有 10.0%,而且画面好不好看和物理分数不相关,论文标题就叫「视觉真实不等于物理理解」。榜单后来确实一路上升,2026 年最高到过 64.5%,但那是模型配上奖励模型做多次生成挑最好一条的结果,而且普遍用了定制提示词模板——单纯模型的成绩要低得多。2026 年 6 月的后续审计还发现原基准有大量样本和指标瑕疵,修了 57.6% 的样本后,排名明显变化。
但这也是 Germanidis 敢引用它的原因:分数低说明现在不够好,但只要它随规模往上走,就说明方向对——争议恰恰在于分数上涨有多少来自模型本身、有多少来自选样技巧。所以分数只能算物理理解的一个粗糙代理,不能直接划等号。Germanidis 也没有把话说满,他自己承认视频模型会作弊:「生成视频的时候模型是可以作弊的,比如它可以给你几个连续的、但完全不同的镜头,这样就绕开了模拟那些难的物理……千万别被现在这些视频模型的表现骗了。」
他打的底牌是另一条更老的方法论——「苦涩的教训」:这是强化学习先驱 Rich Sutton 在 2019 年一篇短文里的说法,70 年 AI 史最大的教训是,能利用算力的通用方法最终会大幅胜出;把人类领域知识写进系统短期有效、长期拖后腿。
这意味着什么?如果他对了,「生成好玩的小视频」和「造出能干活的机器人」是同一笔投资,视频公司会自然长成世界模型公司;如果他错了,砸在视频生成上的天量算力可能只是造了更贵的特效工具。对不在这个行业的人来说,这决定了未来几年新闻里「世界模型」四个字到底是真突破还是营销词。
二、下一个被 AI 重做的,是界面本身,不是写代码这件事

Germanidis 在节目里共享屏幕,演示那个「全是像素」的界面:按钮、拖拽、滚动都由视频模型实时生成。
第二个判断更贴近普通人的日常:不是用 AI 帮你写 HTML 和 CSS,而是让视频模型直接把界面画出来。「点击、拖拽、滚动」就是输入,按钮按下去会发生什么,用一句自然语言描述。
得先说清楚今天的界面是怎么来的。你手机或电脑上看到的画面,本质是一段代码被浏览器画出来的结果:HTML 声明页面上有哪些元素,CSS 决定颜色字号间距,React 这类库按数据状态生成和更新这些元素。浏览器把 HTML 解析成 DOM、把 CSS 解析成 CSSOM,再经过布局(算位置尺寸)、绘制、合成,最后才成为屏幕上的像素。交互——你点一下、拖一下——触发的是程序逻辑,不是模型推理。
Germanidis 展示的东西跳过了这一整层。他把这叫做「界面世界模型」:「它直接渲染出界面的像素,并且被训练去预测你点击或者做别的交互之后接下来会发生什么。所以这里面全是像素。没有任何 HTML、CSS、React 在支撑这个界面。」他还说,你可以直接在提示词里描述每个元素该长什么样、按下哪个按钮该发生什么,还能同时加音效。
他的理由是一个反问:「为什么要先生成代码、再让代码生成像素呢?直接把像素生成出来。」他给了个对照实验:让 Claude 照着 Figma 做的界面图去还原那个交互,结果不光是慢,「很多交互光靠大语言模型本身也很难还原」。
对他来说,终点是一整套纯神经网络的操作系统,这个说法 Andrej Karpathy 早就写过。Karpathy 是 OpenAI 创始成员、前特斯拉 AI 总监,以讲课出名,「vibe coding」这个词就是他造的,2026 年 5 月加入 Anthropic 做预训练。他 2026 年 4 月在一场活动里描述过「完全神经化的计算机」:原始视频音频直接进神经网络,用扩散现场渲染出只属于此刻的界面。Germanidis 顺着这个往下推:到那时候,「应用这个概念可能就不一定成立了」——因为「应用」这个想法本来就假设每个工具需要一套独立的代码库去驱动。
这事还连着另一个行业现象。computer-use agent(电脑操作智能体,指像人一样看屏幕截图、移光标点击、打字的 AI)现在做得最起劲的是 Anthropic 和 OpenAI。Anthropic 2024 年 10 月推出这个能力时,按它自己的说法,Claude 在 OSWorld 这个电脑操作基准上的截图模式只有 14.9%(同一基准上人类的完成率是 72%,不过那是另一份论文里的数字,不是同一时点的对比)。它们卡在同一个地方:没有足够多、可复现、能判分的真实软件环境来训练和测试。花大价钱搭真机环境是一回事,用世界模型当场「捏」出无穷多个界面又是另一回事。Germanidis 说得很直接:世界模型是「一个很强的合成数据生成器」,也可以「变成一个实时的强化学习环境」。
代价他也承认了。跑一个实时视频模型比渲染 HTML 贵得多,这是他的原话。主持人 swyx 补了一句成本有上限——界面停下来没人操作时,其实什么都不用生成;Germanidis 同意,但也说屏幕上一直有东西在动(比如你「去巴黎看看」而画面上有人在走),模型就得一直跑。
这里需要说清「实时」是怎么来的。扩散模型生成画面靠逐步去噪:从一团噪声出发反复调用同一个网络,每一步只做很小的修正,传统实现要跑几十到上千步,步子迈大就崩。步数蒸馏是后训练里的压缩术——让多步的老师跑出完整轨迹,再训练学生用更少的步数复现。奠基工作是 Tim Salimans 和 Jonathan Ho 2022 年的渐进蒸馏,把最多 8192 步压到 4 步而感知质量基本不掉。Germanidis 举的例子正是这个量级:原本五十步生成的模型,让它四步生成,「性能会掉一点,但很多时候输出质量是差不多的」。需要说明的是,五十步到四步是他在播客里的一般性举例,Runway 官方博客并没有公布具体步数。
对普通人来说,这个判断的现实含义是:软件可能不再是「一个装好的东西」,而是每次打开时为你现画一遍的东西——字体可以按你的需要放大,风格可以按你的喜好变。但它能不能便宜到可以日常使用,到现在还没有答案。
三、机器人不该靠人一遍遍教,该靠看别人怎么做
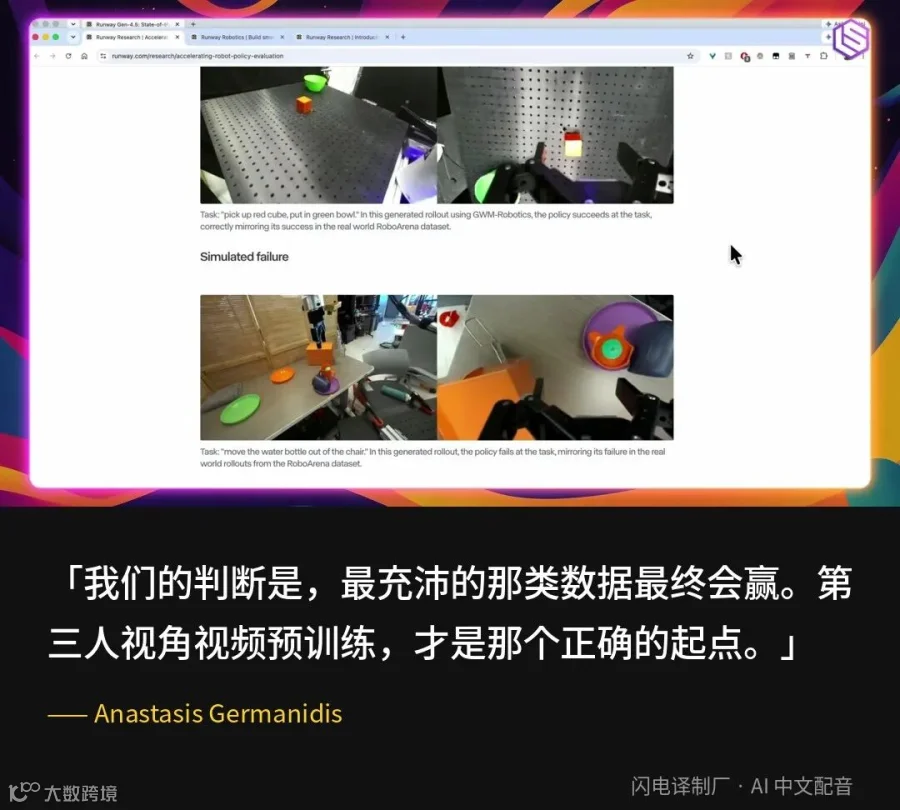
谈到机器人数据从哪来时,Germanidis 把答案押在互联网上数量最多的第三人称视频上。
第三个判断关于机器人,也是三个里最像「行业内部争论」的一个:训练机器人不该靠遥操作数据硬堆,而应该拿互联网上最充沛的第三人称视频做预训练,再用几百小时机器人数据微调。主持人 swyx 把它概括成一句话——「第三人称预训练,第一人称 SFT」。
先解释遥操作(teleop):就是人拿着控制器,一步步操作机器人完成任务,同时把这一串动作录下来当训练数据。它的问题不在技术,在成本结构——采集一小时数据就要占用一小时熟练操作员的时间,加上机器人机时、场景搭建和复位,人机比是 1 比 1,没法像爬网页那样并行复制。成果也小得让人意外:2024 年发布的 DROID 数据集,北美、亚洲、欧洲 50 名采集者做了 12 个月、564 个场景、84 项任务,总共只有 350 小时交互数据;Open X-Embodiment 汇集 21 家机构、34 个实验室、60 个数据集,凑出 100 万条以上真实机器人轨迹,但都是几秒一段的短片,折算成小时只有数千小时量级。
第一视角视频也不多。Ego4D 由 931 名佩戴者在 74 个地点采集,一共 3670 小时。Germanidis 的算术是:这类数据比第三人称视频少大约三个数量级。他的结论是一句很朴素的话:「最充沛的那类数据最终会赢。」理由也朴素——人类自己是怎么学会做事的?很大一部分是看别人做。
这背后还有机器人行业几十年的老问题:sim-to-real gap(仿真到现实的差距),在仿真里练得很好的策略,搬到真机上就变差。原因是仿真只是近似(主流物理引擎为刚体设计,布料、湿滑表面这类复杂交互极难准确建模),而传统做法是给每个环境、每个任务单独搭一套仿真,也就是那个环境的数字孪生,得先做三维扫描、材质标定,还要持续同步,费时费钱,研究人员自己也承认它「生成成本高昂,且无法产生跨域泛化」。
Germanidis 认为世界模型绕开了这一步:「而用世界模型,你拍一张环境的照片,就能开始测你的策略表现怎么样。」差别在于,传统方法要三维扫描环境、再逐个扫描物体;而世界模型只要给第一帧,就能把策略推演下去。
他给了一个可验证的证据。Runway 拿 GWM-1 世界模型,在同一个基准的同一批场景、设置和本体上,测量同一个行动模型「在世界模型里的表现」和「在真实世界里的表现」,发现两者相关性很好。不过这里要打个折扣:节目里他提到的那个基准,转写稿写成了「Roborina」,而这个词在学术库里查不到,最可能对应的是 2025 年 6 月发布的 RoboArena(由多所高校分布式评测者做双盲真机对比的机器人基准),但无法确认;他当时说的是「你点第一个链接就能看到」,而那个链接也查不到对应内容。所以这一条建议只当成方向性证据,具体基准名和相关系数数值都还没有可核实的公开来源。
「相关系数高」为什么重要?因为那意味着策略排序在仿真和真机之间是一致的,你可以在仿真里快速筛掉一批坏策略,再拿剩下的一小批上真机。反过来说,它只证明排序一致,不证明绝对成功率准确,也不证明失败模式可靠。
最能说明他态度的是那句自嘲式的说法:他们只是「把视频模型做大,结果顺手做出了一个机器人领域最先进的模型」。这句话是嘉宾自己的表述,Runway 官网对 GWM-1 的说法是「最先进的通用世界模型」,没有「机器人 SOTA」这个说法——听的时候要把这层区分留着。
这套思路现在有了名字,叫 world action model(世界行动模型)。它的做法是从预训练好的视频模型出发,加一个动作头,让模型在预测未来画面的同时预测动作。与之对立的是 VLA(视觉-语言-动作模型):把视觉语言模型用机器人轨迹数据微调,看图听指令直接输出底层动作,Google DeepMind 2023 年 7 月的 RT-2 开了这条路。VLA 的训练数据主要来自真实演示和遥操作,正是 Germanidis 认为难以规模化的那一类;所以他说「数据最多的来源会赢」,等于在说 VLA 这条路的天花板更低——这也是两派真正吵起来的地方。而且证据不足:2026 年一项综述统计 160 个基准里,只有 11 个真正做了「VLA 对世界模型」的对照。
对普通读者来说,这一节的现实含义是:为什么一家做电影特效的公司会突然开始招机器人工程师。至于 Germanidis 自己,他也没把话说满:自回归模型最大的难题是误差累积,把生成的帧再喂回去生成下一帧,很小的误差会随时间滚大;长上下文、长期记忆、反事实生成,都还没解决。
写在最后
三个判断其实是一个赌注的三个侧面:如果「把下一帧预测好」真的等于「理解世界怎么运转」,那么同一套模型可以同时变成电影工具、变成界面、变成机器人的练习场。反过来,如果这条路走不通,那这三件事就得各找各的解法,今天把它们捆在一起的公司,逻辑要重写。
Germanidis 自己在节目里留了一个挺好玩的说法。主持人调侃说,从早期那些一顿一顿的生成结果看,人类文明像是从随机噪声里被一点点去噪出来的;他接话说,那现在还只是在加噪声那一步。听着像玩笑,其实也是他对时间表的回答:还早,但方向不会变。
真正值得盯的不是产品发布,而是那个裁判指标。Physics-IQ 这类基准的分数能不能持续、干净地涨上去,决定了「世界模型」是下一个十年的地基,还是这一轮最好听的一个说法。
收听本期:小宇宙搜索「闪电译制厂」,收听《EP4|Runway 的 WorldPrompt 与实时世界的工程实现》。 https://www.xiaoyuzhoufm.com/episode/6abd2a6ae742e36efcbd4423
原节目:Latent Space(The AI Engineer Podcast,本期为 Runway 联合创始人 Anastasis Germanidis 访谈)《Runway’s WorldPrompt and the Engineering of Real-Time Worlds》 https://www.latent.space/p/runway