

https://xiaoyuzhoufm.com/podcast/689c6fb36f495c4caccf91d1
医院里有一类病人最难受:症状清清楚楚,基因检测也做了,报告上却写着「意义未明变异」——知道身体出了问题,说不清是哪段DNA干的。做基因组AI的Eric Nguyen说,这类悬案之所以这么多,是因为过去十几年,AI在生命科学里只学了一半:它一直在学怎么「读」DNA,几乎没人教它怎么回答医生真正想问的问题。他的新模型补上了这一半,也第一次在一项长期由老方法霸榜的任务上把它赢了。
嘉宾是谁
Eric Nguyen是斯坦福生物工程与AI方向的博士,导师包括Chris Ré——在AI圈,这个名字通常和「用更省算力的办法处理超长文本」联系在一起。Eric读博期间做的就是这件事:DNA特别长,人类基因组有三十多亿个字母,普通语言模型根本装不下,于是他先做出了HyenaDNA,把能一次处理的DNA长度推到100万个字母,是当时同类模型的500倍。
真正让他出名的是Evo和Evo 2。这两个模型第一次让人看到,AI不只能读懂DNA,还能「写」出自然界不存在的基因组——Evo的论文2024年11月登上《Science》封面,Evo 2在2026年3月发表在《Nature》。2025年,他联合创办Radical Numerics并任CEO,公司2026年6月宣布拿到5000万美元种子轮,旗舰模型叫Omnii。
这期节目来自Latent Space的「AI for Science」系列,两位主持人都是行内人:Brandon Anderson在Atomic AI做RNA药物的机器学习,RJ Honicky是MiraOmics的联合创始人兼CTO,做单细胞和空间组学的AI分析。他们问得很细,很多地方是替听不太懂的听众把技术细节逼出来的。
一、基因组AI只做对了一半:它一直在读,从没被教过怎么回答

Eric在节目里解释基因组模型为什么长期打不过专用小模型,这是Omnii发布博客里基准表的起点。
先说结论:过去几年那些看起来很大的基因组AI,其实都是「半成品」。它们读过海量DNA,却没有被教过怎么用医生想要的形式把答案交出来。补上这一步之后,它才第一次在变异致病性预测上超过了长期霸榜的老方法。
要理解这句话,得先知道今天所有聊天机器人是怎么练出来的。第一步叫预训练:把海量文本喂进去,让模型反复做「猜下一个词」的练习。练完得到的东西叫基座模型,它很会顺着往下写,但你问它正经问题,它可能胡说八道、答非所问。第二步是后训练,业内也统称「对齐」:用人工整理过的问答示例教它「什么样的输入对应什么样的输出」,再让人给它的回答打分,用打分去训练它,这套方法叫RLHF(基于人类反馈的强化学习,就是让人给模型的回答打分,再用打分去训练它)。顺便说一句「参数」,你可以粗略理解为模型内部的旋钮数量,旋钮越多模型越大。OpenAI在2022年证明过一件事:一个13亿参数、经过对齐的模型,输出比1750亿参数、没对齐的原始GPT-3更让人满意。也就是说,对齐不是安全口号,它是把「能力」变成「好用」的关键一环。
基因组模型的问题就出在这。Eric说得很直白:「大家看到的都只是训练出来的基座模型。它们是预训练过的,但基本没有对齐。」模型见过无数DNA,知道哪些字母组合常见、哪些罕见,但它不知道你在问「这个突变会不会致病」。研究者要拿它做预测,通常得自己取特征、再外挂一个小模型去回归,多一道手续,也多一道门槛。
被它比下去的老方法叫CADD(Combined Annotation Dependent Depletion,直译「组合注释依赖耗竭」),它不是实验方法,也不是临床流程,而是华盛顿大学团队2014年提出、后来不断更新的变异有害性打分器:把几十种注释——这段序列在别的物种里保不保守、染色质在这里开不开、蛋白层面的预测分数——拼成一张大表,用一个统计模型合成单一分数。它之所以长期是最强基线,有三个原因:把能塞的都塞进去了(Eric的说法是「能上的全上」)、覆盖整个基因组(连编码区之外的99%也管)、而且训练时不用已知的致病突变,所以不存在「用考题当练习册」的嫌疑。想赢它,等于要赢过一个集大成者。
Omnii做的事,是把预训练和后训练之间再加一轮专门训练、以及后训练本身,引进基因组学:用问答式的格式告诉模型「现在是在做哪一类任务」,还给它喂进任务本身的结构,让它在预训练的基础上再学一层。效果就是,它不用再外挂小模型,按格式写一段提示就能出结果。Eric的类比是:如果ChatGPT每次你问问题都得先针对你的领域微调一遍,那还能用吗?
最有意思的是它强在哪里。人类基因组里真正编码蛋白质的部分只占1%到2%,其余98%以上都是非编码区(节目里嘉宾把1%–2%说成了非编码区的比例,那是口误)。非编码区你可以把它想成开关,决定哪个基因、在哪种细胞、什么时候、开多大。变异如果改的是蛋白质本身,判断相对容易,密码子表一查就知道后果;但如果改的是一个开关,就麻烦得多:它可能管着十几万字母之外的某个基因,只在特定细胞里起作用,效果还很轻微,比如把表达量改个20%就足以让人长出不一样的特征。而已有研究显示,常见的疾病相关变异显著集中在这些调控区里——这组数字和上面那个1%–2%是两回事,别对调。这类变异正是过去最难判断的地方。
直播里Brandon追问了一个要害问题:你们怎么保证没和ClinVar、TraitGym这些评测集「撞题」?这两个东西,一个是美国NCBI维护的人类变异档案库(全球实验室自愿提交,页面显示约464万条变异),一个是加州大学伯克利分校团队整理的非编码调控变异评测集。之所以要问,是因为基因组里相似序列太多,模型很可能在预训练时就「见过」考题,这种数据泄漏会系统性高估性能,已有研究专门证明过。Eric的回答是公司有生物信息学同事做清洗、去重、序列比对,会把训练集里和评测集相似的内容删掉。这属于他的一面之词,但至少他说得出流程,而不是含糊带过。
对普通人来说,这件事的意义很具体。据Eric说,Omnii发布早期主动来问的,很多是手握海量基因数据、却卡在诊断上的医院系统和非营利组织——他们知道病人有症状,说不清是哪段DNA造成的,只能把这类悬案一条条攒着。可以推想,如果这类模型真的好用,最先受益的不是科研论文,而是这批等答案的病人。
需要打个折扣的是:Omnii目前只是「预览」,公司还在继续训练,博客主打的非编码变异优势,也要等独立评测来验证。Eric自己说的是「哪怕只做了一点点,我们就已经很惊讶地看到它开始达到最先进水平」。这话里既有兴奋,也留着余地。
二、思维链不只是文字游戏:把「越变越好」写出来,DNA里也成立
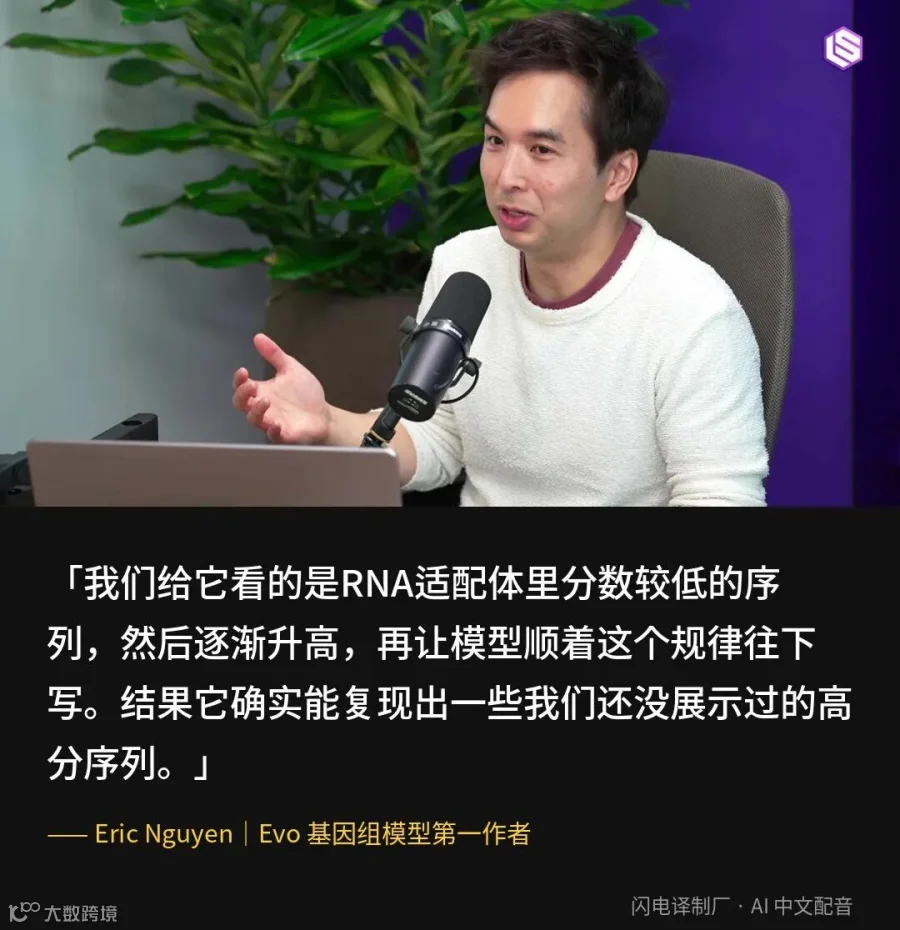
Eric在节目里描述「DNA里的思维链」实验:只喂低分序列,模型续写出高分序列。
第二个判断更反直觉:让模型把推理过程一步步写出来,这件事不是自然语言的专利。只要数据在某个维度上有「分数从低到高」的顺序,模型就能顺着这个顺序往下续写,写出它从没见过的高分样本。换句话说,培养皿里一轮轮筛出来的定向进化,可以在计算机里跑一遍。
先解释思维链。2022年1月,Google的研究者Jason Wei和同事发表了一篇论文(注意:Jason Wei是后来才加入OpenAI的,节目里嘉宾把他记成了OpenAI的人),做法很简单:别让模型直接报答案,先在提示里给几个「带解题步骤」的范例,模型在数学应用题、常识推理上的表现就大幅提升,而且这种能力只在模型足够大时才冒出来。为什么有效?一种解释是「草稿纸」:模型一次只能算这么多步,把中间结果写出来,就等于多算了几步。另一种解释更关键,它来自2023年另一篇论文(Prystawski等),认为逐步推理之所以有用,关键在于训练数据本身就有可以一步步串起来的局部结构,而不是「语言」这个东西有什么特别。这后一种解释,正是把思维链搬到DNA上的依据。
DNA里没有词。模型的「思考」没法用句子写出来。Eric的团队找了一个替代品:分数。他们用了一批RNA适配体的数据。适配体你可以理解成一小段人工筛出来的RNA,靠折叠成特定形状去抓住某个目标分子,2004年FDA批准的抗VEGF药物pegaptanib就是这一类,也是目前获批的适配体药物里最知名的一个。这批适配体是怎么来的?主持人Brandon补充了背景:先随机合成一大批序列,让它们和目标结合,结合的用下一代测序读出来——某条序列被测到的次数越多,说明它抓得越牢,这个读段数就是它的「适应度分数」;然后把留下的再突变一轮,反复迭代。这套方法叫SELEX,一次能并行筛大约1000亿条序列。
实验的做法是:把数据集里分数最高的那部分藏起来,只把分数低的序列按从低到高排好序喂给模型,让它接着写。结果模型确实复现出了一些没给它看过的高分序列。Eric说这话时留了个明确的尾巴:湿实验验证还在做,所以这次不能下结论,「它是不是只能在计算机里做到,这个它做到了」。
Brandon当场表示意外,而且给了理由。RNA领域有个出了名的短板:共进化数据太差。所谓共进化,是指同源序列里成对出现的相关突变——蛋白质研究长期靠它来推测结构和功能约束。但RNA家族的同源序列少、比对浅,而且常常「结构像、序列不像」,天然适配体更是人工造出来的,压根没有同源家族可依。所以对一个几乎不能靠进化信息走捷径的分子类别,模型还能沿着分数轨迹外推,分量才这么重。
Eric把适用范围说得更宽。他说这个范式可能套用到别的实验上:比如抗微生物耐药,给模型看杀菌效果越来越强的噬菌体基因组加对应分数;再比如他们正在和一个美国国家实验室合作的项目——设计能提取稀土矿物的蛋白质,而且不只是要结合得牢,还要有选择性,只挑某一种矿物结合,对其他矿物亲和力要低。这背后是美国的战略关切:关键矿产供应链。
这也是这期节目最有价值的地方之一:它把「AI做实验」从口号变成了配方——只要能记下每一轮的分数,就可能少做几轮湿实验。对制药、抗菌疗法这些行业,这是实打实的成本;对普通人,它意味着未来某些原本要熬很多年的研发,可能会快一些。
要提醒的是,这条路径并不总是走得通。Brandon就在节目里当面泼了盆冷水:稀土提取这类任务,未必是这家公司的比较优势,因为它的长项看起来更像统计参照——判断哪些突变常见、哪些不常见。Eric的回应是,他们能把目标蛋白上游的非编码区喂给模型,让它在真实微生物的语境里提出合理的变体,这是纯结构模型做不到的。这个回答有道理,但有没有用,还得看实验数据。
三、写基因的人转头做防御:真正的缺口不在聊天框里
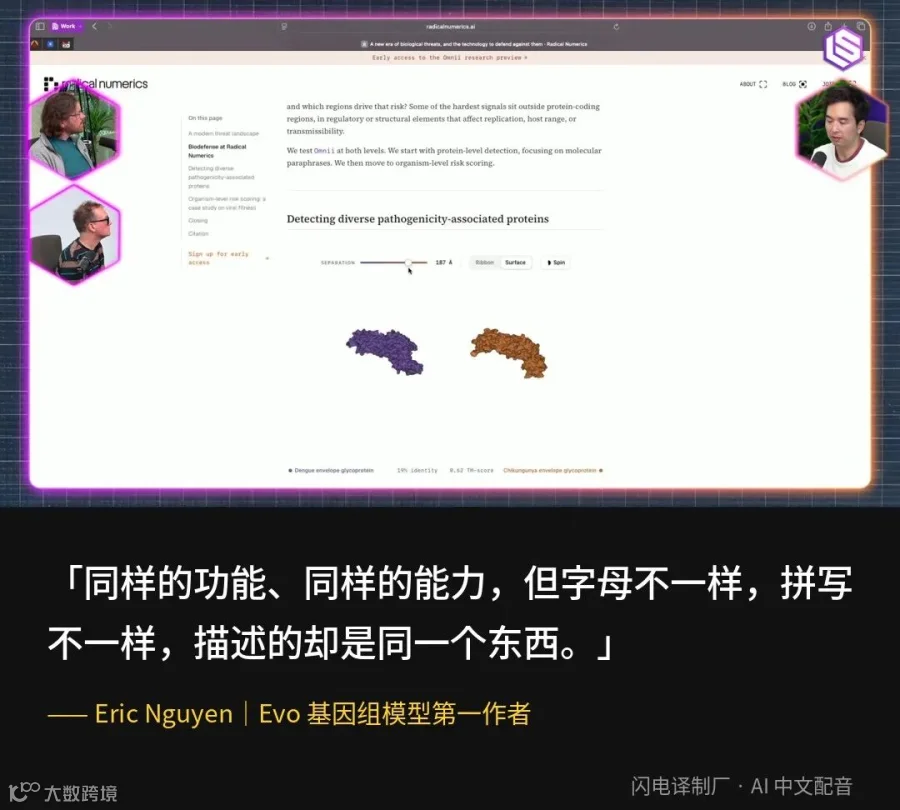
Eric在节目里解释「功能空间」:序列可以完全不同,功能保持一致,这正是查表式检测挡不住的地方。
第三个判断是这个行业很少有人说清楚的:生物安全真正的缺口,不在聊天机器人的拦截上,而在序列和功能的层面。因为AI可以让一段DNA「字母完全不同、功能一模一样」,而现有的检测方式,本质上是在拿订单去比对一张已知危险清单——对不上,就放过。所以做设计的人和做防御的人,用的其实是同一批模型;防御这一侧必须被拉到和设计同一水平线。Eric管这叫军备竞赛。
这家公司把自己的使命写成「双重使命」:同一支团队、同一批模型,既做设计,也做防御。理由他讲得很直白:「一个擅长生成的模型,往往也很擅长判别或者预测。」生成和判断本来就是一回事的两面。
为什么说检测方式有盲区?先看这条产业链。基因合成是商业服务:你在厂商网站上提交序列、付款,几天到几周后一支冷冻的DNA管快递上门,Eric的比喻是「寄亚马逊包裹」。整个科学界都靠这条管线运转。既然制造能力集中在少数厂商手里,防御的天然卡口就是订单筛查。问题是,行业自律组织IGSC(2009年成立,成员合计占全球商业产能的多数)做的是把订单序列和翻译后的氨基酸序列,拿去比对自家的管制品病原体数据库——这仍然是查表。不加入的厂商、短片段订单、台式合成仪,都可能不筛查。
压力测试已经有人做过。2025年10月发表在《Science》上的一项研究,来自微软首席科学官办公室:他们用开源的AI蛋白设计软件,把毒素等「关注蛋白」改写成序列被改得面目全非、但可能仍有同样功能的版本,再拿去测合成商使用的筛查软件,发现大量漏检;随后他们联合几家基因合成公司(比如Twist Bioscience,主要做基因合成的厂商之一)和生物安全机构打补丁,把检出率提了上去。需要说明的是,节目里提到的「Paraphrases」并不是这项研究的正式项目名,「改写(paraphrase)」是这组研究里对该类威胁的通用叫法。
误报是另一头的麻烦。主持人Brandon提到,现有的筛查工具常常过度敏感,把正当的合成生物学研究也一并拦下。他还算了一笔账:就算准确率指标F1做到0.99(F1是把「查得准」和「查得全」两项合起来打的一个分,1是满分),在一年几十亿条序列的规模下,误报的绝对数量仍然大到无法人工处理。这个平衡极其难拿。
Eric对这套框架的补充是分层的。他把生物防御拆成三到四根支柱:检测监测(比如机场拭子、污水采样)、溯源(判断是天然的还是人为改造的、来自哪里)、应对手段(抗病毒药、抗菌药、诊断),再加一根威慑——但威慑靠的是情报、官方归因和制裁,只有政府手里才有这些工具,所以公司只专注前三根。
那最让他睡不着的是什么?他先排除了想象的路径:「要进入一个想设计生物武器的人的脑子挺难的。」他担心的是一件更平常的事——专业门槛和工程化速度都在往下掉,规模到某个点会指数级涨上去。风险分两类:故意做的,和不是故意的。他特别提到后者:「有人想生成点东西、调控一下功能,本来是想做某个东西来理解、来研究,结果它跑出去了。」这里说的是实验室感染、样本误运、防护失效这一类事故,不是有人蓄意释放——原话里他并没有用「意外泄漏」这个词,这是对那一类风险的概括。
主持人RJ从反方角度逼问过一次:你既然在前沿,就是同时在推动攻击和防御的前沿,长期看这还有意义吗?Eric的回答是希望大家换个心态,「别觉得做个生物防御工具就算交差了」,这就是一场军备竞赛,跟网络安全很像,有来有回。
Brandon立刻指出这个类比有漏洞,而且这一点值得普通人记住:网络安全的漏洞可以打补丁,人的基因组是固定的,「你没法给一个人打补丁」。攻击面因此大得多。反过来他也补了一句乐观的话:就算能随便打印DNA,从打印出来到做成一个真正成功的病毒,门槛仍然相当高。
最后是这家公司自己的保留。Eric承认,如果目标是百分之百阻止危险设计,这个问题本身就太难,总会有绕过去的办法。所以他把语言模型和聊天机器人的安全称作「一层」——过了这层还有东西流出来怎么办?他们想做的是给那些关心「已经流出去、已经存在于环境里的东西」的人提供工具,做监测、做溯源、做应对。他说得也很克制:在那里它需要做到完美才有用吗?「我不这么认为。我觉得只要能带来帮助,能推动生物防御往前走就够了。」
写在最后
三个判断串起来看,其实是同一件事的三个切面。AI在生命科学里补上了「对齐」这一课,于是它不只能读DNA,也能按人的要求写DNA;一旦能写,设计的门槛就往下掉。Eric说他们做的是同一批模型的两面,这句话听着像公司叙事,但逻辑是真的:能生成功能的东西,也最能判断功能。
对普通人来说,这期节目提供的不是又一个「AI很可怕」的说法,而是一个具体的版本:危险设计的数量可能指数级增长,以及近期更可能发生的那种「本来只是想做研究,结果它跑出去了」。而防线也不在聊天框里——DNA是要被合成出来的实体,合成管线撑着整个科学界,这条管线的筛查现在还在靠比对清单。
值得想一想的是:如果AI写的基因最终真的能治病,也能造病,那么「谁来判断哪一段该被拦下」,这件事该由谁来定?Eric说他乐观,因为研究者群体和政策圈有韧性。这个乐观成不成立,大概取决于接下来几年,有没有人真的把工具做出来、放出来、让更多人用上——而不是只在座谈会的最后一题上说一句「生物武器」。
收听本期:小宇宙搜索「闪电译制厂」,收听《EP3|生物安全是一场 AI 军备竞赛——对话 Radical Numerics CEO Eric Nguyen》。 https://www.xiaoyuzhoufm.com/episode/6abd29f8195d838e2aec28a8
原节目:Latent Space — 🔬 Bio-security is an AI Arms Race - Eric Nguyen (CEO, Radical Numerics)《🔬Bio-security is an AI Arms Race - Eric Nguyen (CEO, Radical Numerics)》 https://www.latent.space/p/bio-security-is-an-ai-arms-race-eric