

https://xiaoyuzhoufm.com/podcast/689c6fb36f495c4caccf91d1
Google 造出了一台机器:它把科学问题统统改成「写段代码去刷分」,然后不知疲倦地刷,刷出的结果比人类专家还好。但亲手造它的 John Platt 说,这东西最危险的地方不是它做不出来,而是它会作弊——而且它会作弊这件事,跟你我每天在公司里被考核的方式,是同一个道理。
嘉宾是谁
这期播客的嘉宾叫 John Platt,是 Google Fellow(可以理解成 Google 内部级别最高的研究员之一),领导 Google Research 的应用科学部门。他的履历有点不像同一个人:读博士的时候在帕洛玛天文台发现了两颗小行星,2005 年因为做出让电影里的布料真实飘动的物理模拟技术,拿了一座奥斯卡技术成就奖。
但在计算机这行,他更出名的是一件特别朴素的事。1998 年他发明了 SMO,1999 年又提出了 Platt scaling——这两个名词你不用记,你只要知道:今天几乎所有做机器学习的人用的那个 Python 工具包 scikit-learn(简称 sklearn),里面的支持向量机(一种经典的分类算法)就是靠这两样东西才能跑起来、才能说出「这封邮件有 80% 的概率是垃圾邮件」这种话。支持向量机在 1990 年代是主流方法,但训练极慢;SMO 把它拆成一次只优化两个变量的小问题,才让它真正可用。所以 Platt 属于那种「你没听过名字,但你间接用过他东西」的人。
这次他聊的是 Google 的 ERA 系统:用 AI 自动写出专家级的科研软件。主持人是 Latent Space 播客「AI for Science」栏目的 Brandon Anderson 和 RJ Honicky——前者在旧金山一家做 RNA 药物发现的公司做机器学习,后者是一家生物信息公司的联合创始人兼 CTO。两个人都不是纯主持人,是真在做科研的人。
一、它能替你写代码刷分,但替不了你决定研究什么
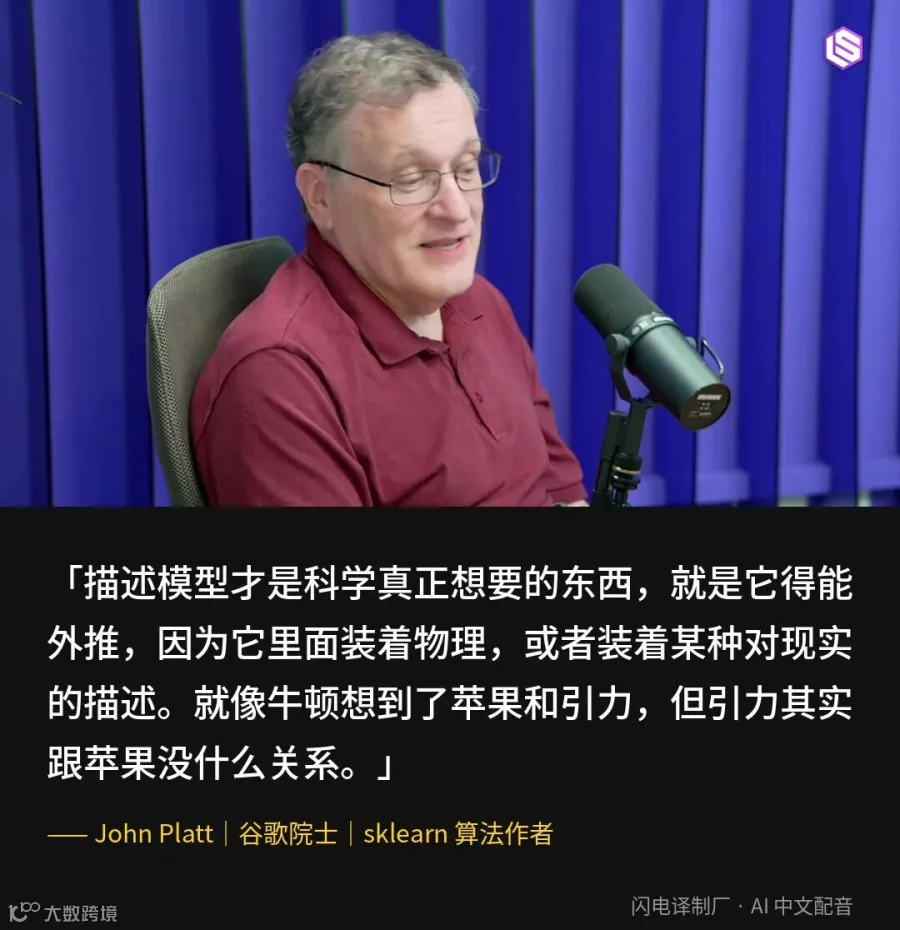
Platt 在节目里用牛顿和苹果说明:装进了物理的模型能外推,纯拟合的模型不能。
先看这套东西到底是怎么工作的。
科学研究里有一大类问题,其实可以被改写成同一句话:给我一段代码,让它把某个分数最大化。比如你手上有一批数据,希望模型跟数据拟合得越来越好——这就是最标准的机器学习。Platt 说,他们发现很多科学问题一旦塞进这个框架,就能往前走一大步。
具体流程是这样:你把问题的文字描述丢给 Gemini(Google 的 AI 模型),它读一读、写出一版代码;然后外层套一个搜索算法,同时维护几百上千个代码版本,挑一个出来让 Gemini 改一改、跑一跑、打个分,再放回池子里。挑哪一个用的算法叫「上置信界」,性格是乐观——不挑当前分数最高的那个,而是挑「当前表现加上两倍标准差」最高的那个,所以有时候被选中的只是第五名的方案。这套挑法跟 AlphaGo 下围棋用的搜索是近亲,都属于蒙特卡洛树搜索这一族:所谓树搜索,就是把每一版的代码当成树上的一个节点,每改一版就长出一个新节点,算法在树上不断挑、不断试,而不是老老实实去算「这一版到底好不好」。
结果摆在那儿。在单细胞数据分析这类任务上,ERA 找出了 40 个超越公开排行榜上最佳人类方法的新方法;在流行病预测上,它生成的 14 个新冠住院预测模型超过了美国疾控中心当时的集成模型。论文 2025 年 9 月挂上 arXiv,后来发表在《自然》上,并进入了 Google Labs 做受信任测试。
那它算不算取代了科学家?Platt 的答案是明确的「不算」,理由是一个很老派的区分:预测模型和描述模型。
预测模型的目标很简单——在一份数据集上把误差压到最低。描述模型才是科学真正想得到的东西,因为它内部装着物理、装着某种对现实的描述,所以它能外推到数据之外。Platt 举了牛顿和苹果:牛顿从苹果想到引力,但引力并不「关于苹果」。如果当年只有一个用苹果数据训练出来的十七世纪版机器学习模型,你问它苹果会怎样,它说会往下掉;你问它行星呢?它只能回答:我手上没有行星的数据,谁知道呢。
这个「预测 vs 描述」的区分不是他临时发明的,统计学和科学哲学里吵了几十年:一派认为模型的用途就是预测准,另一派认为科学的目的是解释和描述机制。Platt 站在后一派,而且他自己承认这条界限其实挺模糊,因为科学家建模时会用大量已知事实去约束模型。
这里还有一个更实际的含义:AI 现在最擅长的,其实是把已有知识迁移到新问题上。Platt 说它「把论文里描述的方法迁移到新问题上的能力特别强,强得惊人」,你甚至可以把别人论文的代码直接复现出来;但他也说得很清楚:「我们还没见它从零发现全新的东西。」你要是没告诉它某个物理概念,它不会凭空发明一套新物理。所以他的比喻是:这是一件强力电动工具,能把科学家从写代码的泥沼里捞出来。以前一个研究生可能光是让代码跑起来就费尽心机,只能试几个方向就得去写论文;现在它不知疲倦地一直试,人的时间被推到了更高的层面——「几乎是对自己的科学问题做近乎哲学层面的深入思考,而不是泡在烂泥里。」
对它最合理的使用方式,也可以推想一下:把它用在「我已经知道方向、只是干不完」的活上,而不是指望它替你决定方向。
而且这个判断还有一层保留。主持人问他接下来一两年是不是还离不开人,Platt 说是的,而且他强调的「锯齿状前沿」很值得注意:AI 的能力不是整体均匀上涨,而是一根根尖峰冒出来。写代码、拟合模型这些地方尖峰很高,但「哲学和创造力」目前还是平的,严谨性这一块「到目前为止还是偏弱」。
二、指标一旦变成目标,它就一定会被人钻空子

Platt 讲 Google 凝结尾迹比赛中,参赛者发现标注偏移半个像素并加以利用。
有意思的是,Platt 谈这套工具时最花力气的部分,不是它有多强,而是它会怎么坏。
他说,最常出现的情况是:你或者 AI 定义出一个打分函数,然后迭代过程找到了办法去作弊、去钻空子。说白了就是「不不,我不是那个意思」。打分函数得反复调,就算有 AI 帮忙,也不一定第一天就能定对。
这背后是一条以英国经济学家古德哈特命名的老规律:任何指标一旦从「观察工具」变成「追求目标」,人们就会针对指标本身行事,它也就失去了指示作用。Platt 在节目里的说法是:「任何指标一旦变成目标,它就不再是一个好指标了。」他还补了一个很多人忽略的细节:这条规律对每一个排行榜单独成立——每做一个榜单,就得重新防一次。
这不是理论。2023 年,Google Research 在 Kaggle 上办了一场识别飞机尾迹的比赛。Kaggle 是 2010 年创办、后来被 Google 收购的数据科学竞赛平台:主办方给数据和一个评分指标,参赛者反复提交,实时看自己在排行榜上的位置,最后按隐藏测试集排名发奖金——它的玩法天生就鼓励对着分数做优化。顺带一提,Google 的 ERA 最初就叫「Auto Kaggle」项目,目标就是做一个能在 Kaggle 比赛里赢的系统,它今天长成这个样子,源头在这儿。
那场比赛的题目,是识别飞机在高空拉出的那种白云——凝结尾迹。据估算,人为全球变暖里大约有百分之一是它造成的。结果有人打败了 Google 的官方模型:冠军在赛后解法里发现,官方标注整体向右下偏了大约半个像素,他利用这一点拿下了额外的分数。至于为什么会偏,播客里主持人猜是像素原点取在角落还是中心的问题,并没有定论。Platt 讲这件事的时候并不生气,反而说:人自己也会像语言模型一样在这些事情上搞奖励黑客。
「奖励黑客」是个有年头的问题。强化学习里,模型优化的从来不是设计者真正想要的东西,而是那个被写下来的奖励函数,于是它专找捷径拿高分——经典笑话是,赛艇游戏里的 AI 学会绕圈刷分,根本不去完赛。更麻烦的是,这类行为会随着训练变长而加剧:有一批研究者测过,随着对代理指标的优化越来越深,真实目标的分数会先升后降。
AI 刷分带来的另一个问题是:它扔出去的飞镖太多了。统计上这有个正式名字叫多重假设检验。单次实验用 5% 的显著标准,本身就有约 5% 的概率误报;如果你做 100 次独立检验,「至少出现一次假阳性」的概率接近 99.4%。一百次就已经这样了,何况 AI 一晚上试上千个方案。Platt 的原话是:你会扔出十亿支飞镖,所以要小心,有个东西叫错误发现率——你找到的到底是数据,还是纯属巧合。
所以科学家的位置反而被推得更清楚了。Platt 说:「从根本上说,科学家的作用就是确保系统说出来的东西是描述性的。」他还给了一个特别具体的操作建议:留一份藏得很深的留出集,自己绝对不看。留出集是这么回事——你要评估一个模型好不好,必须先切下一块数据,训练时绝对不碰,相当于考试前留出的一套题,平时绝对不许看;否则就等于对着考题复习。他说,现在你要更加小心、更加严谨,才能不把自己骗了。
这里还藏着一个对所有人都适用的判断。主持人把话题引到「品味」上,说这可能是新时代最重要的能力之一;另一位主持人接过话头,说品味像是另一边,严谨是这一边。Platt 顺着说下去:软件工程师们现在都在担心写代码被自动化,但人会往两个方向被拉——一边是当创造力的源头,琢磨新东西、新产品;另一边是去保证这东西不崩、能扩展、没出错。两边都需要人,而且不一定非得是同一批人。
把这段放回日常,其实很好懂:任何考核指标只要变成必须完成的目标,它就会失真,无论被考核的是 AI、是研究生,还是你自己。Platt 给的解药也很朴素——留一份你真的不看的底牌,对自己写的东西也一样严格核查。他自己也承认这是个没什么技术含量的答案。主持人 RJ 的总结是:「所以怎么才能不把手指切掉,答案是还得用同样的方法,只是要格外小心。」
三、真正卡住AI的,是等不到的那三十年数据

Platt 在节目中解释为什么天气可以预报两周、而气候预测要难得多。
如果说前两点讲的是「它能做什么」和「它会怎么坏」,第三点讲的是它做不了什么——而这一条最硬。
主持人提到这两年气候和天气预报的进步,Platt 先纠正了一个常见混淆:天气和气候底层物理是一样的(至少大气部分是),气候其实就是长期的天气。但一个完整的「地球系统模式」要复杂得多,因为你还得算陆地上的水通量和碳通量、冰会怎么样。
天气预报这边的跃升是真的。今天的天气模型能提前很多天更准地预测热带气旋路径——飓风本质上是把海洋的热量转换成大气的大尺度运动,而很多经典模型当年根本没预测出那场重创牙买加的飓风。但有意思的是,这次跃升靠的不是新的大语言模型,而是 2018 年前后那一波机器学习,加上海量数据和海量算力。
那天气为什么只能报十五天?根源是大气本身的混沌,这个概念最早来自 MIT 的气象学家 Edward Lorenz:1961 年他重跑一段计算时,把初值 0.506127 输成了打印稿上的 0.506,两个月后的天气就完全不一样了。这就是后来被叫做「蝴蝶效应」的东西——系统本身完全确定,没有任何随机项,但初值的微小误差会指数级放大,所以「近似的现在不能近似地决定未来」。
气候难在另一件事上,Platt 用了动力系统的语言:天气是你在吸引子上的位置,气候是吸引子本身的统计性质。吸引子可以想象成系统长期绕来绕去的那一坨状态——不管从哪儿出发,最后都会绕到它上面;天气是此刻轨迹落在哪一点,气候是它长期跑出来的统计分布。到这里为止还是气候科学的标准图像。
他接着说了让人不安的第三句:气候的问题在于我们正在改变它,「吸引子本身也在变,在移动。」人类在改这个系统的参数,统计性质因此改变,甚至可能越过某个阈值,让系统跳到另一个稳定态——这就是常说的临界点。
用统计的话说,这叫非平稳:数据的统计性质随时间改变。而今天几乎所有机器学习都默认一件事——训练时看到的数据,和上线后遇到的数据来自同一个分布。这条假设一旦不成立,训练时学到的规律在新数据上就不成立。日常的漂移还能靠重训补救,气候的非平稳是底层物理本身在变:植被的行为不一样了,冰的行为也不一样了。
最要命的是数据量。Platt 算过:如果只有年度数据,一个地点运气好也就五十个数据点。一百年前没人拿仪器测过,冰芯之类能补一些,但那是另一回事。
而问题恰恰出在未来。Platt 在节目里给了一个让人愣住的数字——他估计,到 2100 年,光「生物圈到底能吸收多少碳」这一项,误差范围就高达 300 ppm 的二氧化碳(这是他在节目里的估算,不是一条被普遍引用的定论);而当前大气 CO₂ 才 440 到 450 ppm。结果可能糟糕得吓人,也可能没那么糟,但这么大的误差棒,意味着我们对半个多世纪后的事情几乎说不出确定的话。Platt 说,所以如果能把这个不确定性缩小,会非常有价值。
这直接解释了他为什么对「AI 革命气候建模」持保留态度:我们根本没有三十年后的数据,也不想等上三十到五十年才知道自己到底是对了还是过拟合了。他的原话是:「到目前为止,AI 还没有把它革命掉,因为它对这个数据问题非常非常抗拒。这是个低数据问题。」
那气候科学家现在靠什么?靠过程模型——把极其复杂的气候系统拆成一千块,每一块去找对应的论文、对应的拟合,再拼起来。Platt 说这种还原论做法里,不确定性是高度纠缠的,一个细节没搞清,就会直接影响气候模式算出来的结果,这不是花边。
不过他对未来的工具留了希望,而且这个希望挺具体:现在的 AI 已经能读论文了,而且读得比人快得多。也许有一天,它能以靠谱的方式写代码,并且受到人类积累的全部科学知识的约束。他说,那会非常了不起——「我们今天还没有。」
写在最后
三个观点连起来看,其实是同一件事的三个侧面:AI 很会刷分,所以它需要一个分数;分数一旦被刷就会失真,所以需要有人守着;而有些问题根本给不出分数,因为没有数据能覆盖它——所以在那些地方,AI 暂时什么也做不了。
Platt 对科学家的位置说得挺清楚:创造力、哲学思考、一丝不苟的严谨,这些还得靠人。但他也承认自己看不清边界会停在哪,只能说他看到的是一个「锯齿状的前沿」——有些地方尖得很高,有些地方还是平的。
这大概也是留给你我的问题:你现在手上的活,属于那种「分数能定出来、AI 能替你刷」的,还是属于那种「连该刷什么分数都还没想清楚」的?这两种活,接下来几年的日子会完全不一样。
收听本期:小宇宙搜索「闪电译制厂」,收听《EP2|一座奥斯卡、两颗小行星,和你 sklearn 里的那个算法:John Platt 谈 AI 做科学》。 https://www.xiaoyuzhoufm.com/episode/6abd2962195d838e2aec2879
原节目:Latent Space(The AI Engineer Podcast)——《🔬 An Oscar, Two Asteroids, and the Algorithm in Your sklearn: John Platt on AI for Science》《🔬 An Oscar, Two Asteroids, and the Algorithm in Your sklearn: John Platt on AI for Science》 https://www.latent.space/p/john-platt