谷歌发布Gemini 4 Argon:智能追平GPT-6,主打高性价比与低幻觉
新智元报道

沉寂7个月后,Google DeepMind于北京时间10月1日凌晨正式发布Gemini 4 Argon。这是其近半年来首款非Flash级专有模型,旨在通过极高的性价比和较低的幻觉率,重新确立在前沿大模型市场的竞争力。

在Artificial Analysis的智能指数评测中,Gemini 4 Argon获得53分,与GPT-6 Astra及Fable 5.1持平,略高于GPT-6.1 Sol。其显著优势在于将幻觉率降至15%,并在Agent能力及网络安全基准测试中表现优异。


目前,该模型已向选定用户开放,支持1M上下文窗口及多模态输入。凭借极具侵略性的首发定价,Argon直接冲击了当前大模型的价格战格局。
价格透视:单价极低但用量大,长期成本需精算
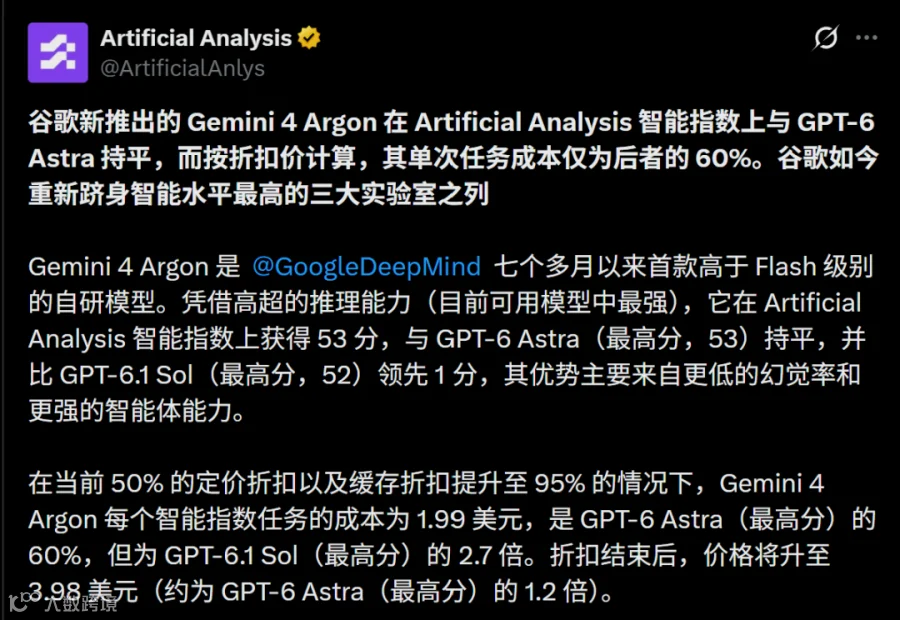
虽然智能分数追平竞品且账单看似更薄,但深入分析发现,Gemini 4 Argon采取了“低单价、高用量”的策略。促销期结束后,其实际任务成本可能反超部分竞争对手。


重回第一梯队,定价策略激进
Gemini 4 Argon是谷歌超过7个月来推出的首款高于Flash级别的闭源模型。其在智能指数上比上一代非Flash模型Gemini 3.1 Pro Preview高出23分,标志着谷歌重回全球顶尖AI实验室行列。

为吸引用户,谷歌制定了极具诚意的首发价格:
- 输入Token:每百万2美元(约为Opus 5.5的一半,Astra的1/5);
- 输出Token:每百万10美元(同为Opus 5.5的一半,Astra的1/5);
- 缓存折扣:符合缓存条件的输入享受95%折扣,折后每百万仅需0.10美元。

隐性成本:推理过程冗长导致总账单增加
尽管单价低廉,但Argon的平均单次任务输出量高达6.2万Token,远超Astra的2.7万Token。这意味着虽然“纸张便宜”,但“草稿”写得更多。
在智能指数测试平均任务成本中:
- Gemini 4 Argon:1.99美元(低于Astra的3.26美元、Opus 5.5的5.98美元);
- GPT-6.1 Sol:仅0.72美元(Argon约为其2.7倍)。
需注意,上述价格为首发5折促销价。若恢复标准价(输入4美元/百万,输出20美元/百万),Argon的单任务成本将升至3.98美元,约为Astra的1.2倍。因此,企业用户在长期接入前,需结合自身任务的输入长度、输出需求及缓存利用率进行详细测算。
能力评测:低幻觉率与强大的Agent执行力

克制即智慧:幻觉率行业最低
在AA-Omniscience测试中,Gemini 4 Argon的幻觉率仅为15%,是智能指数45分以上模型中最低的(Astra为51%,Sol为54%)。这得益于模型更倾向于承认“不知道”,而非强行生成错误答案。
然而,低幻觉率并未完全转化为高准确率。Argon在该测试中的准确率为50%,低于Astra的63%。综合来看,Argon在“少犯错”方面表现卓越,但在“答对题”的数量上仍有提升空间。
Agent能力:自动化与安全领域表现突出
在实际执行任务方面,Argon呈现出差异化优势:
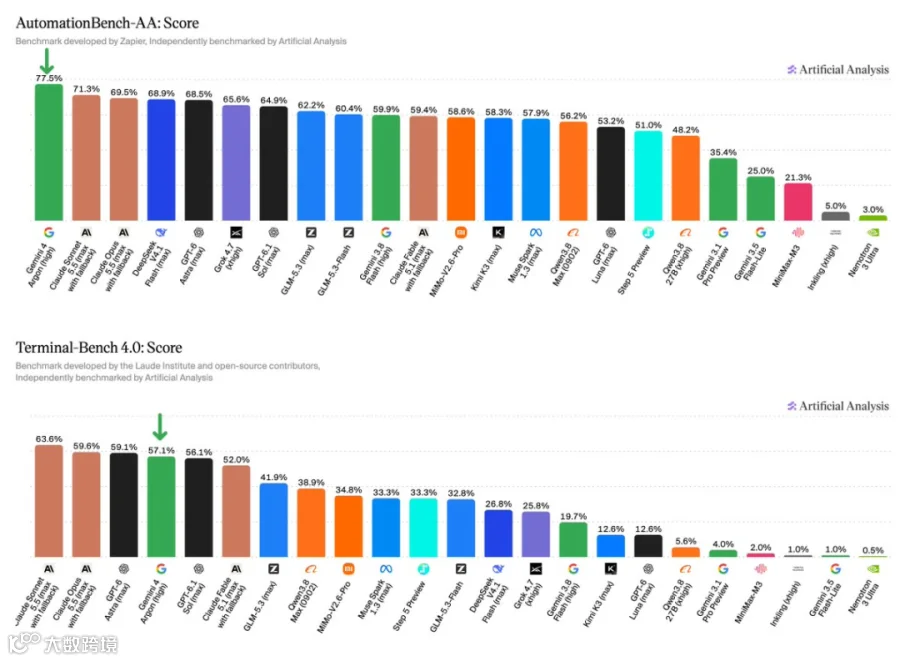
- 自动化基准:在AutomationBench-AA中以77.5%的成绩位列第一;但在Terminal Bench 4中得分为57%,落后于Sonnet 5.5、Opus 5.5和Astra。
- 任务完成度:在AA-Briefcase测试中,满足评分细则的比例高达65%,但分析与呈现质量偏低,显示其在“按要求交活”与“高质量交付”之间仍有差距。
- 网络安全:在CWE-bench v1中并列第一(68%),具备自主发现、验证漏洞并生成PoC(概念验证)的能力。
- 文本处理:在Text Arena中排名第一。


实战应用:已介入谷歌核心基础设施优化
相比榜单数据,Gemini 4 Argon在谷歌内部的实际应用更具说服力。目前,该模型已深入参与数据中心性能优化及代码迁移工作。
数据中心内存优化
Argon智能体通过分析数据中心性能数据,识别出内存优化点并实施改动,最终释放了超过300 TiB的内存资源。这一案例证明了模型在处理复杂系统工程问题上的实际价值。

代码迁移与性能提升
- C/C++转Rust:Argon正参与超过80万行内核代码向Rust语言的迁移工作,目前处于审计和测试阶段。
- 视频解码器优化:智能体使用安全Rust替换了3.2万行SIMD代码。结果显示,新版代码运行速度提升2.7倍,且视频输出保持一致,满足了严格的工程效率要求。
超长上下文与断点续传
Gemini 4 Argon支持1M Token上下文,可处理文字、图片、视频和语音。针对长任务易超时的问题,Gemini API新增“Long Decode Continuation”功能,允许长回复暂停并通过后续调用继续输出,理论上支持长达1M输出Token的推理过程,为复杂工程任务提供了技术保障。
随着OpenAI、Anthropic和谷歌形成三方抗衡局面,用户在选择模型时不仅关注分数和价格,更看重具体的工程落地成果。Gemini 4 Argon通过降低幻觉率和展示内部基建优化成果,展示了其在长期使用中的潜力。然而,促销期后的真实成本效益,仍需用户根据自身业务场景仔细评估。
参考资料:
编辑:Aeneas 大卫