


当前,许多企业面临“业务排队等算力”与“大量算力低效空转”并存的尴尬局面。过去一年,无论是英伟达 GPU 还是昇腾、海光等国产 AI 芯片大规模进驻数据中心,但硬件投入并未直接转化为业务效能。小任务独占整卡、异构芯片环境割裂等问题,导致账面算力增加而实际可用算力未同步增长。随着 Agent 批量部署,这种“买得多却调不动”的矛盾愈发凸显。
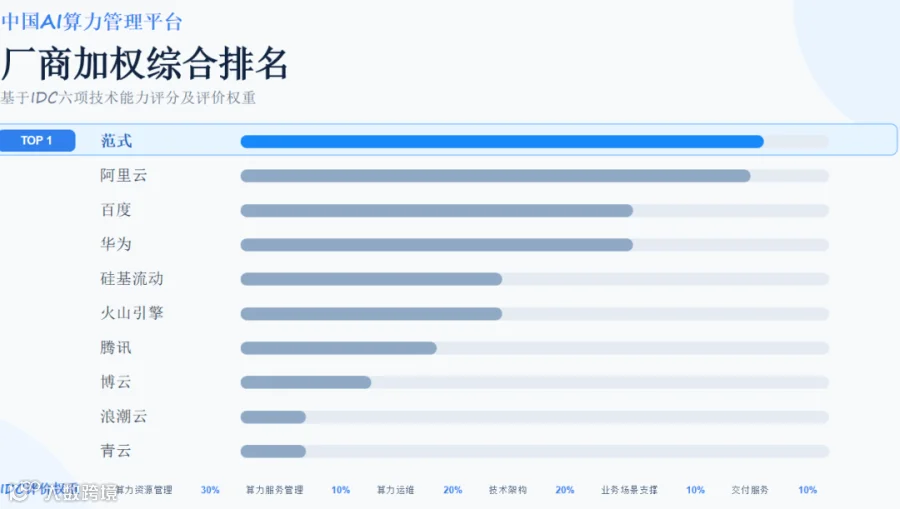
如何高效组织调度算力,成为企业 AI 落地的关键。近期,IDC 发布《中国 AI 算力管理平台技术能力评估,2026》,范式智能(前第四范式)在资源管理、运维、技术架构及交付服务四项维度获满分,综合评分位列第一。
算力损耗的三大断层
企业账面硬件与实际可用算力之间存在巨大鸿沟,主要源于以下三个工程层面的断层:
异构芯片的软件壁垒
出于供应链安全考虑,企业机房常混用多种品牌计算卡。由于缺乏跨芯片的统一抽象层,不同芯片需搭建独立的“烟囱集群”,驱动、编译环境及算子库互不兼容。这导致集群间无法动态互援,出现一侧过载排队、另一侧空转闲置的现象。
整卡分配导致的隐性浪费
传统调度以“整卡”为最小单位,轻量级任务即使仅占用极少显存也需独占一张大算力卡,造成“资源假溢出”。在分布式训练中,若缺乏跨节点强协同调度,部分节点等待资源会导致整个集群陷入低效内耗。
Agent 带来的潮汐冲击
相比大模型固定批处理的稳态计算,Agent 时代呈现长链路、高频反思、多模型联动的脉冲式洪峰特征。若底层仍依赖静态分配与人工预留,要么因盲目堆卡承担巨额闲置成本,要么在突发流量下因缺乏动态弹性导致业务卡顿或宕机。
盘活算力的三层核心能力
对照 IDC 评估维度,将散落硬件转化为可用服务需补齐以下三层能力:
细粒度切分与安全隔离
为解决整卡粗放分配的浪费,行业正探索兼顾性能与隔离的虚拟化方案。由范式团队主要贡献、今年 7 月晋升为 CNCF 孵化级项目的开源调度器 HAMi,聚焦动态弹性切分与消除资源误判,打通与批量调度引擎的协同,旨在降低复杂生产集群的资源损耗。

大规模任务的成组协同
针对分布式训练节点各自为战的问题,调度层需引入“成组调度”机制(即云原生 PodGroup 模式)。系统将整个任务所需节点打包,严格执行“要么全部满足,要么一个不派”策略,从底层根绝因资源分配不全导致的算力内耗。
跨芯片的中立抽象与多轨调度
平台需向下抹平不同芯片驱动与运行时差异,向上支持主流模型免改代码运行。实践中,可通过建立“独占、共享、超分”三轨资源池:核心训练使用独占池保障稳定,高并发推理引入超分池榨取弹性,结合拓扑与负载动态分派。某大型政策性银行已借此架构在两地三中心的高合规要求下打通异构算力池。
从算“卡时”到算“Token”
当异构芯片被池化后,度量标准也随之变革。产业界正从粗放的“按卡时租机器”转向“按 Token 用量计费”。在 Agent 高频并发场景下,业务部门更关注任务吞吐、延迟及单次推理的 Token 成本,而非底层硬件规格。
范式通过 AI 网关引入“卡时+Token”双轨计量,向下摸清硬件消耗,向上精确度量模型服务产出。依托 HAMi vGPU 虚拟化技术,其 GPU 综合利用率从不足 30% 提升至 70%—90%,将离散算力转化为稳定的 Token 产能。2026 上半年,其 API 业务收入达 4.64 亿元,同比暴增 860.8%。
硬件参数见顶,挖掘软件红利
随着大模型研发竞赛降温,企业竞争转向落地深耕与智能体应用。盲目堆砌芯片规格的边际收益递减,驱动不匹配、架构不相容等隐性成本成为预算黑洞。
范式正从交付私有化软件向高效运转的“Token 工厂”转型,通过底层工程释放软件红利,激活沉睡的异构芯片。国际开源社区接纳中国底层调度标准以及 IDC 的评估结果均表明:拼硬件规格的时代已过,企业 AI 落地的关键在于利用优秀软件彻底盘活闲置算力。
声明:本文为 AI 前线原创,不代表平台观点,也不构成投资建议,未经许可禁止转载。