大数跨境

对话人大高瓴Gestalt团队:从「视觉+语言」到信息涌现,重新思考多模态智能

对话人大高瓴Gestalt团队:从「视觉+语言」到信息涌现,重新思考多模态智能 AI科技评论
2026-10-01
7
导读:当视觉、语言各自带着一半答案。
当视觉、语言各自带着一半答案。

    编辑丨吴思梦 岑峰


回顾多模态大模型发展历程,早期工作主要解决架构兼容问题,通过连接模块将视觉编码器接入预训练语言模型;随后,原生多模态模型开始联合预训练图像和文本,实现数据兼容。然而,现有研究虽将不同模态纳入统一框架,却较少关注多模态学习本身的信息交互特性和组织方式。
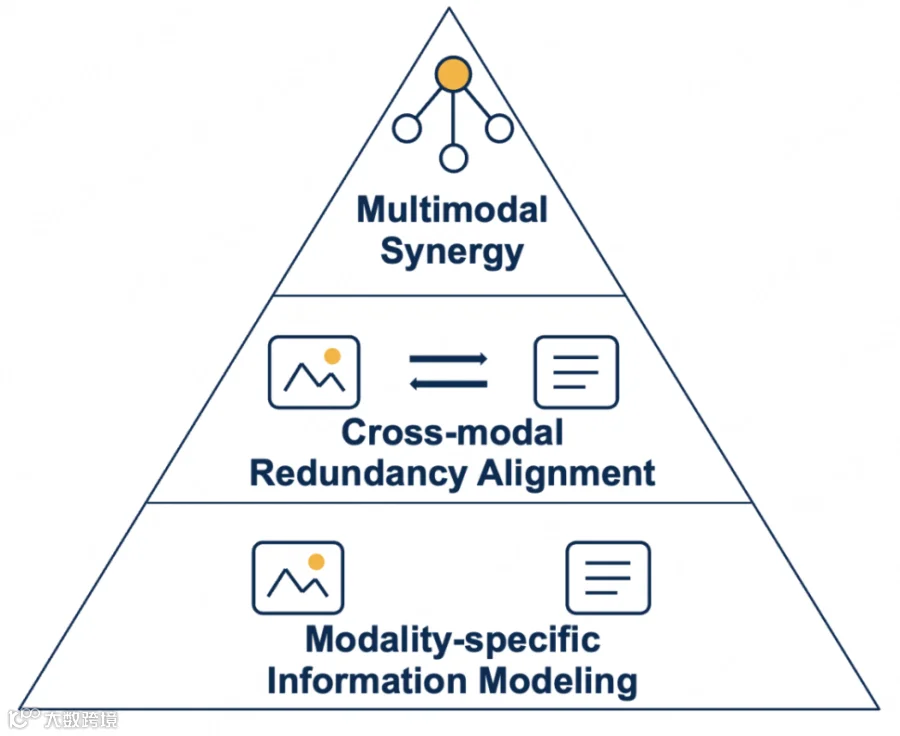
近日,中国人民大学高瓴人工智能学院GeWu-Lab、上海人工智能实验室、燧行科技AresoX等团队联合提出Gestalt。该研究围绕多模态场景特有的信息关系,提出“多模态信息交互金字塔”(Multimodal Interplay Pyramid),将学习过程组织为从单模态建模、跨模态对齐到多模态深层协同的递进结构,并据此设计模型架构、数据组织和训练流程。
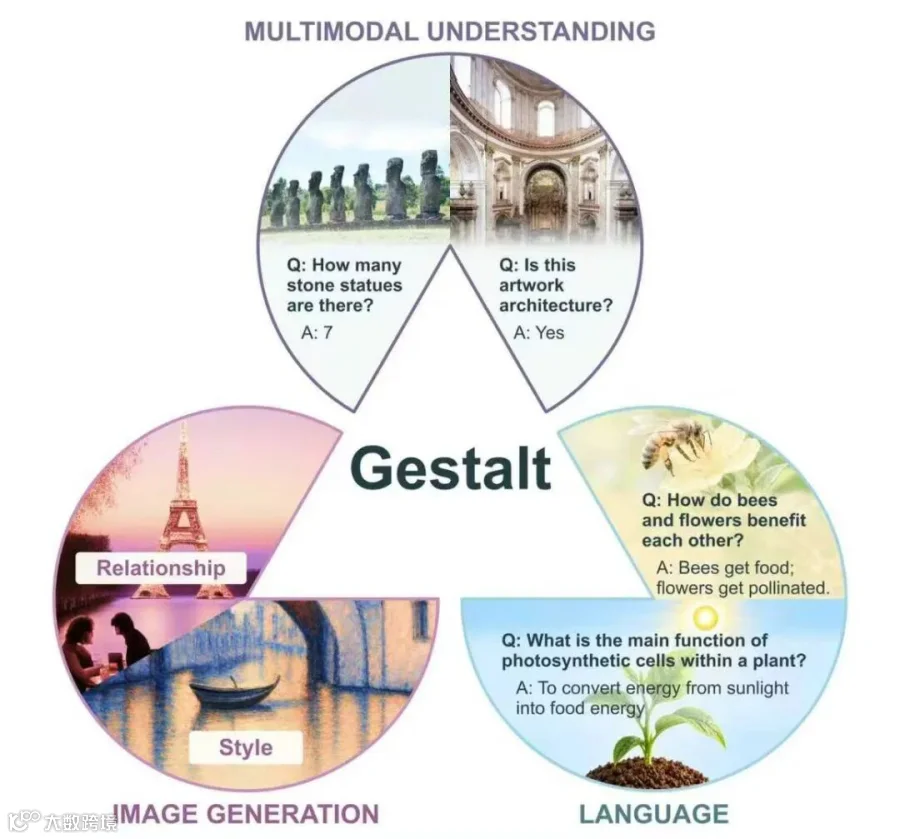
基于此构建的Gestalt在单一模型中统一支持图像生成、多模态理解和纯文本任务。实验显示,其在扩散式统一模型中表现领先,部分偏重视觉感知理解的任务甚至超越自回归模型,展现出巨大潜力。
图 1: Gestalt具备多模态理解、图像生成、文本理解等多方面任务的领先能力
项目主页:https://GeWu-Lab.github.io/Gestalt
技术报告:https://github.com/GeWu-Lab/Gestalt/blob/main/archive/Gestalt.pdf
模型权重:https://huggingface.co/GeWu-Lab/Gestalt

01


多模态信息交互金字塔

人类对外部世界的感知具有天然的多模态特性:不同感官信息先沿各自通路编码,再经多层级整合形成连贯表征。受此启发,团队提出“多模态信息交互金字塔”。该金字塔从下至上依次为:构建单一模态独有信息、对齐不同模态共享的冗余信息,以及整合多模态信息以获取单一模态无法提供的协同信息。
图 2: 多模态信息交互金字塔
图3展示了不同模态信息的交互形式:文本提供体型与项圈颜色的关系,图像提供可见的项圈颜色,两者结合建立跨模态对应,使模型能判断图中狗的体型。这种机制体现了从线索结合到逻辑判断的过程。
图 3: 不同模态信息交互形式样例展示

02


模型架构、数据组织与训练策略

Gestalt遵循多模态信息交互金字塔的递进方式,在架构上控制视觉与文本从受限交换走向充分交互,并按信息交互关系组织数据,逐步调整训练重点。
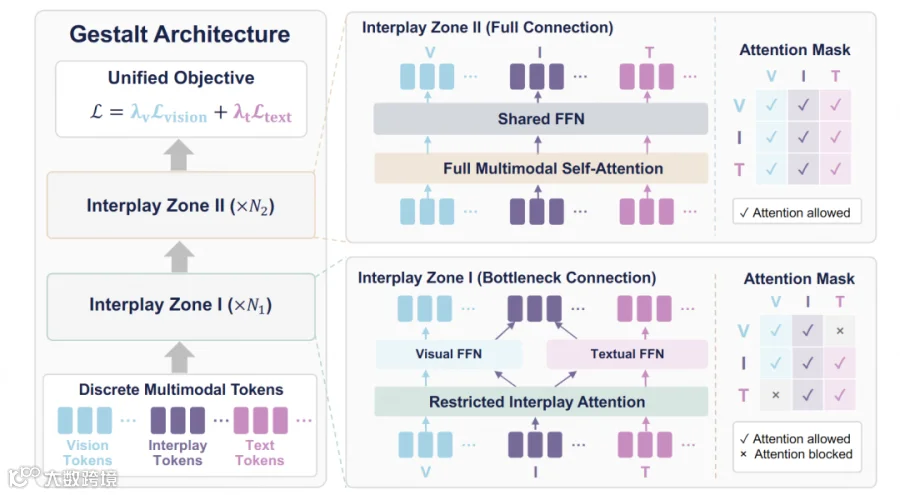
在模型架构上,Gestalt采用统一的离散扩散框架,将图像和文本置于同一编码字典,使用相同训练目标,从而同时支持多模态理解与图像生成。模型层被划分为两个阶段:Interplay Zone I采用受限注意力掩码和模态特定FFN,视觉与文本token通过可学习的interplay tokens间接传递信息;Interplay Zone II采用完整的多模态自注意力和共享FFN,对视觉、文本与interplay tokens进行联合建模。这种设计对应了从模态特定处理、跨模态对齐到多模态协同的递进路径。
图 4: Gestalt模型架构图
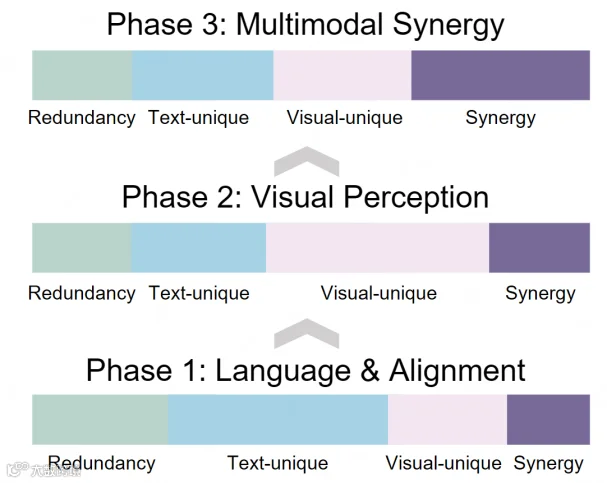
训练方面,Gestalt从跨模态对齐开始。首先使用7000万图文对进行联合多模态预训练,学习联合分布;随后使用800万图文对进行条件式持续预训练,分别学习图像到文本和文本到图像的条件依赖。监督微调阶段,1370万条指令数据被划分为冗余信息、文本独有信息、视觉独有信息和协同信息四类,并加入约246万条文生图数据以增强生成能力。
监督微调采用三阶段课程学习:第一阶段侧重语言能力和跨模态对齐,第二阶段提高视觉独有信息比例以加强视觉感知,第三阶段增加协同信息比重,推动更深度的多模态整合。
图 5: 训练阶段与数据组织

03


实验结果

评估涵盖细粒度图像生成、多模态理解、纯文本任务和内部表征多方面,以全面考察模型能力。
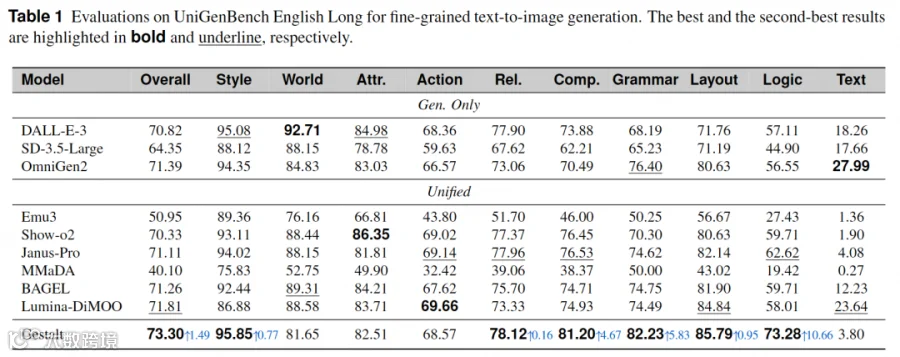
在图像生成方面,Gestalt在细粒度语义对齐和复杂指令遵循评测中均取得领先,能更准确处理属性、空间关系及组合关系等复杂约束。
表 1: UniGenBench上的生图评测结果
表 2: TIIF-Bench上的生图评测结果
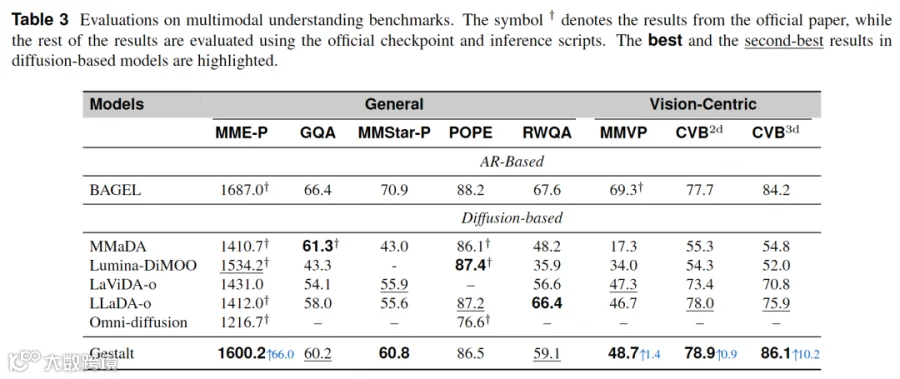
在多模态理解方面,Gestalt在偏重视觉感知的基准上优势明显,并在多项评测中领先其他离散扩散统一模型,甚至在视觉中心基准数据集中超过自回归架构对比模型。
表 3: 多模态理解基准上的评测结果
在语言能力方面,Gestalt在形成视觉—语言联合表示空间后,仍较好保留了预训练语言模型的表示结构,并在纯文本评测中取得领先的综合表现。
表 4: 文本理解基准上的评测结果
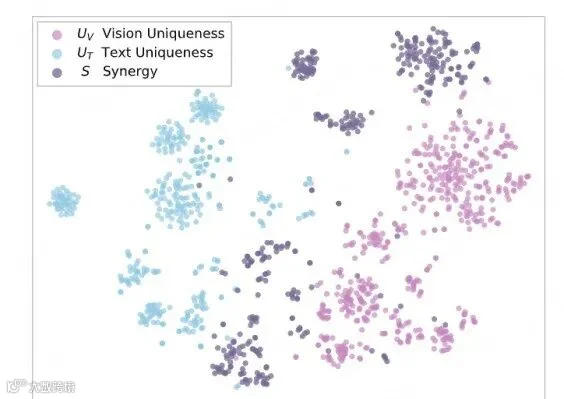
对interplay tokens的可视化显示,不同信息需求的任务样本形成了具有区分度的表示结构:主要依赖视觉或文本的样本分布在不同区域,需跨模态协同的样本则形成连接两者的独立分布,表明interplay tokens能反映任务对不同类型信息的依赖。
图 6: 不同类型交互分布分析

04


总述

Gestalt在统一的全离散扩散框架下,实现了图像生成、多模态理解与文本任务的统一建模。实验表明,多模态统一并不意味着底层必须共享全部计算;先保留各模态自身表征,再通过受控信息交换逐步实现深层整合,更有利于平衡单模态能力与跨模态协同。
已有研究表明多模态协同是能力提升关键,Gestalt提出的多模态信息交互金字塔从信息交互角度对此进行了初步探索。
项目讨论群:请发送邮件至gestalt_gewu@126.com,我们将邀请入群。

以下为AI 科技评论与Gestalt 团队对话实录:

▎AI 科技评论:第一个问题想从名字开始。模型为什么叫 Gestalt?

答:Gestalt(格式塔)源自认知心理学概念“整体大于部分之和”。正如三个缺角圆形能围出一个三角形,拿掉任一圆则三角形消失,多模态智能中的信息涌现也类似:异质模态交互涌现出新信息,缺任一模态都无法凑出完整结果。命名旨在致敬格式塔学派及其先驱意义。

▎AI 科技评论:你们是怎么认识到多模态信息交互的重要性的?

答:这是认识逐步加深的过程。前期研究多模态学习动态性时发现,不同模态在信息结构、学习速度和表达方式上存在差异。早期发展的平衡多模态学习方法MokA(NeurIPS 2025 Oral)即解决联合学习中的信息竞争与交互问题。由此意识到,多模态学习的关键在于产生有效的信息涌现,即跨模态信息的优质整合。

▎AI 科技评论:论文 Figure 1 里有一个大小狗的例子:文字告诉模型“大狗戴红项圈,小狗戴蓝项圈”,但图片里只有一只狗。模型必须把文字里的大小关系和图片里的颜色信息结合起来才能答对。这个例子是你们专门设计的吗?

答:该例子代表了一类普遍问题:同一任务中,图像提供场景和视觉事实,文本提供条件和关系。难点在于模型能否组织这些信息共同判断。这不仅是数据或参数规模问题,更是底层信息组织问题。我们关注的是模态进入同一模型后,信息如何根据任务需求主动调整交换方式。

▎AI 科技评论:现在的多模态模型已经可以看图、读文字、生成图像。你们所说的多模态智能,和现在常见的“视觉能力+语言能力”,最本质的区别是什么?

答:当前模型虽具备多模态能力,但过去工作多解决兼容性问题,即将视觉接入以语言为核心的模型。我们更关心多模态场景带来的新信息特性:有些信息仅来自图像或文字,有些必须结合两者才会出现。因此,模型需根据任务知道保留什么、交换什么及如何整合,这是一种从“支持多模态”到“基于多模态特性设计模型”的思路转变。

▎AI 科技评论:论文提出了“冗余、视觉独特、文本独特、协同”四类信息。为什么处在金字塔最上层的是协同信息?你们希望模型从这种协同信息里获得的,是一种新的推理能力,还是一种只有多种模态放在一起才会涌现的信息?

答:协同信息处于更高层,因其对跨模态整合要求更高。金字塔自底向上构建:先理解保留单模态信息,再建立对应共享,最后整合得到任何单模态都无法提供的新信息,即协同(synergy)。这被视为信息层面的涌现,强调对已有跨模态信息的有效组合,而非单纯的新推理能力。

▎AI 科技评论:论文里用了一个很有意思的说法,more is different。“模态更多”之后,到底会多出什么东西?有没有一个实验结果,让你们真正觉得这已经不是视觉能力和语言能力简单相加了?

答:More is different借用安德森名言,意指从单模态到多模态,信息间关系发生变化。多模态场景中,信息来源不同导致交互方式不同。实验中,视觉独特、文本独特和协同三类任务在interplay token表示空间形成明显不同结构,其中协同信息分布连接图像和文本分布。这表明多模态智能不仅是能力相加,更是组织和利用信息源关系带来新认识。

▎AI 科技评论:为什么不让视觉和文本从一开始就充分融合,而是先把它们分开,再通过 interplay token 进行交互?你们是不是认为,多模态模型的问题有时候不是“交流得不够多”,反而是“交流得太多”?

答:图像和文字属于不同域,若浅层完全共享参数和计算,模态特有信息可能在融合中被淡化。早期验证发现联合训练会出现模态竞争或偏好,导致特有信息未充分学习。因此Gestalt采用“先保留再整合”思路:Zone I中视觉和文本使用各自FFN,通过interplay token受控交换;Zone II放开限制,实现充分跨模态整合。关键在于把握跨模态交流的时机和方式。

▎AI 科技评论:你们把 Zone I 设置成前四层,又用了 32 个 interplay token。为什么最后是这两个数字?如果把四层改成十几层,或者把 32 个 token 换成更多、更少,会发生什么?

答:受控交换区层数决定单模态内部处理程度,即在保留和整合间平衡。实验发现限制前几层过早跨模态交换往往表现更好,对于LLaDA-based backbone,前四层是较合适选择。32个interplay token作为信息接口,需足够容量承载跨模态信息:太少通道过窄,太多则增加开销并削弱bottleneck意义。这是权衡信息保留、整合和bottleneck强度后的经验配置。

▎AI 科技评论:Figure 6 里有个很有意思的现象:不同任务下,interplay token 已经表现出了不同的交互模式。既然模型能够感知任务的信息需求,为什么前四层还要人为规定分开?未来能不能让模型自己决定什么时候交互、交互多少?

答:差异化交互通常出现在更深层。按照交互金字塔,前期需充分保留提取各自模态信息,再逐步进入深层整合。早期结构约束为避免过早融合削弱特有信息。Figure 6提示未来可让模型自行决定交互时机和方式。目前的固定分区是实现动态interplay前可控的起点。

▎AI 科技评论:PPT 里特别强调了一点,没有进行强化学习。为什么这件事值得被单独强调?你们觉得 RL 会成为 Gestalt 下一阶段值得探索的方向吗?如果加入 RL,你们最希望它解决什么问题?

答:强调无强化学习旨在说明结果源于模型架构、数据组织和渐进式训练本身,而非针对基准的行为优化。我们希望先回答基础问题:做好信息组织能使模型提升多少。RL是重要探索方向,未来希望借助RL让模型更主动学会何时跨模态交互、利用哪些信息,在复杂推理任务中逐步获取和使用信息,而非一次性组合。

▎AI 科技评论:到目前为止,Gestalt 还有什么问题是没有解决的?

答:Gestalt仍是初步探索,后续将探索三个方向:一是更系统地学习细粒度、结构化模态信息;二是进一步引导interplay token,使模型明确获取哪部分信息及何时定向交换;三是尝试在训练第一步原生建模多模态信息,而非在单模态基座上适配,以实现更自然的跨模态交互。核心是让模型更稳定、有结构地获取和组织信息。

▎AI 科技评论:最后一个问题稍微大胆一点。如果三年以后回头看,发现“按需组织不同模态之间的信息交换”这条路并不是正确答案,你们觉得最可能错在哪里?是我们对多模态智能的理解错了,还是现在这套架构只是一个过渡?

答:Gestalt架构并非最终答案,而是将多模态信息组织问题显式化的起点。真实多模态智能可能更复杂,需要更动态、细粒度的信息路由,或随规模扩大由模型自行学习结构。这套架构可能是过渡,但我们更关心其背后问题:除规模外,不同模态间信息的组织和交换是否也是多模态scaling的重要维度。
【声明】内容源于网络
0
0
AI科技评论
聚焦AI前沿研究,关注AI工程落地。
内容 8980
粉丝 0
AI科技评论 聚焦AI前沿研究,关注AI工程落地。
总阅读260.0k
粉丝0
内容9.0k