大数跨境

刚刚,Gemini 4 正式发布,追平 GPT-6 但被质疑「刷榜」,官方辟谣

刚刚,Gemini 4 正式发布,追平 GPT-6 但被质疑「刷榜」,官方辟谣 APPSO
2026-10-01
7
导读:Gemini 最强成绩单,但…
当前 AI 行业竞争已进入白热化阶段。以往 OpenAI 与 Anthropic 约每 10 周发布一次新模型的节奏,如今已被压缩至每 11 天一次。
在此背景下,谷歌 DeepMind 正式推出 Gemini 4 Argon(氩),试图在激烈的模型迭代战中占据一席之地。

Gemini 4 Argon 发布策略与核心性能
Argon 并未采取全面开放策略,而是通过「Fairwind 计划」优先向受信任的网络安全防御者提供,并正在参与美国政府的自愿性发布前模型准入流程。后续将逐步向付费 API 客户和 Google AI Ultra 订阅用户开放。
官方定位 Argon 为在软件工程、金融法律及网络安全领域具备前沿性能的模型。其核心升级在于将输出窗口限制从 6.4 万 Token 提升至 100 万 Token,支持长篇幅代码生成与深度分析。定价方面,输入每百万 Token 2 美元,输出 10 美元,缓存命中时输入端享受大幅折扣。

内部应用成果显著

据官方披露,Argon 已在谷歌内部多个硬核工程场景中落地:
  • 量子算法优化:协助研究员优化子程序,部分案例性能超越基线 40%;
  • 数据中心内存优化:自动识别并应用优化策略,已释放超 300 TiB 内存;
  • 大规模代码迁移:协助将 C/C++ 代码库迁移至 Rust,涵盖从核心库到 Fuchsia 操作系统内核的大规模代码重构。
在 libgav1 视频解码库案例中,Argon 替换了 3.2 万行 SIMD 代码,生成的内存安全解码器性能逼近手工优化的 C++ 版本。

基准测试表现亮眼

在多项权威基准测试中,Argon 取得优异成绩:
  • DeepSWE v1.1 长线软件工程基准得分 77.9%,刷新纪录;
  • Vals Index 经济价值衡量中,在金融、编程、法律和税务领域全面领跑;
  • Zapier AutomationBench 端到端业务执行基准排名第一(51.3%);
  • LVBench 长视频理解基准得分高达 91.7%。

网络安全防御能力增强

Argon 在安全领域表现突出,通过与 Wiz 合作,在医疗软件中发现以往模型未察觉的高危漏洞。在 CWE-bench v1 漏洞修复评估中并列第一,并在 Gray Swan 间接提示词注入基准中获得行业最高分。

争议与挑战:高分低能还是舆论误导?

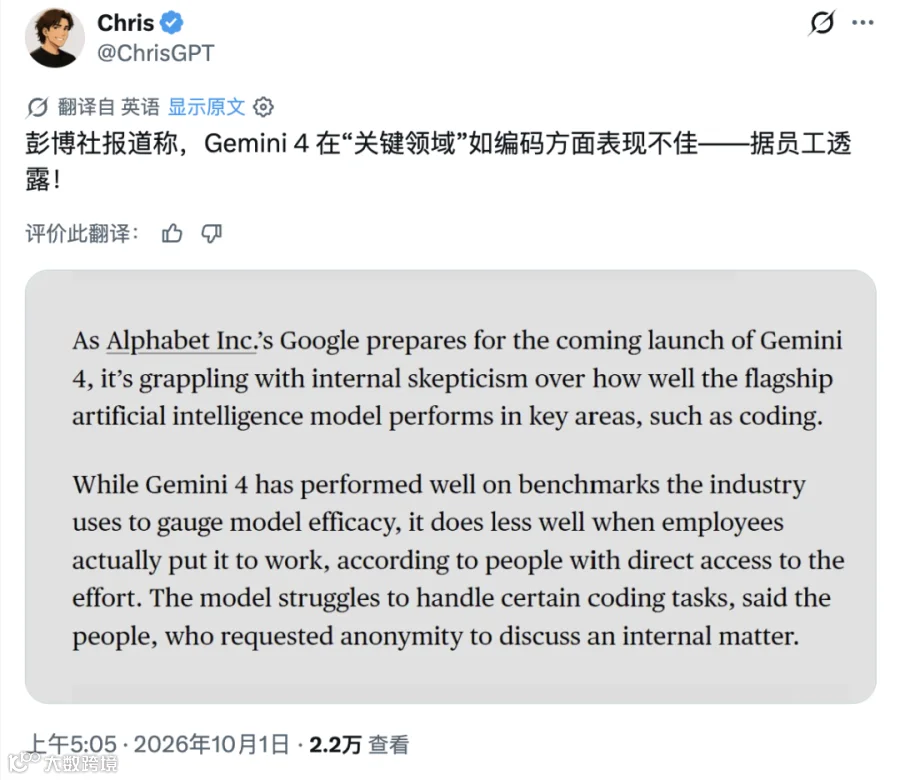
尽管官方宣传强势,彭博社报道指出,部分谷歌员工反映 Argon 在实际业务代码编写,尤其是前端设计方面表现不佳,存在“基准测试分数高但实战能力弱”的现象,即所谓的“Benchmaxxing”。
内部对此存在分歧:部分员工认为竞争对手进步更快,Argon 面临被动局面;另一派核心员工则否认相关说法,强调模型处于行业前沿。DeepMind 负责人 Koray Kavukcuoglu 表示对团队保持绝对信任,谷歌发言人也驳斥了关于编程能力不佳的报道。

谷歌 AI 的战略焦虑与未来变数

回顾过去一年,谷歌 AI 战略经历多次调整,从 Gemini 3 到跳票的 Gemini 3.5 Pro,再到侧重 Flash 模型,显示出一定的摇摆。同时,Jeff Dean、Noam Shazeer 等核心人才相继离职,Demis Hassabis 转任董事长,管理层变动加剧了外界对内耗的担忧。
尽管拥有搜索、地图、Gmail 等十亿级用户产品的生态护城河,谷歌正面临来自 Meta Muse、OpenAI Dots 等个人智能体(Personal Agent)的直接挑战。这类应用改变了用户获取信息的方式,可能削弱谷歌传统的搜索分发优势。
Argon 之名源自希腊语,意为“不工作、懒惰”,且氩气化学性质稳定、不参与反应。这一命名或许隐喻了当前的困境:若巨头沉溺于内部争论与应试刷榜,而忽视实际应用场景的快速迭代,其流量帝国可能在不知不觉中受到侵蚀。
【声明】内容源于网络
0
0
APPSO
AI第一新媒体,「超级个体」的灵感指南。 #AIGC #智能设备 #独特应用 #Generative Al
内容 15787
粉丝 0
APPSO AI第一新媒体,「超级个体」的灵感指南。 #AIGC #智能设备 #独特应用 #Generative Al
总阅读472.0k
粉丝0
内容15.8k