

一家中国AI公司计划利用欧洲用户的公开数据训练模型。法务团队评估认为,去除姓名和邮箱后的数据属于匿名数据,不受GDPR管辖。然而,欧洲合作方指出:“在我们手中算匿名,在你们手中可能不算。”
这一判断差异如今有了更系统的官方依据。2026年7月7日,欧洲数据保护委员会(EDPB)通过《匿名化指南》草案,并于次日开启公众咨询,截止至2026年10月30日。这是欧盟十多年来首次系统性更新“数据匿名性”判定规则,拟取代2014年发布的WP216意见。
对于中国出海企业而言,该指南直接关乎核心合规问题:手中的欧盟用户数据是否受GDPR管辖。若被认定为匿名数据,则不适用GDPR关于数据主体权利、跨境传输限制及数据保护影响评估等要求;反之,则需履行相应义务。

AI训练数据库示意|图源:法国数据保护机构CNIL
匿名化与假名化的本质区别
许多企业常混淆这两个概念。
假名化是指将姓名替换为编号等标识符,但保留可随时还原的“映射表”。对于掌握映射表的控制者而言,此类数据仍受GDPR管辖。
匿名化则是使相关主体在合理可能的手段下,识别个人的可能性降至可忽略水平。对此类数据,不适用GDPR。
EDPB新指南明确否定了“去掉姓名即匿名”的传统认知,强调同一份数据对不同主体可能具有不同属性。判断标准并非数据内容本身,而是从适用视角看,能否通过合理手段识别特定个人。

核心变革:从“看数据”转向“看场景”
此次修订的根本转向在于引入场景化评估框架。
以往企业多仅对数据集进行抽象评估。新指南提出的判断框架涵盖:给定数据 + 相关主体 + 适用视角 + 合理可用的识别手段 + 处理目的 + 时间条件。
在评估“可识别性”前,需首先确认信息是否关联到(relate to)自然人。这依据内容、目的和效果三个维度判断。即使数据不含姓名,若其处理目的或效果指向具体可识别个人,仍构成个人数据。
此外,指南特别强调了角色视角的重要性:若实体作为处理者代表控制者处理数据,匿名性应从控制者的视角评估,处理者自身缺乏识别能力不改变结论。例如,中国生物医药企业将临床数据传予欧洲CRO(作为处理者),应从控制者视角评估;但若传给作为独立控制的大型科技公司,则需从该独立实体视角另行评估。
这意味着,企业在设计数据传输方案时,不仅要看“数据形态”,更要审视“接收方身份及其角色”。
匿名化认定的“三无”测试标准
新指南细化了源自WP216的三项测试标准。数据在适用视角下同时满足以下三点,方可认定为匿名:
1. 无记录隔离:数据中不存在独特的属性组合能将个人单独“拎出”。例如,“35岁+某小镇+兽医”若仅对应一人,则该记录可被隔离,不满足匿名要求。
2. 无联结:记录无法与其他数据集链接以识别个人。即使单方数据无法识别,若结合外部数据交叉验证后可锁定具体人员,则不算匿名。

不同公开信息可能被交叉关联|图源:CNIL
3. 无推断:不能从数据中对可识别个体作出具体、有意义的推断。指南特别指出,推断风险不仅来自单条记录,也可能源自聚合数据、统计输出、AI模型和合成数据集。因此,用于AI训练的数据即便经过处理,仍可能因推断风险被视为个人数据。
若任何一项未通过,需进一步分析,但仍可能得出匿名结论;指南提供了情境化和简化两种评估路径供企业选择。
对中国出海企业的实际影响
1. 既有评估无需全面重做,但建议定期复查
草案说明,此前依据WP216认定为匿名的数据集,不强制因新指南发布而重新评估。但这不免除既往违法责任,指南建议建立定期复查机制作为良好实践。

云端数据处理与再利用示意|图源:CNIL
2. 接收方识别能力成为合规关键变量
3. 匿名性判断具有时效性

4. 匿名化操作本身需具备法律依据
指南明确,“匿名化”动作本身属于对个人数据的“处理”,需具备GDPR第6条的法律依据;涉及特殊类别数据还需符合第9(2)条例外。企业不可默认“匿名化即免管”,执行前须确认合法性。
务实合规建议
1. 对照“三无”标准自查现有数据
虽不强制重评,但建议涉欧业务企业对照新指南自查。重点排查是否存在可被隔离的独特属性组合,以及接收方是否具备联结或推断能力。
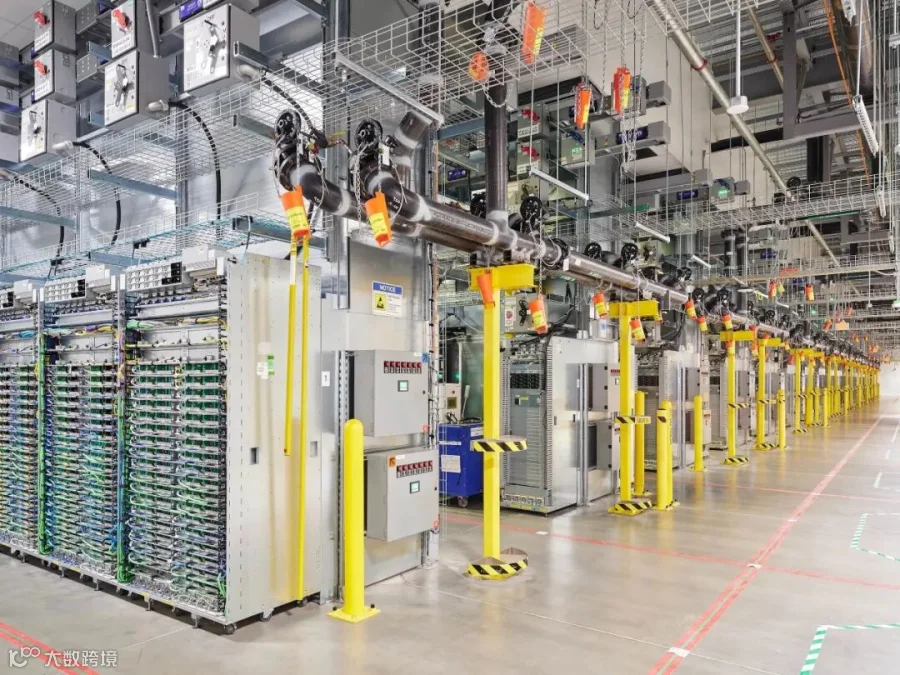
Google美国New Albany数据中心服务器|图源:Google
2. 将“接收方评估”纳入数据共享流程
在数据出入境环节,不仅评估数据本身,还需评估接收方的技术资源、潜在识别手段及其法律角色(控制者/处理者)。
3. 确保匿名化操作的法律基础
执行匿名化前,务必确认拥有GDPR第6条下的合法处理依据;若涉及敏感数据,需确认符合第9(2)条例外情形。
4. 完整文档化判断依据
鉴于判断过程趋于复杂场景化,企业需系统性保存匿名化评估记录,证明在特定场景和接收方条件下,数据确实满足“三无”标准。匿名化是合规路径而非捷径,误把假名化当匿名化可能导致更严重的法律后果。