


先说一个你大概率有共鸣的场景。
早上九点,运营群甩来一条消息:“亚马逊出新的入库政策了,大家看了吗?”
你的第一反应不是去看公告,是心里咯噔一下:什么时候发的?我怎么不知道?
然后开始翻公告、翻AMZ123、翻雨果网、翻公众号、翻Reddit……四十分钟过去,政策原文没找到,倒是顺手刷了三条选品帖和两个卖家的吐槽贴。
这就是亚马逊运营的日常信息战。要盯的信源越来越多——官方公告、Helium 10 和 Jungle Scout 的工具博客、SellerSprite、Reddit 卖家社区,国内的 AMZ123、雨果网、知无不言……掰指头数,一个合格的运营至少得盯 8 个信源,每个每天几十上百条更新。
两个痛点,都很真实。
一,怕错过。FBA 费率、合规红线、广告政策,哪条漏了都可能直接掉钱。二,刷了也白刷。每天一两个小时刷下来,真正影响决策的可能就三五条,其余全是噪声、旧闻翻炒和标题党。
我们算过一笔账:一个运营每天花 90 分钟刷资讯,一个月就是 45 个小时——大半个工作周,全花在“怕错过”上。
后来我们基于开源框架 AIHOT,搭了一套“热点自动追踪 + 日报生成”系统,专门给亚马逊卖家、运营和创业者用,跑了一阵子。今天这篇就把它拆开讲讲:怎么让机器替你读完全网,你只看每天早上的那一页。
01
一座全自动的“AI编辑部”
这套系统的本质,用一句话说清:给团队配了一个不吃不睡、还不要工资的编辑部。
爬虫是实习生,每 15-60 分钟跑一轮,把 8 个信源全部通读一遍,一条不落。预筛和评分是两轮审稿编辑,每条内容打 0-100 分,两轮独立打,都过关才放行。聚簇是主编,同一事件的多篇报道自动合并,不给你重复喂五遍。热度排序负责排版,影响面大的上头版。
每天早上 8 点,报纸送到桌上:日报自动生成,最要紧的几条直接推送到飞书群。
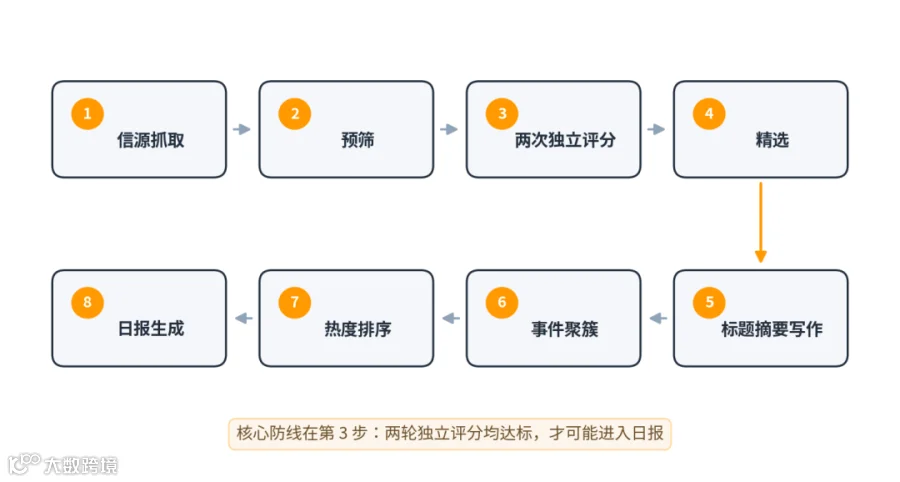
▲ 系统八步工作流:从信源抓取到日报生成,全程无人工干预
八个步骤里,最值钱的是第 3 步。
02
灵魂设计:两次独立评分,把标题党挡在门外
为什么是两次独立评分?因为单次 AI 评分有偏差——同一篇文章,换个问法打分,结果可能差出 10 分。让两个“编辑”背对背独立打分,都给高分的才算真材实料。这是用冗余换确定性。
五个评分维度,翻译成人话:
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
效果就是一层层漏斗:
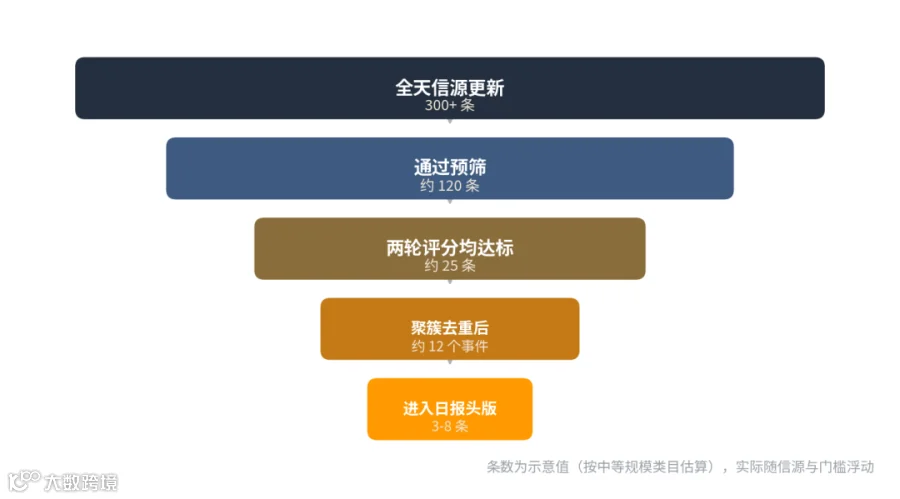
▲ 每天几百条更新,最后只有几条能站上日报头版
还有一层“事件聚簇”值得单独说:同一个政策更新,官方公告一篇、AMZ123 一篇、雨果网一篇、Reddit 讨论两帖——系统用向量召回把这些归并成一个事件。你看到的永远是“一件事”,不是“五条重复新闻”。
03
案例走查:一条 FBA 公告的 24 小时
拿一个示意场景,按系统真实的工作流走一遍(事件为推演,流程为实际)。
上午 10:00,亚马逊发布 FBA 入库政策调整公告。10:30,抓取轮次跑到,公告入库。10:35,预筛通过——信源是官方公告,可信度顶格,类目相关。10:40,两轮独立评分完成:第一轮 86,第二轮 84,均高于门槛,进精选池。
下午,AMZ123、雨果网、Reddit 陆续跟进 5 篇报道。18:00,聚簇模块把 6 篇内容归并为同一事件,热度排序进入当日 Top3。次日 08:00,日报生成,这条事件带着中文标题、摘要和原文链接出现在头版,同时推到飞书群。

▲ 从公告发布到躺进你的飞书,全程无人值守
对照一下人肉模式:公告发布时你正在调广告,中午刷手机划过去了,晚上带娃没看群,第三天从同行嘴里听说——信息差就这样产生了。
而在这套系统里,运营到公司打开飞书,重点已经躺在那了。看或不看,它都在——但你大概率会看,因为一天就这一页。
04
落地与边界
怎么用,一句话就能说清:每天 08:00 出日报,周一自动出周报,每月 1 日出月报。内容按类目组织——选品、关键词、Listing、广告、FBA、合规、利润,缺哪块看哪块。
还有一个被低估的功能:全文检索。三个月后想找回“那条政策”,搜一下就能定位,不用翻聊天记录、翻收藏夹。
对技术同学多说一句,整套系统的地基很朴素:
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
边界也要说明白,不吹神话。
AI 评分挡得住标题党,挡不住“重要但枯燥”的低调公告——评分门槛要按自己的类目微调。摘要再好也会丢细节,涉及钱和合规的决策,一定点回原文链接确认。还有最重要的一条:系统解决的是“读到”,不解决“读懂”——判断这条政策对自己店铺意味着什么,仍然是人的活。
回到开头那笔账:每天 90 分钟的刷资讯时间,现在变成早上 8 点的 5 分钟。
工具换不来判断力,但能把判断力从信息噪声里捞出来,用在真正需要它的地方。
信息过载的时代,运营的优势不是读得更多,
是漏得更少。
让机器博览群书,人只负责深读那几页。
你每天花多少时间刷行业资讯?评论区聊聊。
— 觉得有用,转发给你正在刷手机的运营搭子 —