

Google DeepMind 今天发布了新前沿模型 Gemini 4 Argon。Logan Kilpatrick 发推宣布,模型先向网络防御者开放,之后逐步推广。
这是 Google 七个多月以来第一个超越 Flash 级别的自研模型。
定价分两档。介绍期优惠:$2/百万输入 token,$10/百万输出 token,缓存输入再打 95% 折。介绍期结束后恢复到 $4/$20。在当前市场里,这个促销价相当激进。
先说成绩单。
DeepSWE v1.1 软件工程 77.9%,超过 GPT-6 Astra 的 74.1%。Vals Index 68.9%,首次登顶。LVBench 长视频理解 91.7%。
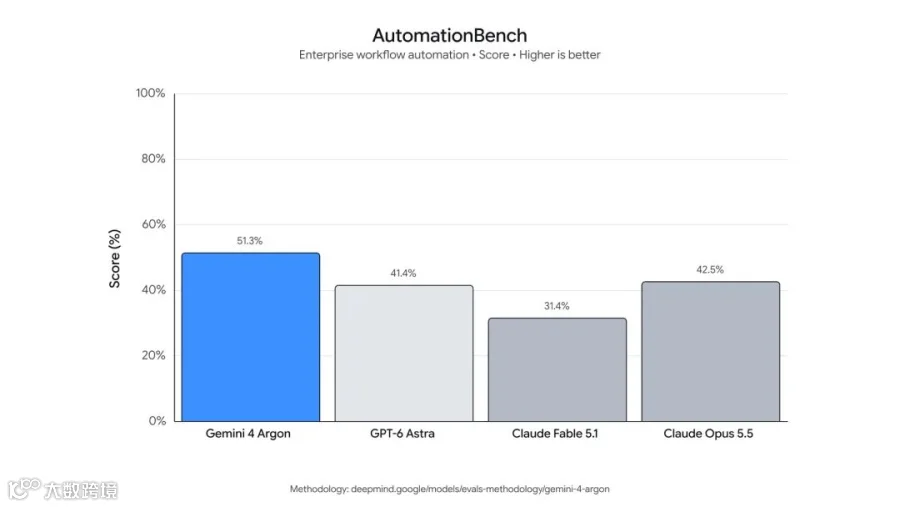
企业工作流自动化基准 AutomationBench,Argon 得分 51.3%,比第二名 Claude Opus 5.5 高出约 9 个百分点。


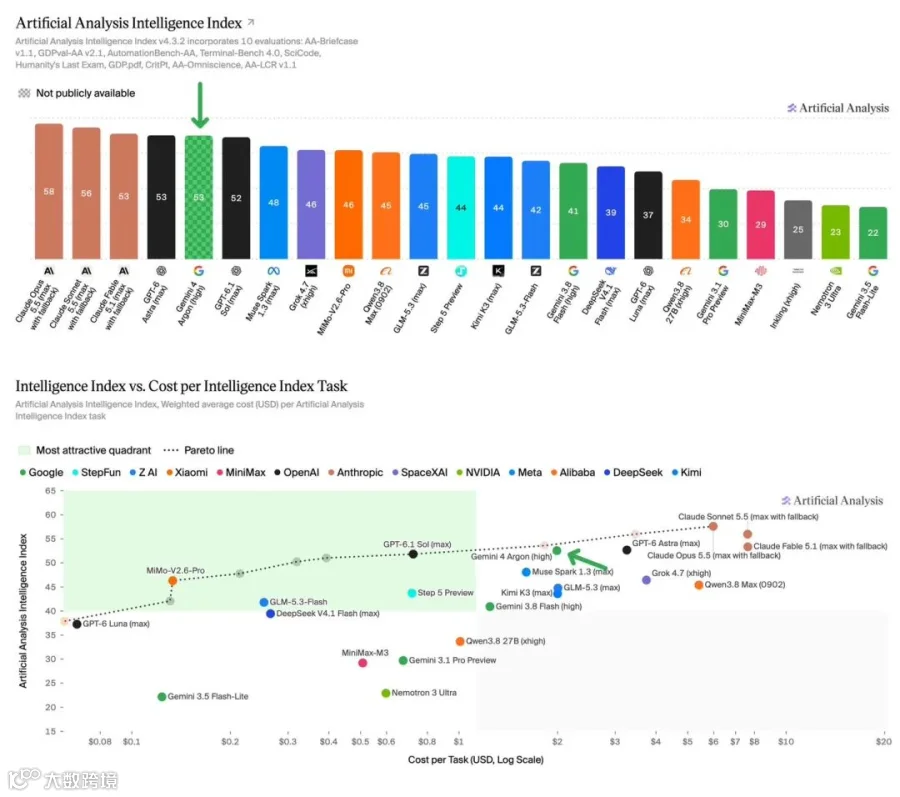
独立评测机构 Artificial Analysis 也放出了结果。Gemini 4 Argon 在 Artificial Analysis Intelligence Index 上得分 53,追平 GPT-6 Astra(max,53),领先 GPT-6.1 Sol(max,52)1 分。这个分数比 Google 上一个非 Flash 模型 Gemini 3.1 Pro Preview 高出 23 分。

这一代最实质的变化是输出 token 上限从 64K 提到 1M。上下文窗口同样是 1M,多模态能力保留。官方说模型能在单次推理里生成几十万 token,做长程任务不用中途断开。
但这里有第一个值得注意的数据。Artificial Analysis 测出来,Argon 每个 Intelligence Index 任务平均输出 62K token,而 GPT-6 Astra 只有 27K。也就是说,Argon 跑一个任务吐的 token 是 Astra 的两倍多。这部分解释了为什么促销价能做到那么低——不是模型本身特别省 token,纯粹是单价补贴。
用促销价算,每任务成本 $1.99,是 GPT-6 Astra($3.26)的 60%。但促销结束后涨到 $3.98,反而比 Astra 贵约 1.2 倍。


幻觉率是 Argon 最突出的亮点。在 AA-Omniscience 评测中,Argon 幻觉率 15%,是同级别模型里最低的。GPT-6 Astra 是 51%,GPT-6.1 Sol 是 54%。这意味着 Argon 不懂的时候更倾向于说"我不知道",而不是胡编一个答案。准确率方面,Argon 为 50%,比 Gemini 3.1 Pro Preview 低 5 个百分点,比 GPT-6 Astra 低 13 个百分点。但由于幻觉率极低,整体 AA-Omniscience 评分 42,仍然与 Astra(43)和 Sol(42)持平。
Agent 能力是 Gemini 系列的历史弱项,但这次有明显改善。AutomationBench-AA 上 Argon 排第一,77.5%,领先 Claude Sonnet 5.5(max,71.3%)6 个百分点。Terminal Bench 4 得分 57%,相比 Gemini 3.1 Pro Preview 提升了 53 个百分点,排在 Claude Sonnet 5.5(64%)、Claude Opus 5.5(60%)和 GPT-6 Astra(59%)之后。AA-Briefcase 获 1494 Elo,其中 rubric 通过率 65% 是 Artificial Analysis 录得的最高纪录,但分析质量(1576 Elo)和展示质量(1308 Elo)偏低。


Vals AI 在 22 个基准里跑了 Argon,20 个进入前五。IOI 2024/2025/2026 全部满分,只有 GPT-6 Astra 也做到了。Vibe Code Bench 上完美构建 30 个应用,比 Claude Opus 5 的 25 个和 GPT-6 Astra 的 24 个都多。

Google 内部已经在用 Argon 干活了。量子计算团队用它优化子程序的时空资源,几分钟内把已发表基线提升了 40%。一组代理分析数据中心遥测数据,自主实施内存优化,释放了 300+ TiB 内存,预计总节省可达 500 TiB 到 1 PiB。代码迁移方面,Argon 代理正在把 C/C++ 迁移到 Rust,范围从 re2、libgav1 的几万行到 Fuchsia Zircon 内核的 80 万行。libgav1 的 Rust 移植里,Argon 用 profile-guided 实验替换了 32K 行 SIMD 代码,最终解码器比原 Rust 版快 2.7 倍。
网络安全是这次发布的核心叙事。Argon 被训练成能自主发现、验证和修补漏洞。它首先通过 Fairwind Program 交给可信网络防御者使用。Wiz 已经在 Scan for Good 计划里用它发现了一个影响全球医院软件的高危漏洞,之前的前沿模型都没识别出来。漏洞修复基准 CWE-bench v1 上得分 68%,并列第一。
安全机制方面,Google 列了四项:拒绝恶意请求、抵抗间接提示注入、监控模型是否越界、加固沙箱环境。这些不新鲜,但 Google 声称 Argon 是"最具鲁棒性"的一代。
获取顺序:先给防御者,然后逐步扩展到开发者、企业和消费者。付费 API 和 AI Ultra 订阅用户会先用到。
纸面数据好看到让一些人不信。但几个细节值得留意。第一,Argon 靠的是大量输出 token 来完成任务,而不是效率更高。促销价掩盖了这一点。第二,幻觉率低是因为它更谨慎,宁可不说也不瞎说,代价是准确率下降。这在某些场景是优点(你不会想要一个爱编造答案的安全工具),在另一些场景可能是缺点。第三,先给防御者再给普通用户这个顺序,说明安全是这次发布的主线,不是附属品。
基准终归是基准。等模型真正开放,跑一些实际任务再来看看是不是真功夫。
关注公众号回复“进群”入群讨论