


发表平台:bioRxiv(预印本26-06-25)
研究领域:AI 虚拟细胞 / 单细胞基础模型 / 细胞状态表征 / 扰动响应预测
ML/DL方法:Causal Transformer + LLM-JEPA(Joint-Embedding Predictive Architecture)+ Dense-to-MoE(Mixture-of-Experts)
文章创新:
提出多视角单细胞基础模型 CellOS:同一个细胞同时构造 Expression View(表达视角)和 Perception View(感知视角),不再只依赖单一的表达量排序。
通过 population-relative surprisal显式衡量某个基因表达在全体细胞背景下是否异常,使中等表达但状态特异的转录因子、信号基因和应激基因更容易被模型捕获。
首次将 JEPA 的潜空间预测引入单细胞转录组,在 cell embedding 层面预测并对齐两个视角。
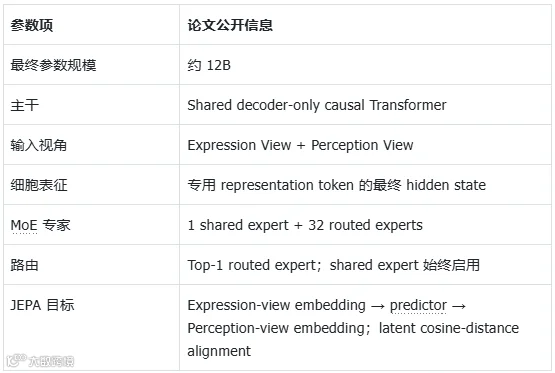
采用三阶段 Dense-to-MoE 扩容策略,将已收敛的 Dense 模型平滑扩展到约 12B 参数;MoE 中包含 1 个共享专家和 32 个路由专家,使用 Top-1 路由。
1
研究背景
单细胞基础模型近年来快速扩展。Geneformer、scGPT、scFoundation、UCE、TranscriptFormer、C2S 等模型通常将单细胞表达谱编码为离散 token、表达区间或按表达量排序的“cell sentence”,再通过掩码建模或自回归预测学习可迁移的细胞表示。这类方法已经证明,大规模单细胞图谱可以提供类似语言语料的预训练信号。
但 CellOS 认为,仅根据这个细胞里的基因表达量水平仍然会丢失一类重要信息:表达量高不等于信息量高。一个 housekeeping gene 可能在绝大多数细胞中都很高,而一个表达量并不极高的转录因子,如果只在少数状态中被显著激活,反而更能区分细胞身份、应激状态或扰动响应。
因此,CellOS 不把细胞只看成一条表达排序序列,而是把同一转录组解释成两个互补视角:Expression View 回答这个细胞主要表达什么,Perception View 回答相对于整个预训练群体,这个表达事件有多不寻常、多有信息。随后模型不在输入空间强迫两种排序一致,而是在潜在表示空间中学习它们共有的细胞状态信息。
这一思路使 CellOS 的world model定位与 Lingshu-Cell、STATE 等模型有所不同:CellOS 的重点首先是学习更强、更稳定的 cell-state representation,而不是直接从扰动条件生成完整的扰动后转录组。论文中的扰动实验使用统一的 STATE transition framework,仅替换不同基础模型产生的 embedding,以检验表征是否包含有利于状态转移预测的信息。
2
算法结构

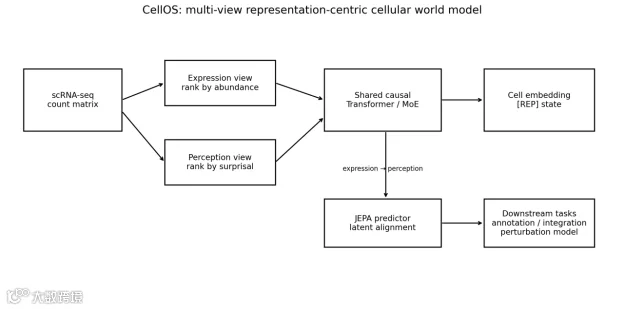
CellOS 的核心由四部分构成:cell-sentence 构建、双视角单细胞表示、共享的 causal Transformer / MoE 主干,以及 LLM-JEPA 潜空间对齐。整个模型先学习表达视角下的细胞语言,再通过 MoE 扩容,最后引入感知视角,使最终 cell embedding 同时保留表达丰度和群体相对信息。
1.单细胞预处理与 Gene Vocabulary
模型以原始单细胞 RNA-seq count matrix 为输入。来自不同研究和基因注释体系的数据首先被统一到共享的 gene-symbol namespace;映射到同一 canonical gene 的符号会在单细胞内合并计数,无法解析到共享基因词表的条目被排除。随后进行 library-size normalization,使不同测序深度的细胞可以在相近尺度上比较。
CellOS 不把完整数值向量直接输入 Transformer,而是把每个保留基因视为一个离散 gene token。对每个细胞,表达值被转换为基因排序序列,并加入专用 representation token;该 token 最终的隐藏状态被用作细胞级 embedding。
2.Expression View:表达量排序的 Cell Sentence
Expression View 是 CellOS 的基础视角。对每个细胞,将检测到的基因按照标准化表达量从高到低排序,得到类似“Gene A → Gene B → Gene C …”的 cell sentence。共享 causal Transformer 通过自回归 next-token prediction 学习:在一个细胞的高表达基因上下文中,哪些基因经常共同出现、哪些表达程序与特定谱系或状态相联系。
这一阶段的目标与传统语言模型相似。它为后续 JEPA 对齐提供一个稳定的基础生成目标,并在 Stage 2 和 Stage 3 中继续保留。
3.Perception View:基于 population-relative surprisal 的信息排序

Perception View 是 CellOS 最具辨识度的设计。对于每个基因,模型先在整个预训练语料中统计该基因非零标准化表达的经验分布,并用基因特异的 empirical quantile 描述一个表达值位于该基因全局分布的什么位置。
对于每个基因 g,CellOS 根据预训练数据集中观测到的该基因的非零标准化表达值,估计一个经验分位数函数(empirical quantile function)。对于给定的细胞 c,基因 g 在该细胞中的标准化表达值 ecg 会被映射为一个基因特异性的经验分位数:qg(ecg)。随后,将感知信息得分(perception information score)定义为上尾分位数惊异度(upper-tail quantile surprisal):

其中,ε是一个很小的数值常数,用于保证计算的数值稳定性。
如果某个基因在一个细胞中的表达落在自身全局分布的高尾部,即使它不是该细胞绝对表达量最高的基因,也会获得较高的 population-relative information content。模型再按照这一信息分数重新排序基因,得到第二条 cell sentence。
因此,两种视角的差别可以概括为:Expression View 强调丰度,Perception View 强调相对罕见性/信息量。作者认为,细粒度 T 细胞状态、瞬时激活、转录因子程序和扰动响应常常更接近第二种信号。
4.Causal Transformer 与 Cell Representation
Expression View 和 Perception View 由同一个 decoder-only causal Transformer 处理。模型对 gene token 使用因果注意力,同时在每条 cell sentence 中放置专用 representation token,其最终 hidden state 作为细胞级表示。这样的 shared backbone 使两个视角被投影到同一个表示空间。
5.LLM-JEPA:在潜空间预测另一个视角

CellOS 不尝试让 Expression View 在 token 层面重建 Perception View,因为两种序列本来就采用不同的排序标准。相反,模型先分别计算两个视角的 cell embedding,再用 predictor network 将 Expression View 的 embedding 映射到 Perception View 的潜空间,并使用 cosine-distance 类型的目标进行对齐。
这一设计的目标是找出在两个视角下都稳定存在的细胞状态语义。换句话说,JEPA 关注的是 latent state 是否一致,而不是输入 token 是否逐位一致。这也是 CellOS 从 reconstruction-centric learning 转向 representation-centric learning 的关键。
6.Dense-to-MoE:从稠密模型平滑扩容到 12B

在 Stage 1 的 Dense 模型收敛后,CellOS 将部分 feed-forward 子层替换为 MoE。每个 MoE 层包含 1 个 shared expert 与 32 个 routed experts;对于每个 token,router 使用 Top-1 机制选择一个路由专家,而 shared expert 始终参与计算。
为了避免直接扩容造成模型行为突变,shared expert 从原 Dense feed-forward 权重初始化,新增 routed experts 以接近零的方式初始化,router 则接近均匀初始化。这样在刚完成转换时,模型尽可能保持原 Dense 模型的函数行为,然后再通过 continued pretraining 让不同专家逐步形成条件化分工。
关键结构参数
训练数据与三阶段预训练

预印本报告的预训练语料包含 390,472,902 个单细胞转录组,来自 47,845 个测序样本,其中约 3.46 亿个细胞带有 cell-level annotations。作者同时设计 token-balanced data engine,按估计 token load 对分布式训练数据进行划分,以减少不同细胞句长造成的训练负载不均衡。

Stage 1:Dense Causal Language Model
第一阶段只使用 Expression View。模型根据表达排序后的 cell sentence 进行自回归 gene-token prediction,通过标准 causal language-modeling cross-entropy 学习细胞表达语法。这一阶段先建立稳定的单视角基础模型。
Stage 2:Function-preserving Dense-to-MoE Expansion
第二阶段将已训练的 Dense feed-forward 模块扩展为稀疏 MoE,同时保留原有语言建模目标,并加入 MoE auxiliary losses 以约束专家利用率。设计重点是先继承,再扩容,而不是从 12B MoE 随机初始化重新训练。
Stage 3:Multi-view LLM-JEPA Alignment
第三阶段同时输入 Expression View 和 Perception View,并在保留 causal language-modeling loss 的基础上加入跨视角 JEPA alignment loss;MoE 的辅助正则仍继续使用。最终模型因此兼顾表达生成结构、稀疏参数容量和多视角潜空间一致性。
3
实验评估
论文主要从三类任务验证 CellOS:细胞状态注释、批次整合和扰动响应预测。对比模型包括 UCE、State、scGPT、TranscriptFormer、STACK 和 C2S-2B。值得强调的是,前两类任务直接评估 foundation-model embedding;扰动任务则把不同模型 embedding 放入相同的 STATE transition framework,因此比较的是“表征作为扰动预测底座的质量”,不是 CellOS 独立端到端生成扰动后表达谱。
1.细胞状态注释

注释 benchmark 覆盖 6 个数据集,包括 PBMC immune aging、iPSC cell-type differentiation、iPSC developmental time-course、T-cell subclusters、human lung 以及 IFN-β-stimulated PBMC。作者使用 ARI、NMI 和 ASW 衡量 embedding 对真实细胞状态结构的保留能力,并在数据集内归一化后构建聚合指标。
CellOS 在聚合 annotation benchmark 上取得 normalized ARI = 0.751、NMI = 0.797、ASW = 0.828,综合 biological conservation score = 0.792。以 human lung atlas 为例,原始指标达到 ARI = 0.769、NMI = 0.858、ASW = 0.631,说明模型能够较好保留跨组织、跨粒度的细胞状态结构。
2.批次整合
批次整合在 human lung atlas 和 perirhinal cortex 两个带明确 batch 标签的数据集上评估,使用 silhouette batch、graph connectivity(GC)与 iLISI。CellOS 的 GC = 0.964,为对比模型中最高;综合 batch-effect score = 0.771,仅低于 STACK 的 0.801。
但作者同时强调,STACK 的 biological conservation score 为 0.474,而 CellOS 为 0.792。因此 CellOS 的优势并不只是把不同批次“混得更彻底”,而是在减少技术偏差的同时尽量保留真实的生物学邻域结构。
3.扰动响应预测:与 STATE Transition Model 组合

扰动预测使用 STATE 论文提出的统一 transition-model framework,测试 5 个 held-out cellular contexts:H1、HepG2、Jurkat、K562 和 RPE1。对所有基础模型,transition model、训练过程和评估协议保持不变,唯一变化的是输入的 foundation-model embedding。
CellOS 在 5 个 held-out contexts 的平均结果中获得 DE Spearman = 0.590、Pearson_edist = 0.619、clustering agreement = 0.633,并在 DE direction matching 上与最佳模型持平。论文特别指出 Pearson_edist 的下一最佳结果为 0.373,说明 CellOS embedding 对扰动后全局状态转移的保留明显增强。
这里最重要的解释是:这些数字并不代表“CellOS 单独就能把一个未见基因扰动直接生成成完整转录组”。它们说明,在相同的 STATE transition model 下,CellOS 提供的初始 cell-state representation 更有利于后续学习扰动状态变化。
4.消融实验与缩放规律
作者在 T-cell subcluster benchmark 上比较了 0.2B、2B 单视角预训练模型和最终 12B MoE + Stage-3 multi-view JEPA 模型。结果显示 ARI 和 NMI 随模型规模持续提高,而 ASW 基本稳定。
具体而言,0.2B 模型的 ARI/NMI/ASW 为 0.395/0.579/0.524;2B 为 0.497/0.660/0.523;12B Stage-3 模型为 0.539/0.688/0.531。作者将这一结果解释为两部分共同贡献:首先,大部分提升来自 0.2B → 2B 的参数扩展;其次,12B MoE 与 Stage-3 多视角 JEPA 对齐继续带来额外增益,特别体现在细粒度状态分辨上。
4
总结与讨论
CellOS 的核心贡献并不是再提出一种新的表达重建方式,而是重新定义一个单细胞应该被模型看到什么。传统 cell sentence 主要把表达丰度转成 gene order;CellOS 进一步加入 population-relative surprisal,让模型显式看到某个表达事件相对于群体背景是否异常和有信息。
在模型层面,CellOS 将三种思路组合在一起:Causal LM 负责学习表达序列结构,Dense-to-MoE 负责把模型扩展到 12B 级容量,LLM-JEPA 负责在潜空间对齐互补视角。其结果是一个强调细胞状态表征的 foundation model。
论文也明确指出三个主要局限。第一,当前 Perception View 使用全预训练群体的 gene-specific statistics,没有显式区分组织、谱系或条件背景;未来可以构造 context-aware perception。第二,模型目前只使用 transcriptome,尚未整合 chromatin accessibility、protein abundance、spatial information 等多模态。第三,两个视角在 latent space 中一致并不能证明模型学到了因果细胞机制;CellOS 也没有直接在扰动轨迹上进行预训练。
因此,现阶段 CellOS 更适合被理解为虚拟细胞的状态编码器/表示底座。如果未来继续加入 perturbation、time-course、多组学和空间信息,并训练显式的状态转移模块,才更接近可以直接模拟干预后细胞演化的 predictive virtual cell。
基于文章中所使用的先进人工智能技术,包括 Transformer、生成式模型和离散扩散模型等,联川生物持续关注人工智能与单细胞组学技术的融合发展。依托多组学数据分析经验与人工智能技术能力,可进一步探索 AI 在细胞状态建模、扰动响应预测、疾病机制研究及虚拟细胞等前沿方向中的应用,为生命科学研究提供更加智能、高效的数据分析解决方案。
基于文章中所使用的先进技术,包括深度学习,联川生物为您提供最前沿的生物分析解决方案。联川生物的专业团队将这些先进技术与丰富的经验相结合,为您提供高效、精准的服务。无论您的需求是基础研究还是临床诊断,我们都能够为您提供量身定制的解决方案。选择联川生物,让您的研究获得最新科技的支持,开创更广阔的科学道路。
参考文献:
Zhou Q, Le Y, Qi X, et al. CellOS: Learning a World Model of Cellular State through Joint Embedding Prediction. bioRxiv. 2026. doi:10.64898/2026.06.18.733163.


