本体(Ontology)这个词,在中国技术圈被讨论了至少十年。但讨论和落地之间,隔着一条很宽的沟。一位在金融风控一线做本体的讲师,在提交议题时写了这么一句话——“本体在企业里被讨论得很多,真正跑通的很少。”
所以,真正把本体跑进生产系统的中国企业,一只手数得过来。10 月 23-24 日,DACon 2026 北京站,这批企业第一次集中出现,并且把账本摊开了。
为什么少?
没有统一标准。Palantir、Snowflake、Databricks、Apache Ossie、Agent Memory,五条路线各走各的,差异不在“有没有图”,而在知识怎么表示、怎么运行、怎么生产、怎么验证。企业面对的不是“好不好”,是“跟谁”。
容易做成“大而全”。全域一次性铺开的本体,往往是最先陈旧的那一个。业务一变,它就臃肿、失效、贬值。
实现路径不可逆。本体到底是一层“翻译”还是一份“数据”?只建映射上线快但多跳跑不动,真建对象库查得快但要啃同步、一致性、成本、“谁是真值”一堆硬骨头。选错了,只能推倒重建。
口径永远在打架。各业务线对“活跃用户”各说各话,强行统一会扭曲业务理解,不统一 Agent 又不知道该听谁的。
建完就贬值。缺少持续迭代机制,知识资产从交付那天起开始折旧。
10月23-24日,DACon 2026北京站,这批企业第一次集中出现,并且把账本摊开了。
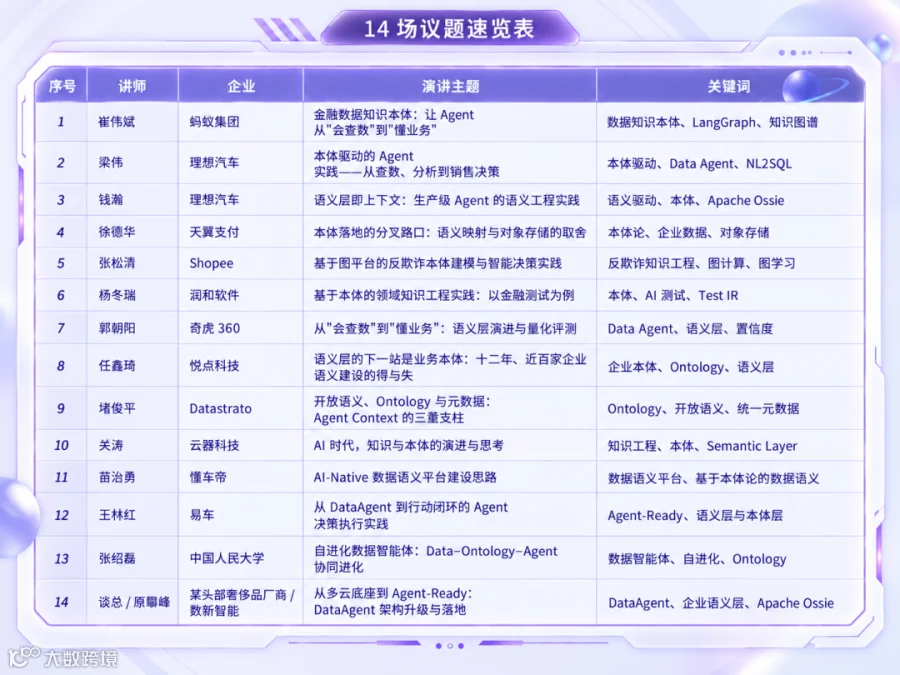
蚂蚁集团、理想汽车、Shopee、天翼支付、奇虎 360、懂车帝、易车、润和软件、悦点科技、云器科技、Datastrato、数新智能,以及中国人民大学——14 场演讲,覆盖金融、汽车、跨境电商、支付、内容、零售、工业软件七个行业。

扫码了解会议详情
 下面是完整的议题清单。
本体已经跑进生产系统的企业
这 7 场不是方法论推演,是已经在业务里跑起来、并且拿得出数字的实证。
01|蚂蚁集团:金融数据知识本体,让 Agent 从“会查数”到“懂业务”
讲师:崔伟斌 · 蚂蚁集团 · 资深数据技术专家、蚂蚁消费信贷数据负责人
演讲主题:蚂蚁集团金融数据知识本体:让 Agent 从“会查数”到“懂业务”
演讲介绍:蚂蚁的选择是:放弃“按表取数”的传统范式,用数据知识本体打通多源业务语义,把字段和指标翻译成“用户”“产品”“行为”这类业务对象,让系统理解数据到底在“说什么”。
最典型的问题是各业务线对“活跃用户”各说各话。蚂蚁的做法不是强行统一——而是让本体保留差异,Agent 按需取用。底层用 LangGraph 六节点状态机(InputParser → Comprehender → EntityResolver → Reconciler → Synthesizer → Verifier)自动化完成本体合成与校验;同时用 SQL Understander 从历史任务代码里反向萃取字段语义和表间关联,形成“代码即标注”的自动生成管线。
服务层用互索引架构,同步检索三类知识:KG_cs(业务视角,如花呗“活跃用户”的定义规则)、KG_fr(实体关系图,如“用户A-持有-借呗额度5万”)、RC(原始文档证据),三层结果融合去重后打包成 KnowledgePackage。
效果:交叉机会识别从 3-5 天缩到小时级,异动归因准确率超 85%,已支撑多条营销策略落地。
“本体不是字典,是让系统‘懂业务’的教材。”
演讲提纲:
1. 方案选型:为什么放弃“按表取数”,改走数据知识本体
2. 底层:LangGraph 六节点状态机,实现表结构全量感知、实体识别、跨表矛盾消融、本体合成与校验
3. SQL Understander(sqlglot + 正则):从历史任务代码反向萃取字段语义与表间关联
4. Reconciler:跨表同名字段的 7 层级成本递进消融(全自动合并 → 人工确认),核心原则是冲突标记但不强制合并
5. Verifier:Pydantic + 业务规则 + 深坑检测三重校验,不通过触发 L4 重试或降级 warning
6. 服务层:KG_cs / KG_fr / RC 三层协同检索的互索引架构
7. 成效:覆盖数千张表,交叉机会识别小时级,异动根因分析准确率 85%+
听众收益:
· 掌握一套可复用的“海量表自动化本体构建”方法论
· 理解“分层联合召回”架构如何提升业务分析效率
· 获得“多业务线口径冲突”在金融场景下的实战经验
02|理想汽车:本体驱动的 Agent,从查数、分析走到销售决策
讲师:梁伟 · 理想汽车 · 企业智能-算法研发 · 高级算法工程师、数据智能部门负责人
演讲主题:本体驱动的 Agent 实践——从查数、分析到销售决策
演讲介绍:理想汽车曾通过后训练把自然语言问数的业务准确率做到接近 100%。但随之而来的问题更棘手:知识准备和训练周期很长,扩展到新领域困难,业务口径一变就难以维护。
为解决这个问题,团队开始用本体重新组织企业数据,让对象、关系、指标和业务规则变成 Agent 可理解、可查询的语义结构。
这场演讲会复盘从 NL2SQL、MCP、Skill 到内置 Agent 的四次演进与取舍,并结合销售决策的真实实践,讲清本体如何支撑 Agent 从查数、分析,进一步走向业务决策。
演讲提纲:
1. 智能问数做得很准之后,我们遇到了什么:NL2SQL 与后训练方案在扩展和维护上的局限
2. 企业数据为什么需要按 Agent 的理解方式重新组织:业务语义与底层数据结构之间的距离
3. 如何设计面向 Agent 的本体:对象、属性、关系、指标、业务规则与语义查询机制
4. 从 MCP、Skill 到内置 Agent 的三次迭代:灵活性、稳定性和接入成本之间的取舍
5. 从查数走向决策:业务事实层、销售认知层、场景执行层的三层设计
6. 本体建设的边界与下一步:知识治理、持续优化中尚未完全解决的问题
听众收益:
· 理解 NL2SQL 在单领域取得高准确率后,仍然会遇到的扩展、维护和知识更新问题
· 了解如何通过对象、关系、指标和业务规则组织本体,降低 Agent 理解和使用企业数据的难度
· 获得一次基于实际业务场景的本体建模与应用经验,看本体如何支撑从查数分析走向业务决策

扫码了解会议详情
03|理想汽车:语义层即上下文,生产级 Agent 的语义工程
讲师:钱瀚 · 理想汽车 · 大数据平台负责人
演讲主题:语义层即上下文:理想汽车生产级 Agent 的语义工程实践
演讲介绍:生产级 Agent 的真正瓶颈不在模型能力,而在上下文质量——Agent 拿到的是散落在 Prompt、工具、日志里的碎片化信息,还是经过语义治理、可理解、可追溯的结构化上下文,决定了它能不能在生产环境稳定交付。
以 Spark/Flink 故障诊断为例,理想汽车把散落在 Prompt 与工具中的知识,拆分为本体、OSI、Playbook 和通用执行层四层,为 Agent 构建高质量语义上下文。Agent 据此跨日志、指标、数仓取证,形成有证据的根因判断,并把诊断缺口沉淀为可版本化、可校验、可回归的语义资产。
钱瀚拥有十余年分布式大数据与 AI 基础设施建设经验,先后任职搜狗、百度、京东、字节跳动,现主导理想汽车大数据云原生、实时数据湖、元数据与语义层技术落地,服务百万级车辆大数据场景,承载万亿级车辆信号处理。
演讲提纲:
1. 生产级 Agent 的上下文挑战:为什么散落知识是最大瓶颈
2. 语义层即上下文工程:本体、OSI、Playbook 的职责边界与协作
3. 理想汽车落地实践:从故障诊断到有证据的根因判断
4. 关键取舍与演进:从单点场景到生产级 Agent 平台
听众收益:
· 掌握一套将专家经验转化为可治理语义资产、为 Agent 提供高质量上下文的方法
· 理解本体、查询语义、Playbook 和工具层在上下文构建中的职责边界
· 学会构建带证据、置信度和答案边界的 Agent 输出,理解语义约束如何提升上下文质量
· 获得一条从单点场景逐步演进到生产级 Agent 平台的实践路径
04|天翼支付:本体落地的分叉路口——语义映射与对象存储的取舍
讲师:徐德华 · 天翼支付科技有限公司(天翼电子商务有限公司)· 风险管理部总监、模型团队负责人、总经理助理
演讲主题:本体落地的分叉路口:语义映射与对象存储的取舍与实践
演讲介绍:这是全场最直接的一本体落地复盘。
天翼支付在建设过程中反复撞上同一个问题:本体到底是一层“翻译”,还是一份“数据”?
· 只建映射,本体就是一层元数据,查询时翻译成面向数仓的 SQL,数据不搬家、上线快、无冗余;但多跳穿透跑不动,口径受底层表结构牵制,对象的状态和执行结果没有地方落。
· 真建一个对象库,把实例、属性、关系物化存下来,查得快、能承载状态、支持决策闭环;但要面对实时同步、增量一致性、存储成本和“谁是真值”这一堆问题。
这个选择基本不可逆。
而它的上游还有一个更容易被跳过的问题:概念口径和真实业务数据,本来就不该混在一层做。
这场演讲会完整交代这两个问题上的判断依据、混合方案的边界划法,以及为此付出返工代价的几个决策,同时给出本体如何为智能体供数、跨域如何复用、项目以什么标准验收的具体做法。
演讲提纲:
1. 业务背景:本体已经建成,智能体依然用不起来——三个现实瓶颈(缺少企业运行现实的表达、组织经验无法继承、单场景建设形成语义孤岛)
2. 方案选型:概念口径与业务数据为什么必须分两层做——概念层负责对象/属性/关系/口径/规则,实例层负责亿级实例、状态变化、历史链路与结果回写
3. 落地挑战:实例层是建映射还是建实例库——四条选型判据:查询形态、时延要求、是否需要状态与回写、变更频率
4. 解决思路:混合方案与一致性保障——核心对象物化、长尾保留映射,边界必须写死而不是临场判断
5. 面向智能体供数:最小必要上下文、受治理访问接口、回退条件与风险计量
6. 跨域复用与验收标准:业务域资产交付五件套(本体片段、规则库、案例库、已验证查询、评测集)
听众收益:
· 认知刷新:本体落地的真正难点不在建模方法,而在概念层与实例层的职责划分,以及实例层实现路径的不可逆选择
· 方法可复用:语义映射与对象存储的正面对比、四条选型判据、混合方案的边界划法,可直接用于自身架构决策
· 实践指南:面向智能体供数的具体设计与跨域复用规则,以及一套让本体项目可度量、可验收的交付模板与踩坑清单
05|Shopee:基于图平台的反欺诈本体建模与智能决策
讲师:张松清 · Shopee · Data Infra · 图平台负责人
演讲主题:Shopee:基于图平台的反欺诈本体建模与智能决策实践
演讲介绍:面对电商促销和信贷中账号、设备、交易等多实体协同伪装,传统表格模型很难识别团伙欺诈。Shopee 图平台把对象、关系与风险规则进行本体化建模,形成动态反欺诈知识网络:图数据库支撑实时关联查询,图计算发现社区和关键节点,图学习模型预测风险。
两个真实场景会完整展开:Monee Credit 用户关系图与信贷风控(贷前贷中识别效果提升明显,通过图数据库对线上借贷申请做实时资质审批),以及 Shopee 订单促销知识图谱与欺诈检测(结合图计算和 RGAT 等图学习模型识别黑产团伙与异常交易链路)。
张松清 2018 年起参与蚂蚁集团自研图存储系统从 0 到 1 建设,发表图数据专利 2 篇,后参与阿里搜索索引统一存储层研发,现负责 Shopee 图平台开发。
演讲提纲:
1. 业务背景:反欺诈为什么需要知识工程——传统表格模型难以识别团伙型、跨场景欺诈
2. 方案选型:一站式图平台与知识构建——图数据库 + 图计算 + 图学习的协同
3. 实践一:Monee Credit 用户关系图与信贷风控,贷前贷中效果提升与实时资质审批
4. 实践二:Shopee 订单促销知识图谱与欺诈检测,RGAT 识别黑产团伙与异常交易链路
5. 落地挑战与工程化:大规模异构关系、实时更新、特征供给、训练效率;特征预取与批处理优化
6. 未来规划:演进为可解释、可推演的动态反欺诈本体;探索 GraphRAG 与 Agent
听众收益:
· 了解面向企业的知识工程方法:如何将业务对象、关系和风险规则本体化建模,构建可实时演化的知识网络
· 掌握图数据库、图计算和图学习的选型边界与协同方式
· 获得电商促销和金融信贷风控实践经验,形成数据、规则与模型的闭环
扫码了解会议详情
06|润和软件:基于本体的领域知识工程——以金融测试为例
讲师:杨冬瑞 · 江苏润和软件股份有限公司 · 人工智能中心 · AI 架构师
演讲主题:基于本体的领域知识工程实践:以金融测试为例
演讲介绍:金融测试正从经验驱动转向 AI 辅助,但大模型直接生成仍面临三个硬伤:方法难复用、结果难追溯、质量难评估。
润和软件的解法是测试本体 + Test IR:结合业务本体沉淀测试方法论,以 Test IR 打通需求、大纲和案例;Agent 负责语义理解与方法选择,工具负责数据计算、案例装配和校验,形成“需求解析 → IR → 方法应用 → 案例生成”的可追溯链路。
这场演讲还会正面比较四条路线:直接用大模型(快但黑盒)、固定工作流与提示词(适合单场景但强耦合)、RAG 知识检索(能补知识但表达不了方法适用条件和输出约束)、本体与 Test IR(结构化、适合长期治理)。
杨冬瑞为东南大学博士,曾就职于华为 2012 实验室,主导众核系统性能分析平台建设、AI 辅助模型驱动开发工具开发。
演讲提纲:
1. 业务背景:为什么需要重新设计 AI 测试平台——需求/大纲/案例缺少统一表达,优秀方法难沉淀,Dify/提示词/Skill/脚本资产分散
2. 方案选型:为什么选择“本体 + Test IR + Agent + 工具”——四条路线对比
3. 总体架构:平台如何运转
4. 落地挑战:测试场景本体的分层与构建、本体的管理与演进、Test IR 设计与应用、测试方法论的构建与应用
5. 展望与总结
听众收益:
· 理解业务本体、测试本体和 Test IR 的职责边界,以及三者如何共同支撑 AI 测试
· 获得一条可渐进实施的建设路线:从现有提示词、Skill 和脚本出发,逐步演进为可查询、可治理的测试平台体系
07|奇虎 360:从“会查数”到“懂业务”,语义层的渐进式演进与量化评测
讲师:郭朝阳 · 北京奇虎 360 · 数据开发 · 湖仓 Data Agent 化演进技术负责人
演讲主题:从“会查数”到“懂业务”——奇虎 360 企业级 Data Agent 的语义层演进与量化评测实践
演讲介绍:360 在云数仓架构之上搭了一个“聊着天就把数据查了”的 AI 应用。但做着做着发现,想让它从“会查数”变成“懂业务”,中间隔着一座大山——语义层。
大模型写 SQL,学术数据集上能跑到 85%,一进真实数仓就现原形:几百张表、上万个字段、口径靠口口相传,准确率断崖式下跌,而且错了你都不知道它错在哪。
更麻烦的是,业务不可能等你花半年把语义层建好再上线。360 的做法是“半成品冷启动,边跑边长”:
· 双路径混合路由:语义完整的走确定性编译引擎(AST 主路径),只有表和文档的走 RAG 降级;每条结果带置信度分数——0.95 以上自动入报表,0.65 以下系统主动提示“这条我不太确定,建议人工确认”
· 薄 API → 厚 Skill → 本体元数据:高频使用的经验反向沉淀为语义资产,最终 Skill 退化为纯编排器,知识全由本体层提供
· 三级评测 + 反馈飞轮:L1 程序自动比对结果集 → L2 LLM Judge 语义判断 → L3 人工兜底,用户点赞经防污染过滤后自动采样为回归测试集
目前这套方案已支撑内部大数据集群运维、S3、PoleFS 存储运维的指标分析与归因,Ops 机房运维、文库搜索、会员中台等跨部门业务也已接入。
演讲提纲:
1. 范式转变:从“模型写 SQL”到“引擎写 SQL”——Spider 85% → 真实数仓 50%,差距来自哪里
2. 双路径混合路由:语义层不完善时的冷启动方案——AST 主路径 + Fallback RAG 降级 + PreMatch 置信度路由
3. 置信度的真正价值:不只是“准不准”,而是决定哪些场景敢投入生产
4. Skill 体系:薄 API → 厚 Skill → 本体元数据,与 Snowflake Cortex Agent 的层面对齐
5. 量化评测:学术基准为什么不够,三级评测架构与数据飞轮
听众收益:
· 一套可迁移的渐进式语义层落地方法论:双路径路由让系统先跑起来,RAG + 置信度引导让语义资产在使用中自然生长
· 理解 NL2SQL 学术与生产的鸿沟,以及如何搭建面向业务口径的生产级评测体系
· 掌握 Skill 到本体层的演进路径与设计取舍
· 可复用的三级评测架构:L1 程序 → L2 LLM → L3 人工 + 反馈数据飞轮 + 回归测试

扫码了解会议详情
本体与语义层:工程方法论与选型地图
这 5 场回答一个问题:本体该怎么建、跟谁走、投入产出的边界在哪。
08|悦点科技:语义层的下一站是业务本体,十二年、近百家企业语义建设的得与失
讲师:任鑫琦 · 北京悦点科技有限公司 · 创始人兼 CEO
演讲主题:语义层之上:让企业隐性经验成为 AI 可执行的资产——十二年、近百家企业的本体落地实践与教训
演讲介绍:你的语义层,是给人建的、给 BI 建的,还是给 AI 建的?
很多企业已经建起了数据平台和语义层,也上线了大模型应用,但项目往往停在同一个地方:AI 能查数、能答题,却进不了核心业务流程。原因在于业务概念、指标口径、业务约束以及专家的判断依据,大多以隐性经验的形式散落在文档和人的脑子里,从未真正被交付给 AI。
任鑫琦的核心观点是:领域本体不是数仓语义层的另一种叫法,而是一层独立于大模型的企业业务世界模型——它组织的是业务对象、关系、规则与可执行动作。
他从北大人工智能实验室开始做知识工程(方向包括 Ontology、知识表达与推理),2014 年起在明略数据从零孵化企业知识图谱产品 SCOPA,到现在悦点 Knora AI 平台,已经第十二年,服务近百家大型企业(制造、汽车、能源等)。这次他把建设体系、落地关键、成功与失败都摊开讲。
演讲提纲:
1. 开场:十二年、近百家企业,和一个 5‰ 的故事——我们在企业里究竟看到了什么
2. 语义层与业务本体:差在哪、能不能演进——本体作为独立于大模型的企业业务世界模型
3. 我们踩过的坑:术语与指标口径不一致;“大而全”的本体最先陈旧;业务、算法、数据三方认知难对齐
4. 方法论:场景优先的轻量化本体建模,大模型辅助知识萃取 + 专家审核的闭环迭代机制
5. 本体如何约束大模型:在 RAG 与 Agent 全链路做概念校验与生成约束,统一口径、降低幻觉
6. 案例拆解:制造业质量追溯——跨 CRM/MES/ERP/PLM 的追溯从多人数天到一人 5 分钟,良率提升 5%
7. 总结:大模型是表达与交互层,本体承载企业独有的业务知识,共同构成企业长期 AI 资产
听众收益:
· 拿到“语义层 → 业务本体”的演进判断:现有指标平台与语义层哪些可以复用、哪些需要重建,避免推倒重来
· 理解为什么仅靠向量检索与 RAG 难以支撑复杂业务推理,以及本体在 LLM 全链路中统一口径、约束生成的具体作用机制
· 获得一套可复制的隐性经验资产化路径:把一次性项目成果沉淀为企业长期可复用、可治理、可迭代的知识资产
· 获得来自近百家企业的横截面经验:本体 + Agent 在工业场景落地的常见失败模式、实施难点与规避策略
09|Datastrato:开放语义、Ontology 与元数据,Agent Context 的三重支柱
讲师:堵俊平 · Datastrato · 创始人兼 CEO,Apache Gravitino 项目发起人
演讲主题:开放语义、Ontology 与元数据:Agent Context 的三重支柱
演讲介绍:当 Agent 从回答问题走向推理、决策与执行,数据的可访问性已不足以支撑可靠的智能。Agent 不仅需要知道“数据在哪里”,还需要理解“数据意味着什么”“业务实体如何关联”,以及“行动受哪些规则约束”。
堵俊平给出的框架是三层递进:
· 统一元数据——基于 Apache Gravitino 的跨云、跨引擎、多模态数据统一元数据管理,为数据资产提供一致描述与访问接口
· 开放语义层——指标、维度、业务定义标准化,消除“一个指标多个口径”
· Ontology(本体)——建模业务实体、关系与规则,使 Agent 能把自然语言中的业务意图精确映射到真实数据
他还会正面比较两条上下文建设路径:自上而下(应用任务驱动,快但容易形成上下文孤岛)与自下而上(元数据治理驱动,底座扎实但推导不出业务含义),并给出“业务场景牵引建模 + 统一元数据连接 + 反馈迭代”这一更可持续的混合路径。
堵俊平原任 LF AI & Data 基金会董事主席,曾任腾讯开源负责人兼大数据研发总监、Cloudera Hadoop 团队负责人。
演讲提纲:
1. 开篇:从数据连接到上下文构建的演进——Agent 需要的三件事
2. Agent Context 的三重支柱:统一元数据 → 开放语义层 → Ontology 逐层递进
3. 两种策略比较:自上而下 vs 自下而上,各自的适用场景与局限
4. 更可持续的混合路径:业务场景牵引建模,以统一元数据连接业务概念、数据资产与治理规则,通过业务校验和 Agent 反馈持续迭代
5. 产品化实践:从数据目录到 AI Context Platform(Datastrato 2.0 / Gravitino 2.0 企业版)
听众收益:
· 建立对 Agent 上下文基础设施的完整认知框架:理解三层递进关系如何支撑 Agent 从“找数据”到“懂业务”再到“守规则”
· 掌握两条建设路径的适用场景与局限,获得更可持续的混合策略方法论
· 了解数据目录向 AI Context Platform 演进的产品化方向,获取可参考的架构设计与技术选型思路
· 获得治理视角的实践参考:如何在明确治理边界内让 Agent 把业务意图映射到真实数据
扫码了解会议详情
10|云器科技:本体没有统一标准,五条路线企业该跟谁?
讲师:关涛 · 云器科技 · 联合创始人 & CTO
演讲主题:AI 时代,知识与本体的演进与思考——从数据工程到知识工程
演讲介绍:AI 时代对企业来说,模型与 Harness 能力决定效果的下限,企业知识系统决定 AI 产生业务价值的上限。
为什么企业已经建设了数据平台、RAG 和知识图谱,AI 仍然经常答不准、说不清、做不了?问题往往不只在模型和 Agent Harness,而在于企业缺少一套能够表达业务语义、关系、规则和上下文,并连接真实行动的知识系统。
本体是组织企业知识的重要方式,但本体当前没有统一标准。Palantir、Snowflake、Databricks、Apache Ossie 与 Agent Memory 实际采用了五种不同路线。它们真正的差异不是“有没有图”,而是知识如何表示、运行、生产和验证。
这场演讲从 DIKW 出发,拆解知识与本体的演进,比较五类主流技术路线,并给出企业从数据工程走向知识工程的落地路径。
关涛有 17 年分布式系统和大数据平台开发经验。2006 年在微软亚洲研究院构建微软第一代分布式 KV 系统(7000 台规模)和 Bing 搜索分布式存储后台(4 万台规模);2016 年回国加入阿里云,任计算平台事业部研究员、阿里巴巴通用计算平台负责人(飞天 MaxCompute,10 万+规模);2021 年创立云器科技。2018 浙江省科技进步一等奖,2021 USENIX ATC best paper award。
演讲提纲:
1. AI 时代,为什么有了数据还不够
2. 知识、本体、Semantic Layer 与知识图谱的关系
3. 本体当前没有统一标准:五类主流路线如何选择
4. 企业知识建设的起点:内核、外围与开放接口
5. 持续知识工程的参考架构和案例:生产、评估、认证与更新
听众收益:
· 一张概念地图:厘清数据、知识、本体、Semantic Layer 与知识图谱
· 一张选型地图:看懂五类主流方案的差异、边界与适用场景
· 一条落地路线:从高价值业务域开始,建立可持续演进的企业知识闭环
11|懂车帝:AI-Native 数据语义平台,本体是强约束知识层
讲师:苗治勇 · 懂车帝 · 数据仓库负责人
演讲主题:AI-Native 数据语义平台建设思路
演讲介绍:AI 问数正在成为数据消费的基础能力,但大模型直接回答业务数据问题时,容易出现幻觉、不稳定、不置信。尤其在 Text2SQL 场景,单纯依赖模型训练知识或文本召回,很难保证结果准确一致。
语义层的价值,是在大模型和底层数据资产之间增加一层强约束知识。它把指标、维度、实体、业务过程、物理实现、SQL 规则结构化管理起来,让 AI 在明确边界内理解业务、生成 SQL、解释结果。相比单一文本知识库、RAG 向量召回或全量元数据召回,语义层有更明确的查询约束、可解释性、更低的推理消耗。
平台化之后,进一步解决口径过期、物理表更新、本地版本不一致、知识分散维护等问题——平台作为统一事实源,持续管理语义定义、版本、映射关系和消费治理。
演讲提纲:
1. 为什么需要语义平台
2. 本体和数据语义
3. 语义平台建设思路:语义挖掘、语义检索、本体、语义映射、测评体系、MCP、数据治理
4. 未来方向
听众收益:
· 如何基于数据仓库做数据语义平台建设
· 面向数据消费的数据语义建设方法
· Data Agent 的落地路径

扫码了解会议详情
12|易车:从 DataAgent 到行动闭环,本体是三层底座之一
讲师:王林红 · 易车 · 数据平台负责人
演讲主题:从 DataAgent 到行动闭环的 Agent 决策执行实践
演讲介绍:企业数据从支撑人查数走向 Agent 决策执行,挑战不只是 Text2SQL,而是口径、上下文、权限与行动风险。
易车从 ChatBI、DataAgent 演进到 DataWork,建设覆盖可信数据、语义、本体和知识、MCP 与 Harness 的三层底座,并以查询进化和主动跟进打通分析、行动与结果验证,形成从可信问数、辅助分析到受控执行的企业数据智能演进路径。
王林红长期深耕大数据与 AI 领域,曾主导多家公司大数据平台、数据中台从 0 到 1 建设,现负责企业级 AI Agent 体系规划及落地,推动数据、语义、知识与执行能力平台化。
演讲提纲:
1. 从 ChatBI 到 DataWork:易车的实践历程
2. 从“会查数”到决策执行面临的挑战
3. 面向 Agent-Ready 的企业数据建设
4. 建设 Agent 原生底座:构建企业级 Harness 体系
5. 从工具提效到自主洞察:数据智能系统的能力进化
6. 未来规划
听众收益:
· 了解易车从 ChatBI 到 DataAgent 的演进过程,以及在其中遇到的挑战
· 了解如何做好数据、知识和工具建设,让 Agent 找得到、看得懂、用得好企业数据
· 理解 DataAgent 不止于问数,Agent 如何从回答问题走向主动发现、自主洞察和决策执行
前沿探索与跨行业延伸
13|中国人民大学:自进化数据智能体,Data–Ontology–Agent 协同进化
讲师:张绍磊 · 中国人民大学信息学院 · 助理教授
演讲主题:自进化数据智能体:迈向 Data–Ontology–Agent 协同进化
演讲介绍:面向表格、数据库与文档等异构数据环境,现有数据智能体仍面临业务意图、数据语义与工具执行难以对齐的问题。传统固定工作流、检索增强和静态知识图谱,通常缺乏对开放任务与动态数据的持续适应能力。
张绍磊提出以 Ontology 作为可执行语义中间层的方法框架,统一建模领域概念、工具能力与数据模式,并基于智能体交互轨迹开展失败归因、知识修正和成对评测门控。
关键洞察是:数据智能体的典型错误并非来自模型幻觉,而是来自数据对象识别、字段语义映射和工具选择错误。
系统已稳定运行 6 个月,注册用户超 2000 人、深度用户约 400 人,获得 300 余所高校和研究机构的试用申请。
张绍磊于中国科学院计算技术研究所获得博士学位,在 NeurIPS、ACL、ICLR 等会议发表论文 30 余篇,开源项目在 GitHub 累计 10000+ 星标,曾任 ACL ARR 领域主席。
演讲提纲:
1. 业务与技术背景:数据智能体为何仍然“不理解数据”——Agent–Data Gap
2. 方案选型:为什么需要 Ontology 语义层(对比固定工作流、RAG、静态知识图谱)
3. 落地挑战:从静态 Ontology 走向自进化 Ontology——冷启动、失败归因、避免能力回退
4. 解决思路:Data–Ontology–Agent 协同进化
· 三层 Ontology:Content Layer(业务概念/指标口径/实体关系)、Tool Layer(工具能力与约束)、Schema Layer(逻辑概念到物理表字段的映射)
· 交互轨迹失败归因 → 候选修改生成 → 持出验证集成对评测门控 → 版本化发布 / 拒绝回滚
· 形成“数据暴露问题 → 智能体产生轨迹 → Ontology 沉淀知识 → 智能体再次验证”的持续进化闭环
5. 系统实践与阶段性成效
6. 未来规划:多智能体协同治理、与强化学习结合、多模态扩展、跨组织 Ontology 迁移
听众收益:
· 建立对 Agent–Data Gap 的系统认知,理解数据智能体的错误为何常发生在模型推理之前,并能区分模型、工具、数据和语义层问题
· 掌握可执行 Ontology 的设计方法:Content、Tool、Schema 三层结构如何连接业务意图、工具操作与底层数据
· 获得一套可落地的自进化机制:交互轨迹归因、候选知识修改、成对评测门控、版本管理与安全回滚
14|某全球头部奢侈品厂商 × 数新智能:Apache Ossie 本体规范与语义增强
讲师:谈总(某全球头部高端零售厂商 · 亚太大数据负责人)× 原攀峰(数新智能 · CTO)
演讲主题:从多云底座到 Agent-Ready:企业 DataAgent 架构升级与高端零售行业落地实践
演讲介绍:大模型正从单点 Copilot 演进为 Agent 智能范式,但企业的数据散落在多云多品牌之间,合规约束严苛,碎片化 AI 应用各自为战,Agent 上了线也“无数据可用”。
这是一场双人分享,上下两篇:
· 上篇|业务视角:拆解高端零售全球化多云数据管理的真实痛点——数据孤岛、合规壁垒、碎片化 AI 的局限,以及对 Agent-Ready 数据底座的核心诉求
· 下篇|技术视角:多云 AI 原生平台之上的 DataAgent 整体架构、企业语义层构建、沙箱安全防护与闭环迭代体系
效果数据:端到端数据交付效率整体提升约 70%;Agent 任务诊断准确率提升 50%;通过语义知识库建设,代码生成准确率从 30% 提升到 90%。
原攀峰为数新智能 CTO,北航计算机硕士,前阿里巴巴集团大数据平台高级技术专家,阿里御膳房、阿里云数加、DataWorks 创始团队核心领导,0-1 完成阿里云隐私计算平台 DataTrust 产品研发及商业化落地,国内外发明专利 20 篇。
演讲提纲:
1. 上篇:高端零售全球化数智化转型背景与多云数据核心痛点
2. 上篇:行业 AI + 数据智能化实践——门店优化、用户运营、需求预测、防伪溯源
3. 上篇:业务侧对 Agent-Ready 数据底座的核心诉求
4. 下篇:数新一站式 DataAgent 整体架构设计——多云数智底座 + 企业专属语义层
5. 下篇:四大核心工程能力——Skills 技能生态、上下文工程、沙箱安全防护、闭环迭代体系
6. 下篇:企业落地难点专项解法——多版本兼容容错、CodeWiki 语义增强补齐业务知识库
7. 效果衡量与未来展望
听众收益:
· 业务视角:了解高端零售全球化企业多云数智转型的真实痛点,掌握 Agent-Ready 数据底座的建设门槛
· 技术视角:掌握 Harness 范式企业 DataAgent 完整架构设计,学习沙箱、细粒度权限管控等高合规行业安全落地策略
· 工程实践:学习 Apache Ossie 本体规范、CodeWiki 语义增强方法论,补齐企业元数据短板,提升 Agent 业务理解与执行准确率
本体在中国落地,稀缺是有原因的。
它不只是一个技术选型问题,而是一连串必须提前做出的判断:概念层和实例层要不要分开?实例层建映射还是建对象库?口径冲突是强行统一还是保留差异?本体是一次性交付还是持续演进的基础设施?建完之后,怎么证明它比原来的方案更好?
这些问题没有标准答案,只有不同企业在各自约束条件下做出的取舍。
而真正有价值的,恰恰是这些取舍本身,以及它们背后的代价。
10 月 23-24 日,DACon 2026 北京站。这 14 场演讲,是截至目前中国企业在本体落地上最密集的一次集体公开。
不管你是正在评估要不要上本体,还是已经上了但卡在“建完用不起来”,这里面大概率有一场,能帮你省下半年。
📅 时间:2026 年 10 月 23-24 日
📍 地点:北京希尔顿逸林酒店
🎫 报名:点击「阅读原文」或访问
🔥 9 折优惠购票火热进行中...... DACon 2026 北京站,15 个分论坛,60+ 真实应用案例,2 天沉浸式学习交流,现场还有闭门会和晚场圆桌。