H3 RH Enhanced:开源后训练模型的工业化突围
新智元报道

7月底MiniMax H3开源时,凭借Artificial Analysis视频编辑榜Elo 1130分的成绩登顶全球第一,社区反响热烈。然而,在实际量产应用中,H3仍面临多镜头长叙事角色走样、商品轮廓失真及连续镜头一致性下降等工程化短板。
从「跑得通」到「生产能用」,差距在于工程化能力。9月29日,海马云旗下AIGC平台RunningHub发布基于MiniMax H3深度后训练的增强模型——H3 RH Enhanced。该模型通过2000组实测验证,在多镜头长时序叙事能力上显著优于Seedance 2.0,整体表现直追Seedance 2.5,且生成成本仅为同等效果闭源模型的十分之一,低至每秒0.18元。
目前,H3 RH Enhanced已登陆MiniMax官方平台,面向全球B端创作者开放调用,并可在RunningHub平台体验。
2000组盲测:多镜头叙事稳定性显著领先
为验证真实场景表现,RunningHub针对人物连续特写、多场景转场运镜、多角色互动、16镜头以上完整叙事四类业务场景,各选取500组对照样本,合计2000组数据,横向对比主流模型。
测试结果显示,在8至16镜连续生成的长叙事任务中,RH Enhanced在人物身份一致性、场景元素留存及指令约束留存三项关键指标上,均显著领先Seedance 2.0。
实测案例一:赛博机车追逐(15秒/14镜)
在使用相同参考图与提示词、480P直出且无针对性调参的条件下:
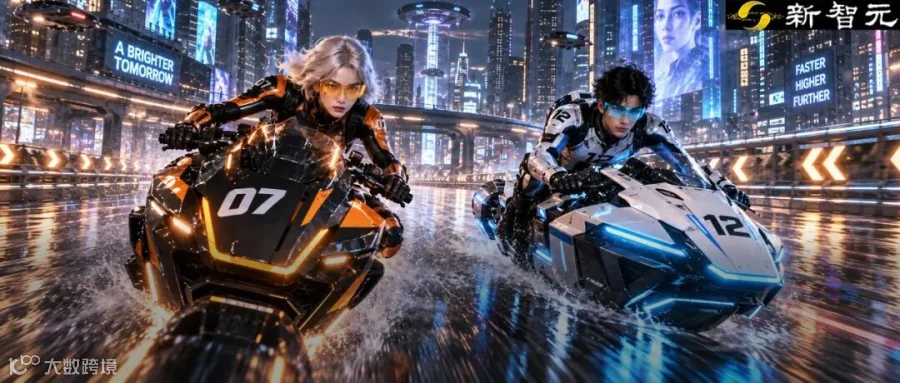
RH Enhanced表现:两辆机车(07号黑橙、12号白蓝)从起跑到冲线保持一致,号码牌清晰;女主在正面、背后、双人特写及终点定格四种机位下,面部特征、橙色肩甲机车服及背景城市均保持高度一致;音画同步生成,声效随画面动态变化。
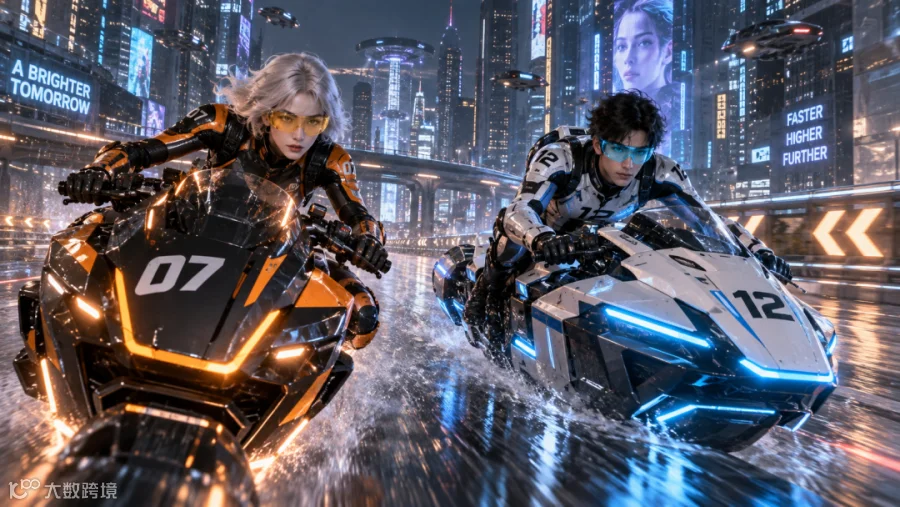
RH Enhanced生成效果
Seedance 2.0表现:虽然单帧画质精致,但在多镜头下出现严重不一致:第4镜车辆变为Tron风格光环轮;第5镜航拍场景切换且广告牌消失,存在穿模;第6镜女主机车服从装甲款变为普通皮衣。整体连贯性不足。
Seedance 2.0生成效果
实测案例二:电商香水广告(15镜)
电商视频核心痛点在于商品一致性。
RH Enhanced表现:全程保持参考图中方正厚玻璃瓶、琥珀液、黑盖金环及ORBIT 07标识不变;模特在沙漠、雨夜、电梯、天台等多场景切换中,面部与黑丝绒礼服保持一致。
RH Enhanced生成效果
Seedance 2.0表现:画面精致,但在电梯镜头中出现商品悬空于掌心上方的物理错误。
Seedance 2.0生成效果
极端长场景:人物崩坏率降低60%以上
在16镜以上的超长叙事中,Seedance 2.0易出现角色遗忘、换脸、换装及道具丢失等问题。RH Enhanced凭借自研的RH长程记忆引擎,将此类崩坏率降低60%以上。
18镜五世界穿越测试:RH Enhanced在雨巷、沙漠、雪林、地铁、空间站五个场景中,四次正面特写均为同一张脸,黄雨衣、红伞、黑包等道具全程在线,首尾呼应的街角时钟位置准确。相比之下,Seedance 2.0在中段出现帽子摘戴不一、红伞长时间消失等重大逻辑错误。
18镜东方奇幻测试:涉及女剑仙、黑甲将军、灵兽三个主体。RH Enhanced确保了三者外貌、服饰、武器及位置关系的严格一致,即便在最后天宫半塌的复杂场景中,三者空间关系依然清晰。Seedance 2.0则出现将军无脸、天宫未坍塌等提示词执行偏差。
RH Enhanced的核心优势在于其长程记忆引擎,能在模型架构层面锁定跨帧信息,确保第14镜仍能精准 recall 第1镜的五官、服装和道具,无需依赖后期修补。
目前,RH Enhanced日均生成视频近100万秒,相当于每天产出6.7万条15秒短视频或3300多集5分钟短剧。

五层工程改造:打造量产级视频管线
RunningHub对H3基座进行了从后训练到服务调度的五层深度改造,旨在解决量产场景中的稳定性、速度与成本问题。
第一层:场景定向后训练
针对短剧、电商、漫剧的垂直业务约束,构建「场景SFT → 一致性优化 → 少步蒸馏」训练链路。使用标注清晰的真实业务数据,重点优化人物不换脸、参考图还原度、动作完整性及运镜稳定性,结合长程记忆引擎,大幅降低废片率。
第二层:分辨率感知适配
根据交付规格对训练数据按宽高比、帧数、时长分桶,并对人脸、商品轮廓等关键区域进行加权。此举缩短了视觉Token,节省算力,同时确保成片直接可用,无需额外剪辑调整。
第三层:少步蒸馏技术
采用「教师—学生」式轨迹蒸馏,让学生模型学习教师模型在采样过程中的速度场方向和重建目标,将几十步的质量压缩至少步完成。系统根据镜头动态程度智能分配步数,平衡质量与效率。
第四层:注意力与缓存协同加速
- SageAttention2:通过离群值平滑和低精度运算提升吞吐。
- Cache-DiT:自研Dual Block缓存技术,根据特征变化幅度复用中间层计算结果,减少冗余计算。
- torch.compile:编译融合算子,减少内存搬运。
- 混合并行:TP2+Ulysses4组合,适配普通多卡环境,无需NVLink即可高效运行。
第五层:批量服务调度
针对大规模量产需求,自动将输入形状相近的任务分桶组batch,预热高频配置参数,并在多服务器间实时调度负载。最终实现GPU利用率最大化,将单秒生成成本降至0.18元。
海马云十年GPU工程底座支撑
RunningHub母公司海马云拥有十年云渲染经验,具备国内60多个边缘节点及大规模异构GPU集群运营能力。通过「渲推一体」策略,利用AI推理与云渲染的时间错峰,实现GPU资源全天候满载,进一步摊薄成本。
与仅做模型聚合的平台不同,RunningHub构建了从算力层、模型层、Harness执行层、数据层到应用层的五层能力栈:
- 算力层:异构GPU调度与渲推错峰。
- 模型层:开源基座后训练与全球主流模型编排。
- Harness执行层:工作流与Agent引擎,连接业务链路。
- 数据层:基于真实业务行为沉淀专家轨迹数据集,形成数据闭环,实现模型递归进化。
- 应用层:提供API、SDK及可视化App。
此外,RunningHub已形成完整的AIGC视频工业管线:RH Lightning负责提速(推理提速12倍),RH Enhanced负责出片,RH Upscale负责画质增强(综合性能行业第一)。RH Enhanced已获得MiniMax官方认可并上架其官网,标志着基座厂商对第三方后训练方案的高度背书。

结语:从热点走向基础设施
当前AI视频创作的瓶颈已非画质,而是多镜头一致性导致的废片率高企以及高昂的部署或使用成本。RH Enhanced通过降低崩坏率和每秒成本,使得小团队也能负担得起批量生产级的AI视频服务,无需自行维护高昂的硬件设施。
AI视频要从技术热点转化为基础设施,关键在于打通生产工作流。RunningHub通过工程化手段,将模型能力转化为稳定、低成本的生产力,为行业提供了可行的规模化解决方案。
编辑:所罗门