大数跨境

UBS:云端AI需求正在把半导体紧缺推向整条制造链

UBS:云端AI需求正在把半导体紧缺推向整条制造链 半导体产业报告
2026-09-30
9
导读:1GW 的 AI 服务器项目,最后会落到晶圆厂和封装厂的排产表上。
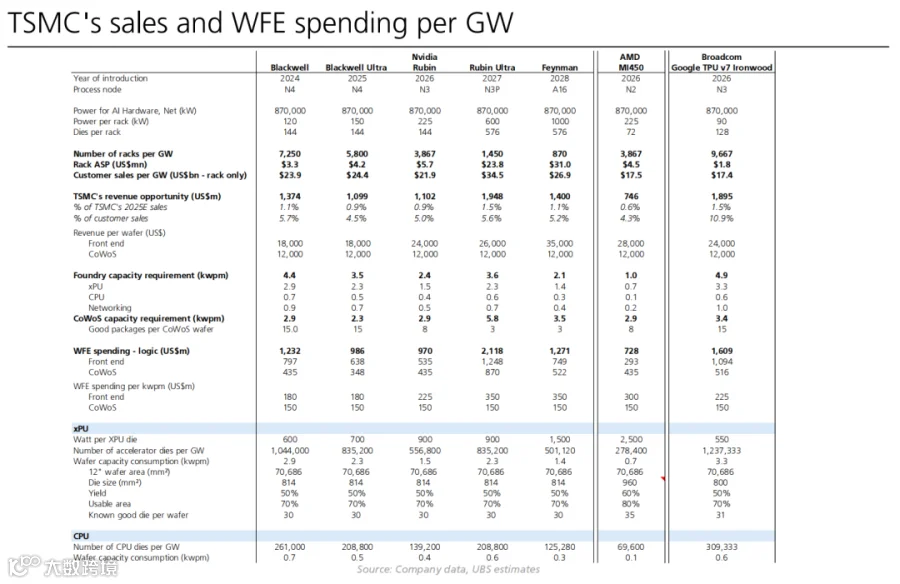
1GW AI 服务器项目的落地,最终将转化为晶圆厂与封装厂的产能排期。根据瑞银(UBS)测算,每新增 1GW 云端 AI 服务器建设,AI 加速器、CPU 和网络芯片需消耗约 2-5kwpm 的 N3/N2 先进制程产能,以及 3-6kwpm 的 CoWoS 产能;对应逻辑设备支出约 10-20 亿美元。其中 kwpm 指每月千片晶圆产能。这一量化指标比笼统的“需求强劲”更能反映制造端的真实压力。

1GW 项目拆解:两张关键的产能账单

AI 服务器不仅是加速卡的堆叠,更涉及 xPU、CPU、网络芯片及先进封装的系统级整合。不同架构在功耗、Die 数量及机柜规模上的差异,直接决定了晶圆与封装产能的消耗量。
以 1GW 服务器项目为例:
  • Nvidia Blackwell:需 4.4kwpm 代工产能及 2.9kwpm CoWoS 产能;
  • Nvidia Rubin Ultra:CoWoS 需求升至 5.8kwpm;
  • Google TPU v7 Ironwood:先进制程需求达 4.9kwpm。
数据显示,需求扩张不仅限于 Nvidia GPU,ASIC 和 TPU 同样在收紧先进产能。云厂商每宣布一个大型 AI 数据中心项目,实质上是在提前锁定先进制程、CoWoS 及后端产能。架构能效、Die 尺寸及 HBM 用量等因素,均会形成差异化的产能消耗曲线。

TPU 重塑先进产能分配格局

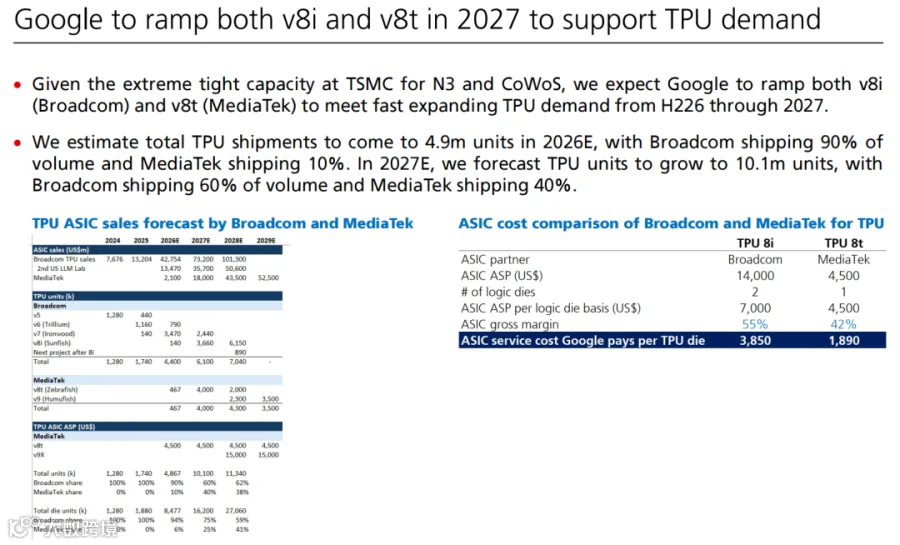
Google TPU 的发展将先进产能竞争从 GPU 扩展至 ASIC 设计服务领域。鉴于台积电 N3 制程和 CoWoS 产能紧张,单一合作伙伴难以满足全部需求,瑞银预计 Google 将在 2026 年下半年至 2027 年间,同步推进 Broadcom v8i 和 MediaTek v8t 两条技术路径。
预测显示,TPU 总出货量将从 2026 年的 490 万颗增至 2027 年的 1010 万颗。其中,Broadcom 出货占比由 90% 降至 60%,MediaTek 则由 10% 升至 40%。这一变化不仅涉及设计服务份额的调整,更将深刻影响 N3、CoWoS 及 ASIC 供应链的排产策略。
若仅关注 GPU,极易低估先进产能竞争的激烈程度。TPU 在单颗价值、Die 结构及成本分摊上具有独特性,其带来的晶圆消耗更为显著。测算表明,Google TPU v7 Ironwood 每 1GW 对应 4.9kwpm 的代工产能需求,高于多数 GPU 架构。随着云端 AI 走向“GPU、ASIC、TPU 并行”,制造端已无法用单一的产能曲线概括整体需求。

瓶颈转移:从 CoWoS 延伸至 N3/N2

过去两年,市场焦点集中于 CoWoS 短缺。瑞银指出,2027 年更大的瓶颈可能出现在台积电领先制程,尤其是 N3 节点。
预计 2026-2027 年,台积电 N3 产能利用率将持续超过 100%。即便到 2027 年底产能扩至 210kwpm,供应依然紧俏。更关键的是需求结构的变化:服务器加速器、CPU 和网络芯片在 N3 需求中的占比,预计将从 2026 年的 36% 飙升至 2027 年的 73%。尽管消费电子需求仍在,但先进制程的新增压力主要源自数据中心。
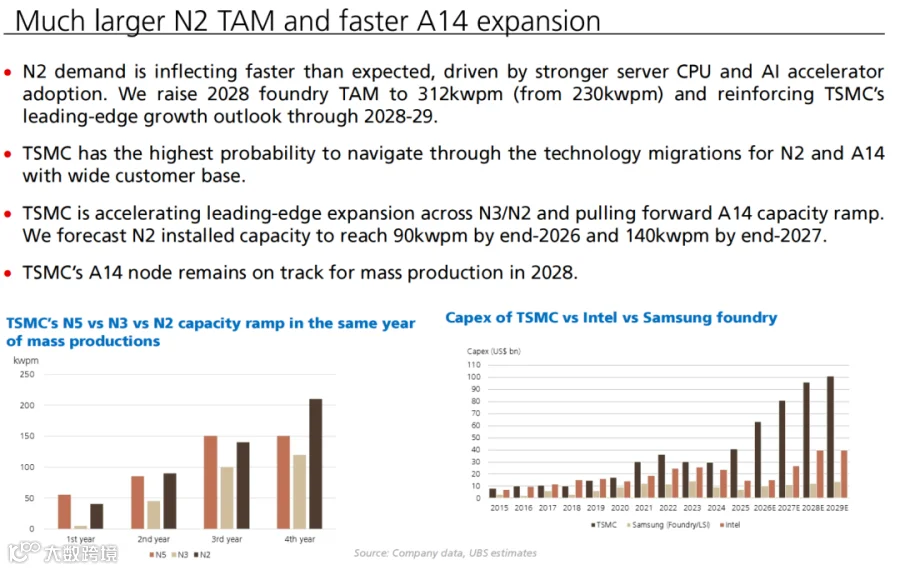
N2 制程的节奏也在提前。瑞银将 2028 年代工总市场规模(TAM)预期从 230kwpm 上调至 312kwpm,并预计台积电 N2 装机产能将在 2026 年底达到 90kwpm,2027 年底达到 140kwpm。这表明 AI 需求正在推动 N3、N2 及 A14 等多代节点同步前移。
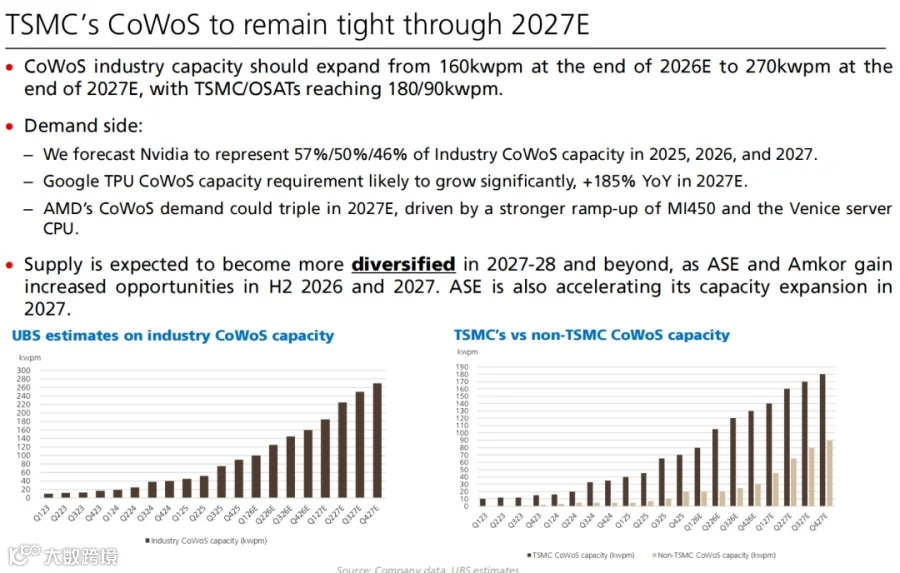
CoWoS 产能虽在扩张,但紧张态势仍将延续。行业产能预计从 2026 年底的 160kwpm 增至 2027 年底的 270kwpm(台积电 180kwpm,OSATs 90kwpm)。然而,需求端呈现多元化增长:Nvidia 持续占用大量产能,Google TPU 的 CoWoS 需求预计在 2027 年同比增长 185%,AMD 的需求也可能接近三倍增长。

CPO 演进:节奏比预期更务实

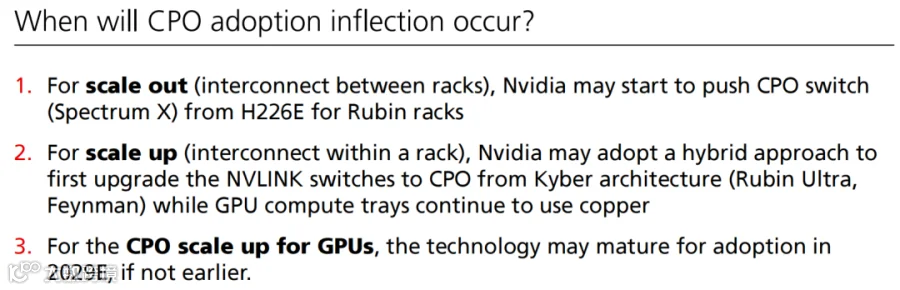
关于共封装光学(CPO)的市场预期往往过于激进。瑞银给出的时间表更为克制:
  • Scale-out(机柜间连接):Nvidia 可能从 2026 年下半年 Rubin rack 的 Spectrum X 交换机开始引入 CPO;
  • Scale-up(机柜内连接):初期可能在 Rubin Ultra 和 Feynman 架构的 NVLINK 交换机中升级,GPU 计算托盘仍沿用铜连接;
  • GPU 侧 Scale-up CPO:技术成熟时间预计在 2029 年或更早。
对产业链而言,传统光模块仍占据主要体量,但光学能力正逐渐向交换芯片、xPU 及封装端靠近。预计光收发器可服务市场(SAM)将从 2025 年的 120 亿美元增长至 2030 年的 320 亿美元,其中 CPO 方案在 2030 年可能达到 70 亿美元,硅光产业销售额在 2028-2030 年间有望达到 40-60 亿美元。
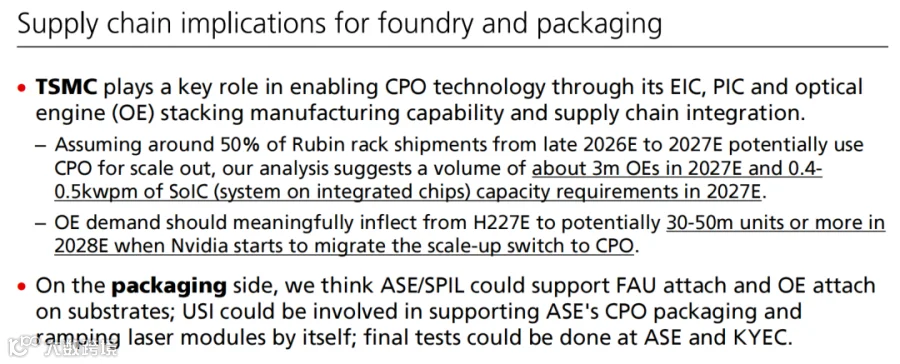
制造端面临更复杂的整合挑战。光引擎靠近芯片意味着 EIC、PIC、OE stacking、SoIC、FAU attach 等环节需协同作业。测算显示,若 2026 年下半年至 2027 年约 50% 的 Rubin rack scale-out 采用 CPO,2027 年将产生约 300 万颗 OE 和 0.4-0.5kwpm SoIC 产能需求;至 2028 年,OE 需求可能激增至 3000-5000 万颗。

成熟制程与上游材料同步趋紧

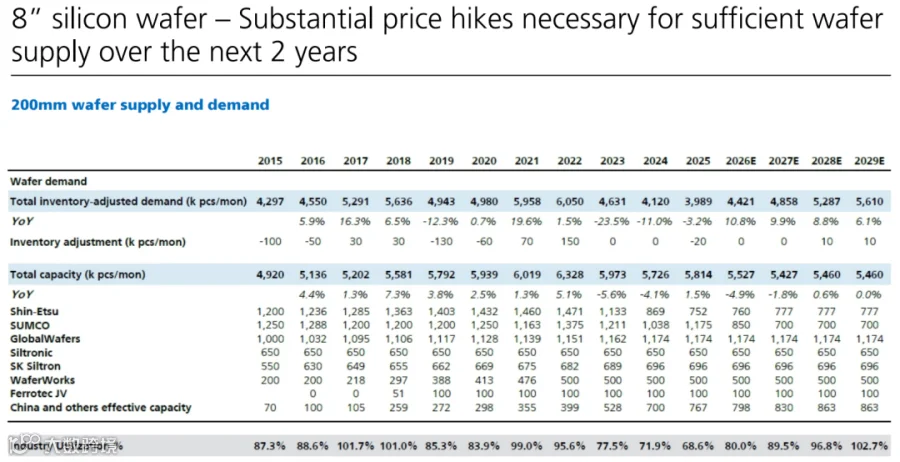
除先进制程外,成熟制程产能亦显现紧张迹象。预计 8 英寸晶圆厂利用率将从 2026 年的 85% 升至 2027 年的 95%,12 英寸 28/40nm 利用率从 84% 升至 88%。这一趋势并非单纯依赖消费电子复苏,而是由以下因素驱动:
  • AI 服务器中 PMIC 和电源半导体含量增加,持续消耗 8 英寸及成熟 12 英寸产能;
  • 台积电将部分成熟制程资源优化配置给先进封装,导致成熟节点“可用产能”减少;
  • 中国大型晶圆厂资本开支转向先进制程,成熟节点扩张趋于克制。
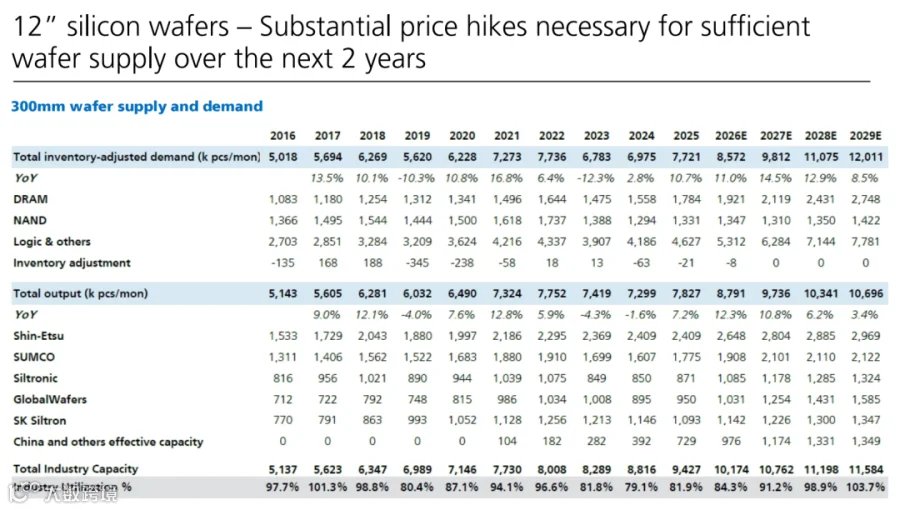
硅片供应成为另一层约束。经库存调整后的 300mm 硅片需求将从 2025 年的 772.1 万片/月增至 2027 年的 981.2 万片/月,行业利用率从 81.9% 升至 91.2%;200mm 硅片需求从 398.9 万片/月增至 485.8 万片/月,利用率从 68.6% 升至 89.5%。在先进制程、成熟制程、存储及功率器件共同拉动下,上游材料缓冲空间日益缩小。

存储本土化:一道复杂的产能方程

美国本土存储供给面临多重约束。美光(Micron)在美国有两项前端扩产计划:Boise 工厂产能约 80kwpm(用于 DRAM 和 HBM),设备搬入始于 2026 年中,满产需两年;New York 工厂产能约 200kwpm(用于 DRAM),设备搬入预计 2028 年开始,满产需四年。
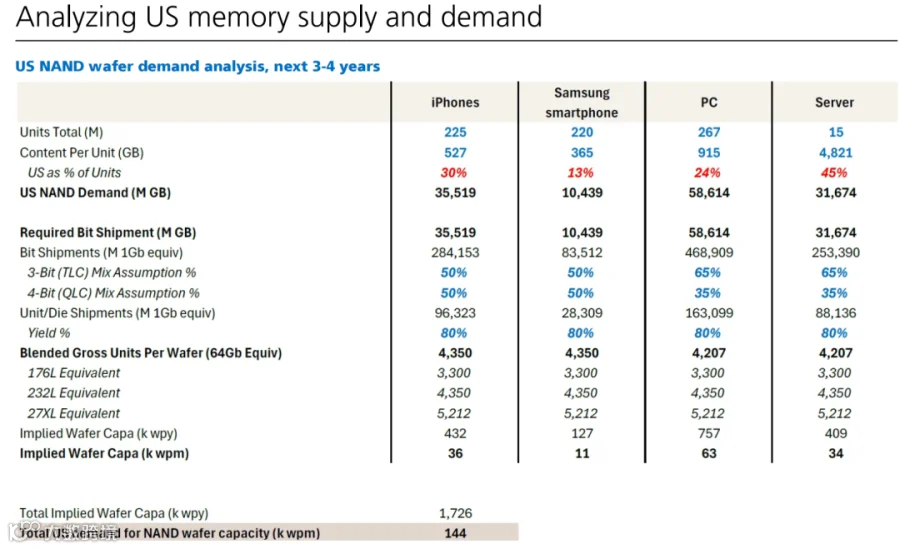
需求测算显示,美国未来 3-4 年可能需要 415kwpm 的 DRAM 产能和 144kwpm 的 NAND 产能。存储本地化的难度在于,它不仅需要晶圆产能,还涉及良率爬坡,并需在 HBM、服务器 DDR、手机及 PC 等不同应用场景间进行复杂的产能分配。
综上所述,“AI 需求强劲”在制造链具体体现为 N3/N2 晶圆、CoWoS、SoIC、CPO 测试、PMIC、成熟制程、硅片以及 DRAM/NAND 等多个环节的全面承压。这使得半导体供应链的紧缺更加分散,难以通过单一环节扩产解决。随着云端 AI 持续演进,追踪每一代服务器架构在功耗、Die 数量、封装面积、网络连接及存储容量上的变化,成为预判制造端瓶颈的关键。
【声明】内容源于网络
0
0
半导体产业报告
1234
内容 619
粉丝 1
半导体产业报告 1234
总阅读36.6k
粉丝1
内容619