


你有没有发现一件奇怪的事?
我们每天用的AI,ChatGPT也好,Claude也好,它们其实有一个共同的毛病:明明你只想要一个"是"或"否",它却给你写了三段话。
这就像你问收银员"这个多少钱",他非得念一首诗才肯告诉你价格。
这个问题,AI圈子里有人终于憋不住了,做出了完全不同的东西。于是,2026年9月,短短一周之内,先后出现了两个让技术圈炸锅的模型:Jev 和 Laya。
先说背景:为什么大家突然不满足于"能聊天"了?
过去几年,AI的军备竞赛只有一个方向:更大、更聪明、聊得更好。OpenAI有GPT,Anthropic有Claude,Google有Gemini……大家比的都是"谁能写出更好的文章,谁能解更难的数学题"。
但企业里的工程师们越来越发现,他们在实际开发中遇到最多的问题,根本不是"写文章"或"解数学",而是大量的判断和分类任务:
-
这封邮件应该转给哪个部门? -
这条评论是垃圾广告还是正常留言? -
这个用户有多大概率会退款? -
这个客服请求是紧急的还是可以等待的?
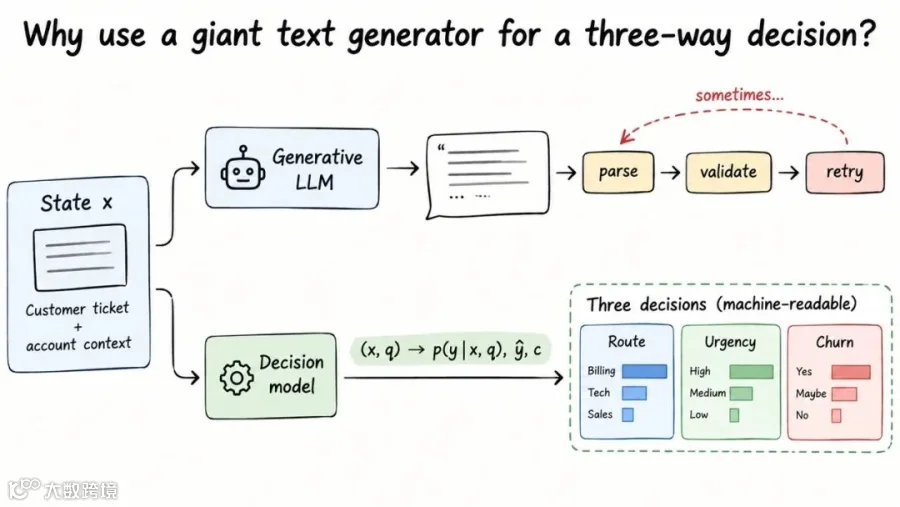
用大模型来做这些事,就像用航空母舰打苍蝇:又贵又慢,还经常打偏。
Jev:来自ChatGPT联合创始人的"反叛之作"
2026年9月15日,一家叫 TypeSafe AI 的公司突然宣布推出 Jev,创始人 Diogo Almeida 的履历相当吓人——他是 ChatGPT 的联合创始人,也是把"人类反馈强化学习(RLHF)"带进OpenAI的关键人物之一。
但他现在做的事,恰恰是要颠覆他当年亲手建立的那套逻辑。
Jev 被设计为一种全新类别的模型,叫做"System One Model"(系统一模型)。它不生成文字,而是接受结构化问题,直接返回带置信度的决策结果。
怎么理解?打个比方。
传统AI(比如ChatGPT)处理"这封邮件该给哪个部门"是这样的:
先读邮件 → 思考 → 生成一段文字 → "我认为这应该转给账单部门,因为……" → 你的系统再把这段话解析成代码能读的结果
而Jev是这样的:
读邮件 → 直接返回:{department: "billing", confidence: 0.94}
少了中间那一堆,速度和成本就直接断崖式下降。TypeSafe 对外公布的数据显示,Jev 的端到端响应时间在70到500毫秒之间,在同类判断任务上比一般大模型快40到200倍,成本降低40到400倍。
Jev 还演示了一个让人印象深刻的例子:它可以玩《Doom》这款经典射击游戏——你把游戏状态(玩家位置、生命值、周围有什么敌人)用结构化数据喂给它,它立刻返回下一步动作,比任何LLM都快得多。
但Jev有一个问题,而且不小
Jev 没有开源,没有公开技术论文,也没有开放权重下载。要用它,你得排队申请早期访问,按每百万输入token收费0.042美元,输出则声称"便宜到不计费"。
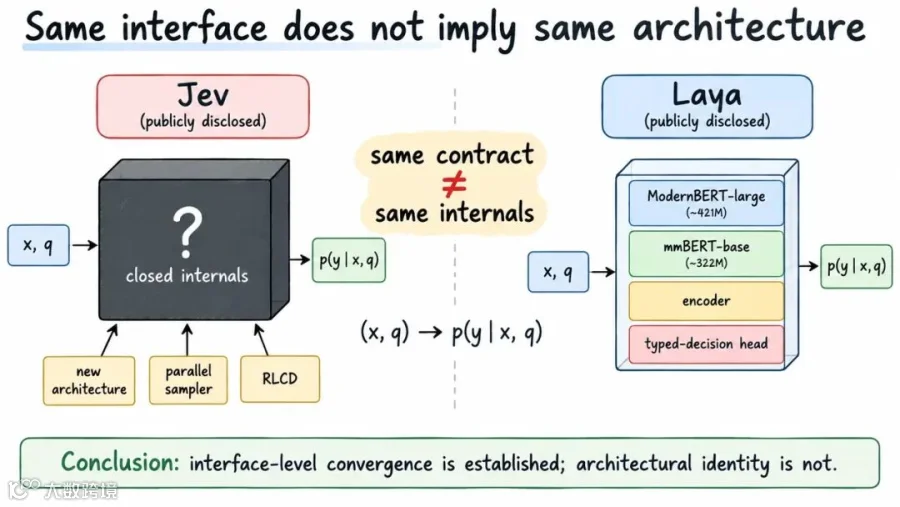
这让很多开发者心里不舒服:你说自己颠覆了AI界,但能不能让我先看看你的内脏?
就在大家等待、观望的时候,另一个玩家出现了。
Laya:3天后,开源界的"还击"
2026年9月19日,也就是Jev发布仅仅4天后,一家叫 Convai Innovations 的团队悄悄发布了 Laya。
没有发布会,没有新闻稿,就是把代码、模型权重、数据集全部扔到了Hugging Face上,标注:Apache 2.0开源协议,免费随便用。
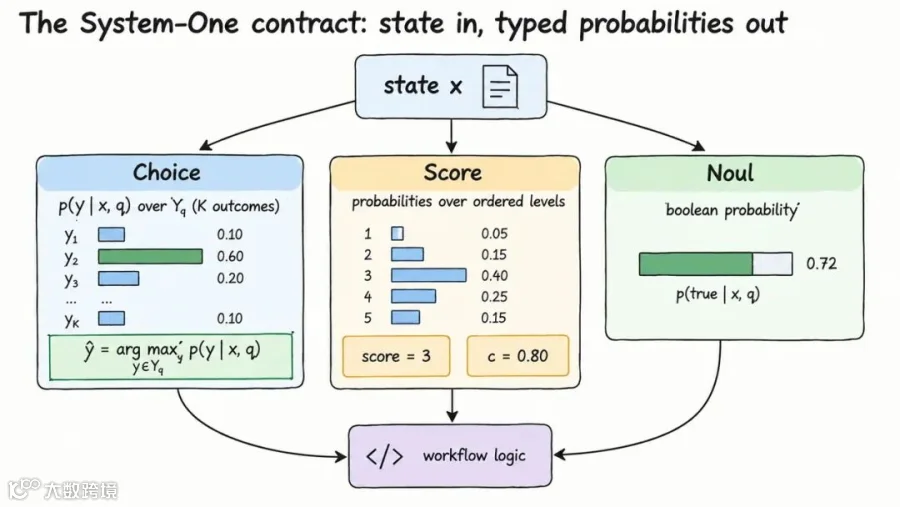
Laya 是一个非自回归的"System 1决策模型",专为结构化决策设计,不生成文字,而是接受状态(文本、邮件、工单或JSON),返回带概率的类型化答案,在特斯拉T4 GPU上单次问题的延迟约为33毫秒。
最关键的是,Laya 的创始人 Nandakishor Mukkunnoth 早在2025年3月就在学术论文(arXiv:2503.23303)里发表了这个想法——比Jev还早了整整一年半。
换句话说:大家发现Jev的想法,可能本来就是开源世界先做出来的。

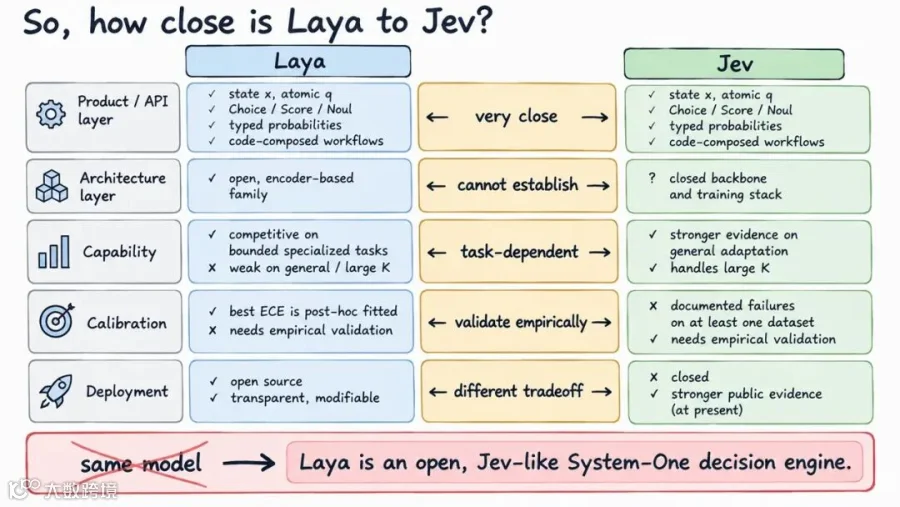
它们到底有什么区别?
如果你完全不懂技术,可以这样理解:
Jev 像一家高档快餐店——出餐速度快,质量有保证,但是要付钱,而且你不知道厨房里怎么做的。
Laya 像你自己买食材做饭——同样快,免费,食谱公开,但你得自己动手,而且新手可能做得不好吃(需要微调)。
核心相同点是:它们都不是"聊天AI",不生成文字;它们的使命是做判断、做分类、给出概率——专门给软件系统用的决策层。
一场"开放 vs 封闭"的暗战
这场竞争的有趣之处,不只是技术层面的。
一位独立研究者一年多前就用开源方式建出了这套框架、公开了权重、发表了论文,然后眼看着一个资金充裕的创业公司以封闭产品的形式发布了同样的核心想法。
Convai的回应是:把一切都开放出来,彻底的那种。
三个版本的模型权重、多语言支持、数据集、基准测试代码,一次性全部开源。而且性能数字还挺能打:
Laya 在单GPU上的响应时间是32.8毫秒,批量处理时可以压缩到7.2毫秒,比Jev快6到8倍。当然,这两家的测试条件不完全一样,需要打折来看。
但别急着下结论:Laya也不完美
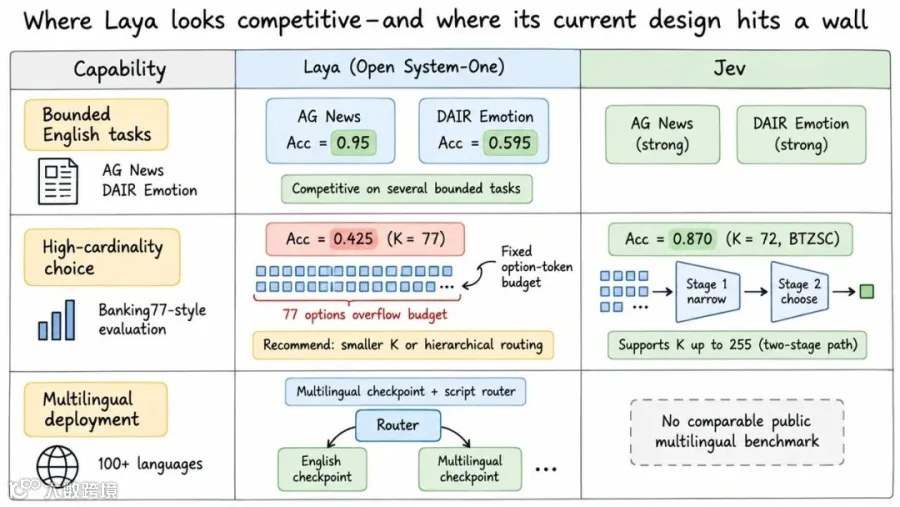
诚实说,Laya的模型卡对自己的局限性相当坦白:零样本(直接用,不做任何定制)的决策准确率只有0.362,比随机基线好不了多少,甚至不如"永远选最常见答案"的策略(0.461)。
那0.766的亮眼准确率是怎么来的?那是在专门的业务场景数据上进行微调(Fine-tuning)之后才达到的数字。
换句话说,你拿来就用可能效果一般,但你愿意针对自己的业务做定制,它就会变得相当强。这也是它和Jev最大的区别之一:Jev是即插即用的云服务,Laya是给你一块好原料让你自己加工。
此外,Laya的"选项"问题建议不要超过约20个选项;多语言版本在某些冷门语言上表现很差,比如高棉语的准确率是0,但置信度却高达95%——也就是说,它错得很自信。
为什么这两个模型值得普通人关注?
你可能会说:我又不写代码,跟我有什么关系?
其实关系很大。
你每次打客服电话被"智能分流"——背后可能是这类模型。
你的外卖平台判断你的退款申请是否属实——背后可能是这类模型。
你的银行App判断某笔交易是否可疑——背后可能是这类模型。
这些场景需要的不是"能聊天的AI",而是毫秒级、结构化、可靠的决策。这正是Jev和Laya在做的事。如果它们的方向被验证是正确的,未来大量企业背后跑的AI,将不再是GPT这样的大模型,而是更小、更快、更专门化的"决策引擎"。
技术细节:给想深入了解的人
Jev 是怎么工作的?
Jev 是非自回归的(non-autoregressive):它不是一个字一个字地生成答案,而是并行评估所有可能的决策选项,然后一次性返回结果和置信度。
训练方面,TypeSafe 使用了一种他们称之为 RLCD(Reinforcement Learning for Calibrated Decisions,面向校准决策的强化学习)的方法——目标不仅是让模型选对答案,还要让它对自己的信心度准确,80%的置信度就该对应80%的正确率,不能乱说。
概念上,Jev 的使用方式是这样的(伪代码):
给Jev提供:
- 状态(State):一段描述情况的文字或JSON
- 问题集(Questions):你希望回答的结构化问题
返回:
- 每个问题的答案 + 置信度分数
Laya 的架构
Laya 的底层是 ModernBERT-large 作为主干网络(backbone),在此基础上训练了一个专门的决策头(decision head),总参数量约421M。
Laya 支持三种问题类型:choice(从选项中选一个)、score(打分,有序尺度)、noul(某件事发生的概率是多少)。
三步上手 Laya:
多语言自动路由:
最后:这场竞争的真正意义
Jev 和 Laya 的出现,不只是"又来了两个新模型"那么简单。
它们指向一个更深层的问题:AI 的未来,到底是"一个超级大脑搞定一切",还是"一堆专门的小模型各司其职"?
大模型厂商赌的是前者;Jev 和 Laya 赌的是后者——至少在"需要做决策"这个场景里,专门化的小模型会赢。
而 Laya 和 Jev 之间的竞争,又是另一个老问题的回响:开放与封闭,到底哪个会改变世界?
历史上,Linux 赢了 Unix,Android 赢了塞班,Chrome 赢了 IE……
这一次,Laya 能赢吗?
答案还不确定。但故事,刚刚开始。