

在分布式架构、微服务调用以及高并发 API 网关的生产环境中,有这样一类非常经典的故障:
系统平时运行平稳,一旦业务迎来大促或流量洪峰,API 网关或后端服务就会开始突发性抖动。客户端抛出大量的 Cannot assign requested address(EADDRNOTAVAIL)报错;服务端 CPU 软中断(ksoftirqd)飙升,甚至在系统日志中打印出 nf_conntrack: table full, dropping packet。
运维工程师第一反应通常是:“是不是机器配置不够?加实例!”
然而加了机器后,问题不但没有缓解,反而因为更多节点对外发起调用,拖垮了后端的注册中心与上游服务。
这背后的根本死穴,往往不是业务计算逻辑有多重,而是系统陷入了短连接风暴(Short Connection Storm)。
在 TCP/IP 协议栈中,每次看似普通的网络请求,如果缺乏连接池化与复用机制,都会在底层触发沉重的握手、挥手、状态滞留与内核资源争抢。
本文将从操作系统网络栈底层出发,系统拆解频繁短连接对系统的破坏机理,深度剖析 TCP 连接复用池(Connection Pool)的设计与运行哲学,并给出 Linux 内核与常见基础设施的生产级调优全景指南。
一、为什么高并发系统最怕“每次请求建一条 TCP”?
要理解连接复用池的价值,首先需要透视一次“朴素”的 HTTP/RPC 调用在操作系统内核中所付出的真实代价。

短连接风暴 vs TCP 连接复用池架构时序对比
1. 握手与 TLS 协商的 RTT 延时黑洞
在标准的短连接模式下,每次应用层发起调用,都必须经历以下步骤:
TCP 三次握手:客户端发送
SYN,服务端返回SYN+ACK,客户端回送ACK。从客户端发出 SYN 到收到 SYN+ACK 完成握手需经历 1 个完整 RTT(往返时延)(服务端视角完成握手接收首包则经历 1.5 个 RTT);在此之前应用层无法发送任何有效业务数据。TLS 握手(HTTPS/mTLS):若包含传输加密,TLS 1.2 需要额外 2 个 RTT,TLS 1.3 即使优化也需要 1 个 RTT,且包含 RSA/ECDHE 非对称密钥协商的高昂 CPU 密集计算。
数据发送与响应:传输真正的应用层 Payload。
TCP 四次挥手:主动关闭方发送
FIN,经历完整的关闭序列释放连接。
假设同机房服务间网络 RTT 为 1ms,跨机房或混合云 RTT 为 20ms: 在短连接模式下,单次请求即便业务耗时只有 2ms,网络握手开销就占到了 20ms ~ 60ms。真正用来跑业务代码的时间,甚至不足网络往返开销的十分之一。
2. 四元组与临时端口耗尽(Port Exhaustion)
在 Linux 中,一条 TCP 连接由唯一的五元组确定:{源 IP, 源端口, 目的 IP, 目的端口, 协议}。
当微服务作为客户端调用固定的下游服务(固定目标 IP 和端口)时,五元组中的目标信息是恒定的。这意味着:客户端能够同时建立的连接总数,完全受限于本地可用的临时源端口(Ephemeral Ports)数量。
Linux 默认的临时端口分配范围由内核参数控制:
$ sysctl net.ipv4.ip_local_port_range
net.ipv4.ip_local_port_range = 32768 60999
默认可用端口仅有 60999 - 32768 + 1 = 28,232 个。
3. TIME_WAIT 状态的滞留与算术绝杀
许多工程师误以为:调用了 close(),端口就会立刻归还给系统。
事实恰恰相反。根据 TCP 状态机规范,主动发起关闭连接的一方(Active Closer),在完成四次挥手后必须进入 TIME_WAIT 状态,并强制滞留整整 2MSL(Maximum Segment Lifetime,Linux 下固定为 60 秒)。
我们来做一道残酷的算术题:
假设网关或客户端以短连接模式调用后端,吞吐量达到 10,000 QPS。
每一秒钟,产生 10,000 个主动关闭的连接。
每个连接在
TIME_WAIT状态停留 60 秒。在稳态下,系统中同时处于
TIME_WAIT的 Socket 数量将达到:
稳态 TIME_WAIT 积压公式:
10,000 QPS × 60 秒 = 600,000 个 Socket
而本地可分配的临时端口总数最多只有 64,512 个(即 1024 到 65535)。
在短连接高并发压迫下,不出 3 秒钟,本地端口就会被彻底耗尽。操作系统在 connect() 寻找空闲源端口时失败,直接抛出经典异常:
dial tcp 192.168.1.100:8080: connect: cannot assign requested address此时,CPU 使用率可能极低,内存也很宽裕,但整个系统的网络出向通道已经彻底瘫痪。
二、TCP 连接复用池:核心机制与设计哲学
解决短连接绝杀的根本方案,不是无限调大端口范围,而是引入 TCP 连接复用池(Connection Pooling)。
连接池的核心思想与线程池、数据库连接池一脉相承:将昂贵的资源常驻化,借用而不是反复创建,用完归还而不是销毁。
1. 连接池的核心生命周期模型
一个健壮的生产级 TCP 连接池,必须精准管理连接的四个生命阶段:
预热与初始化(Pre-warming):在系统启动或服务发现就绪后,预先与后端建立
MinIdle条长连接,规避首批请求因冷启动三次握手引发的延时尖刺(Cold-start Latency Spike)。借出与归还(Borrow & Return):
请求到达时,从空闲队列(Idle List)中借出一条已有连接,直接写入数据,实现 0 RTT 握手开销。
请求接收完毕后,连接被清洗(清空读缓冲区残留数据)并放回空闲队列,重置其空闲计时器。
并发上限与等待队列(MaxActive & WaitQueue):当所有连接都在使用且达到
MaxActive限制时,新请求进入阻塞队列等待归还,或者快速失败,防止过多连接挤爆后端。健康保活与淘汰收缩(Eviction & Health Check):后台常驻定时巡检协程/线程,针对空闲时长超过
IdleTimeout或存活总时长超过MaxLifetime的连接进行优雅关闭,动态收缩连接池规模。
2. 队列策略的选择:LIFO vs FIFO
连接池在管理空闲连接时,通常有两种容器设计哲学:
LIFO(后进先出 / 栈模型):
优先复用“刚刚被归还”的连接。
优势:使得少数热点连接始终保持高度活跃,充分利用 CPU 缓存与网卡 TCP 拥塞窗口(CWND 不容易缩回初始值);冷连接则长时间闲置,便于巡检线程集中淘汰,节省资源。
代表:Go 语言
net/http连接池底层采用基于 LIFO 的空闲列表。FIFO(先进先出 / 队列模型):
请求轮流复用池中的每条连接。
优势:流量均匀分摊在所有 TCP 链路上,防止单条连接积攒过大吞吐导致队列倾斜。
代表:大部分数据库连接池(如 HikariCP)及部分 RPC 框架。
3. 连接池的三大生产致命陷阱
引入连接池并非一劳永逸,如果配置不当,会引入新的隐蔽故障:
陷阱一:防火墙/NAT 网关的“静默杀连接”(Silent Drop)
云厂商的 NAT 网关、AWS NLB、SLB 或硬件防火墙,对空闲 TCP 会话都有超时限制(通常为 60s ~ 300s)。 如果连接池里的长连接空闲超过了这个阈值,中间网关会直接将该会话从状态表中抹去,但既不会给客户端发 FIN,也不会给服务端发 RST。
当客户端连接池以为该连接依然可用并再次拿出来发数据时,中间网关直接丢弃数据包或返回 RST,客户端随即爆出:
read: connection reset by peer
# 或者
broken pipe解法:连接池的 IdleTimeout 必须严格小于中间网络设备与服务端的超时阈值(例如网关设 60s,客户端连接池的空闲超时就必须设在 30s ~ 45s 以内);同时在应用层或传输层开启定期探活心跳。
陷阱二:DNS 漂移与长连接僵死
在微服务与 Kubernetes 环境中,后端 Pod 经常发生销毁与重启,IP 发生变动。 如果客户端连接池与某个旧 Pod 的 IP 建立了长连接,且设置了永不超时的 MaxLifetime,客户端将永远把流量发送到旧节点或已经处于摘流状态的机器。
解法:连接池必须显式配置 MaxConnLifetime(例如 5 ~ 15 分钟),强制老连接在达到寿命后平滑重建,触发新的 DNS 解析。
陷阱三:响应 Body 未读完导致连接无法复用(Leak)
以 Go 语言为例,许多初学者写出的代码存在严重连接泄露:
resp, err := client.Get("http://api.service/query")
if err != nil {
    return err
}
// ❌ 错误:虽然 defer 关闭了 Body,但没有读完内容,或者忘记关闭
defer resp.Body.Close()
在 HTTP/1.1 Keep-Alive 规范中,只有当上一次响应的 Body 被完整读取完毕后,底层 TCP Socket 才能被安全放回连接池。如果只读了一半就关闭,或者遗漏了关闭,底层连接无法被下一次请求复用,直接沦落为短连接被强行关闭,重蹈覆辙。
三、破除误区:应用层复用 vs 内核层复用
很多开发者在查阅文档时,经常把应用层的“连接池”、HTTP 协议的“Keep-Alive”以及 Linux 内核的 SO_REUSEPORT、tcp_tw_reuse 混为一谈。我们必须在概念层面厘清它们的本质边界。
|
|
|
|
|
|
|
|---|---|---|---|
| 应用层长连接 |
Connection: keep-alive
|
|
|
| 应用层多路复用 |
|
|
|
| 应用层连接池 |
http.Transport、Java Apache HttpClient
|
|
|
| 内核套接字端口共享 | SO_REUSEADDR
SO_REUSEPORT
|
|
|
| 内核 TIME_WAIT 复用 | net.ipv4.tcp_tw_reuse = 1 |
|
|
注意核心差异:
HTTP/1.1 Keep-Alive 和 连接池 是为了避免 TCP 连接被销毁,从源头消灭三次握手与四次挥手。
tcp_tw_reuse则是连接已经被应用层关闭、已经掉入TIME_WAIT深渊后的内核补救手段。
四、深入内核:TCP 状态机与关键参数防线
当应用层连接池由于流量浪涌或配置失误,仍然产生了一定规模的连接关闭时,系统的最后一道防线就是 Linux 内核网络栈。
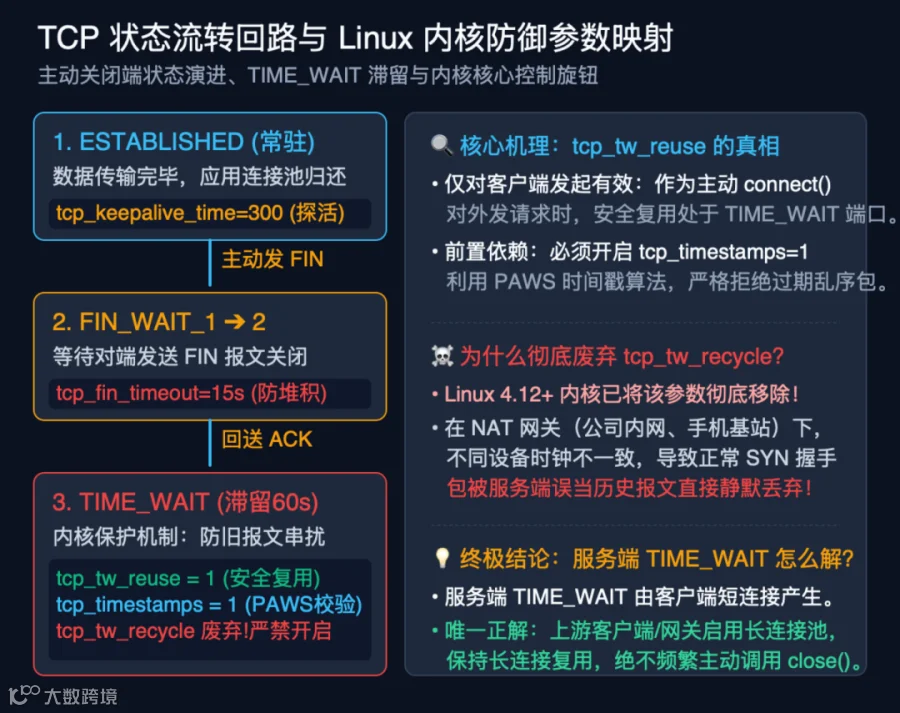
TCP 状态流转回路与 Linux 内核防御参数映射
1. tcp_tw_reuse 与时间戳的救赎(PAWS 机制)
在 /proc/sys/net/ipv4/ 下,有两个经常被提及的参数:tcp_tw_reuse 和 tcp_timestamps。
net.ipv4.tcp_tw_reuse = 1
net.ipv4.tcp_timestamps = 1
工作机理
当客户端调用 connect() 分配临时端口时,如果发现某个本地端口对应的四元组处于 TIME_WAIT 状态,并且满足以下条件:
net.ipv4.tcp_tw_reuse = 1。开启了
net.ipv4.tcp_timestamps = 1(RFC 7323 标准)。当前时间戳严格大于该连接上一次记录的时间戳(时间过去超过 1 秒)。
内核就会直接将这个处于 TIME_WAIT 的 Socket “借”出来,直接发起新的 SYN 请求。
这背后的安全基石是 PAWS(Protection Against Wrapped Sequence Numbers,防止序列号回绕算法):通过在 TCP 头部携带严格单调递增的时间戳,即便网络中残留了上一个历史连接的乱序旧报文,新连接收到后也会根据时间戳过期判定直接丢弃,杜绝了数据串包。
边界澄清:
tcp_tw_reuse仅对客户端主动向外发起connect()时有效!对于作为服务端监听 80/443 端口收到的入向连接,tcp_tw_reuse完全不起任何作用。服务端的大量TIME_WAIT只能由上游客户端启用长连接池来解决。
2. 为什么 Linux 4.12+ 彻底废弃了 tcp_tw_recycle?
在早期的网络调优博客中,经常能看到推荐将 tcp_tw_recycle = 1 开启的配置。在现代 Linux 系统中,这是绝对的灾难性配置!
原理:
tcp_tw_recycle开启后,内核不仅对客户端复用,还会对服务端的TIME_WAIT进行极其激进的快速回收(将 60 秒缩短到 RTO 级别,数百毫秒内强制回收),并对每个 IP 记录最后一次握手的时间戳。致命陷阱:在当代互联网架构中,客户端几乎普遍位于 NAT 网关(例如企业办公室出口网关、家用路由器、移动蜂窝基站)或四层负载均衡器之后。多个不同设备共享同一个出口公网 IP,但它们各自本机的系统时钟不可能绝对一致。当用户 A 带着时间戳
T=100发起握手后,紧接着用户 B 带着自己机器的时钟T=90发起连接。服务端的tcp_tw_recycle发现同一个公网 IP 的时间戳发生了倒流(90 < 100),立即判定该报文为历史异常报文,直接静默丢弃 SYN,不作任何响应!后果:整个企业内网或某个片区的大量用户出现间歇性“网站打不开、加载无限转圈、接口超时”。
由于这一机制天然与 NAT 网络冲突,Linux 内核维护者在 Linux 4.12 版本中彻底删除了 tcp_tw_recycle 参数(对应 Commit: 4396e46187ca)。任何仍然建议配置 tcp_tw_recycle=1 的文章都可以直接判定为过时误导。
3. 半连接队列与全连接队列(Backlog 链条)
当连接池并发初始化或突发流量涌入服务端时,服务端的握手队列首当其冲:
半连接队列(SYN Queue):存放收到
SYN但尚未收到第三次握手ACK的连接。大小受net.ipv4.tcp_max_syn_backlog控制。全连接队列(Accept Queue):完成三次握手但尚未被应用程序
accept()消费的连接。大小取决于min(backlog, net.core.somaxconn)。
如果服务端处理变慢或全连接队列设得太小(很多老环境 somaxconn 默认只有 128),队列一旦被塞满:
内核默认行为由
net.ipv4.tcp_abort_on_overflow决定:0(默认推荐):丢弃第三次握手的 ACK 报文,让客户端超时重传 SYN+ACK,起到拥塞缓冲退避作用。1:直接向客户端发送RST报文,导致客户端瞬间收到Connection reset by peer。
五、高并发生产环境:Linux 内核网络参数调优矩阵
围绕连接复用、端口容量扩充、队列抗压以及网络连接跟踪(Conntrack),生产环境推荐的核心配置矩阵如下:

高并发网络调优:Linux 内核核心参数配置全景
1. /etc/sysctl.conf 生产级基线配置清单
# ====================================================================
# 1. 临时端口范围扩容:释放 64512 个可用端口
# ====================================================================
net.ipv4.ip_local_port_range = 1024 65535

# ====================================================================
# 2. TIME_WAIT 状态安全复用与快速回收
# ====================================================================
# 开启主动 outgoing 连接对 TIME_WAIT 套接字的安全复用
net.ipv4.tcp_tw_reuse = 1
# 必须启用 RFC 7323 时间戳作为 PAWS 校验基础
net.ipv4.tcp_timestamps = 1
# 缩短 FIN_WAIT_2 孤儿连接超时时间(默认 60s 降至 15s)
net.ipv4.tcp_fin_timeout = 15
# 系统持有的最大 TIME_WAIT 数量上限,防止内存被无节制消耗
net.ipv4.tcp_max_tw_buckets = 65536

# ====================================================================
# 3. 监听队列扩容:消除流量洪峰下的 SYN/Accept 溢出
# ====================================================================
# 系统级 socket listen() 全连接队列软上限(应用代码中 backlog 必须同步增大)
net.core.somaxconn = 8192
# 半连接(SYN 积压)队列容量
net.ipv4.tcp_max_syn_backlog = 16384
# 网卡接收队列溢出保护(NIC backlog)
net.core.netdev_max_backlog = 16384
# 全连接队列满时丢弃 ACK 触发客户端退避重试,不直接发 RST 摧毁会话
net.ipv4.tcp_abort_on_overflow = 0

# ====================================================================
# 4. TCP 传输层 Keepalive 保活检测(快速感知僵尸连接)
# ====================================================================
# TCP 链路空闲 300 秒后启动保活探测报文(默认 7200s 太慢)
net.ipv4.tcp_keepalive_time = 300
# 探测报文无应答时,每隔 15 秒重新发送探测
net.ipv4.tcp_keepalive_intvl = 15
# 连续 5 次探测无响应则强制判定链路已断开,释放资源
net.ipv4.tcp_keepalive_probes = 5

# ====================================================================
# 5. Netfilter 连接跟踪表(NAT / 网关节点必备,防丢包崩溃)
# ====================================================================
net.netfilter.nf_conntrack_max = 1048576
net.netfilter.nf_conntrack_tcp_timeout_established = 600
net.netfilter.nf_conntrack_tcp_timeout_time_wait = 30
配置生效命令:
sudo sysctl -p六、生产基础设施落地与代码实战
仅有内核参数无法杜绝短连接,必须在反向代理(Nginx/Envoy)与应用程序客户端中正确开启连接池。
1. Nginx 反向代理的上游连接池配置
Nginx 默认在向 upstream 转发请求时,使用的是 HTTP/1.0 且默认带有 Connection: close 请求头!这是许多团队搭建 Nginx 反向代理时最容易踩中短连接风暴的雷区。
正确的生产配置必须显式声明 keepalive 指令与 HTTP/1.1:
http {
    upstream backend_services {
        server 10.0.0.10:8080 max_fails=3 fail_timeout=10s;
        server 10.0.0.11:8080 max_fails=3 fail_timeout=10s;

        # 【核心 1】每个 worker 进程保留的空闲长连接最大数量
        keepalive 256;
        # 【核心 2】单条连接最大复用请求数,达到后优雅关闭防内存泄露
        keepalive_requests 10000;
        # 【核心 3】连接最大空闲存活时长
        keepalive_timeout 60s;
    }

    server {
        listen 80;

        location /api/ {
            proxy_pass http://backend_services;

            # 【核心 4】强制将与上游的协议升级为 HTTP/1.1(默认为 1.0)
            proxy_http_version 1.1;

            # 【核心 5】清空客户端传来的 Connection 头,启用长连接复用
            proxy_set_header Connection "";

            proxy_set_header Host $host;
            proxy_set_header X-Real-IP $remote_addr;
        }
    }
}踩坑警示:如果不加
proxy_set_header Connection "",下游客户端传入的Connection: close会直接透传给后端,导致 Nginx 与上游的连接池彻底失效,每笔请求依然是短连接!
2. Go 语言高并发客户端连接池标准姿势
Go 语言标准库的 http.Client 内置了高性能的连接池,但默认参数极其保守,必须进行生产重构:
package main

import (
    "context"
    "io"
    "net"
    "net/http"
    "time"
)

func NewProductionHTTPClient() *http.Client {
    transport := &http.Transport{
        // 【1】拨号超时与 TCP 层面 Keepalive
        DialContext: (&net.Dialer{
            Timeout:   3 * time.Second,  // 建连超时
            KeepAlive: 30 * time.Second, // 内核层 TCP Keepalive 探测间隔
        }).DialContext,

        // 【2】关键连接池配额
        MaxIdleConns:        1000,             // 全局最大空闲连接总数
        MaxIdleConnsPerHost: 100,              // 单个目标 Host 最大空闲连接(默认只有 2,必调!)
        MaxConnsPerHost:     500,              // 单个 Host 最大总连接数,防止流量过载挤爆对端
        IdleConnTimeout:     60 * time.Second, // 空闲连接保活超时,必须小于中间网关超时

        // 【3】传输层超时控制
        ResponseHeaderTimeout: 5 * time.Second,  // 等待首包响应头超时
        TLSHandshakeTimeout:   3 * time.Second,  // TLS 握手超时
        ExpectContinueTimeout: 1 * time.Second,
        DisableKeepAlives:     false,            // 绝不能设为 true,否则禁用连接池
    }

    return &http.Client{
        Transport: transport,
        Timeout:   10 * time.Second, // 包含从建连、发送到接收全部完成的端到端硬超时
    }
}

func ExecuteRequest(client *http.Client, url string) error {
    req, err := http.NewRequestWithContext(context.Background(), http.MethodGet, url, nil)
    if err != nil {
        return err
    }

    resp, err := client.Do(req)
    if err != nil {
        return err
    }
    // 【核心安全准则】
    // 1. 无论业务是否需要数据,必须彻底读完 Body,确保连接可以被复用
    defer func() {
        _, _ = io.Copy(io.Discard, resp.Body)
        _ = resp.Body.Close()
    }()

    // 业务逻辑处理...
    return nil
}
七、生产排查与诊断工具箱
当线上遇到连接异常时,熟练运用 Linux 原生命令行工具能让你在秒级定位根因:
1. 快速检查全机 TCP 状态分布
# 查看全局 Socket 概要
$ ss -s
Total: 1250
TCP:   1120 (estab 850, closed 20, orphaned 0, timewait 250)

# 精确统计当前各 TCP 状态计数
$ ss -ant | awk '{print $1}' | sort | uniq -c | sort -nr
    850 ESTAB
    250 TIME-WAIT
     12 CLOSE-WAIT
      8 LISTEN
2. 检查全连接队列(Listen Backlog)是否溢出
# 查看处于 LISTEN 状态的 Socket,Send-Q 代表全连接队列容量,Recv-Q 代表当前积压待 accept 数量
$ ss -lnt
State      Recv-Q Send-Q Local Address:Port Peer Address:Port
LISTEN     0      4096       0.0.0.0:8080      0.0.0.0:*

# 查看全连接队列丢包累计计数(非 0 说明队列曾被塞爆)
$ netstat -s | grep -E "overflowed|times the listen queue of a socket"
    1240 times the listen queue of a socket overflowed
    3521 SYNs to LISTEN sockets dropped
3. 排查 Netfilter 连接跟踪表状态
# 查看当前连接跟踪表已使用条目数
$ cat /proc/sys/net/netfilter/nf_conntrack_count
895200

# 查看上限阈值
$ cat /proc/sys/net/netfilter/nf_conntrack_max
1048576

# 查看系统日志中是否曾出现丢包告警
$ sudo dmesg -T | grep -i "nf_conntrack"
[Sun Sep 27 15:20:11 2026] nf_conntrack: table full, dropping packet
八、总结与架构思考
高并发系统的网络架构演进,本质上是对系统资源的精细化管控:
从架构理念上看:短连接是单体与脚本时代的思维惯性,连接池化与长连接复用才是云原生与微服务高吞吐的基石。消灭了非必要的三次握手与四次挥手,系统的网络延时与 CPU 软中断开销至少能降低一个数量级。
从内核防御上看:Linux 内核提供了
tcp_tw_reuse与扩大临时端口范围等安全旋钮,但它们是面对不可控流量冲击时的兜底防线,绝不能作为放任应用层不搞连接池的借口。从全链路协同上看:微服务网关、业务客户端与后端中间件必须共同协同其长连接生命周期(
IdleTimeout梯级递减,MaxLifetime防止 DNS 滞后),才能真正构建起坚不可摧的高并发网络通信体系。